Riassunto:
Microsoft ha annunciato i risultati dell'indagine preliminare sull'interruzione diffusa di Microsoft 365 dal 12 al 13 novembre, affermando che l'errore è stato causato da un difetto del server Windows rimasto inattivo per diversi mesi, dallo scambio del traffico di Teams e da una riduzione della capacità disponibile del gateway. L'incidente è durato dalle 16:20 UTC del 12 novembre alle 16:10 UTC del giorno successivo, quasi 24 ore.
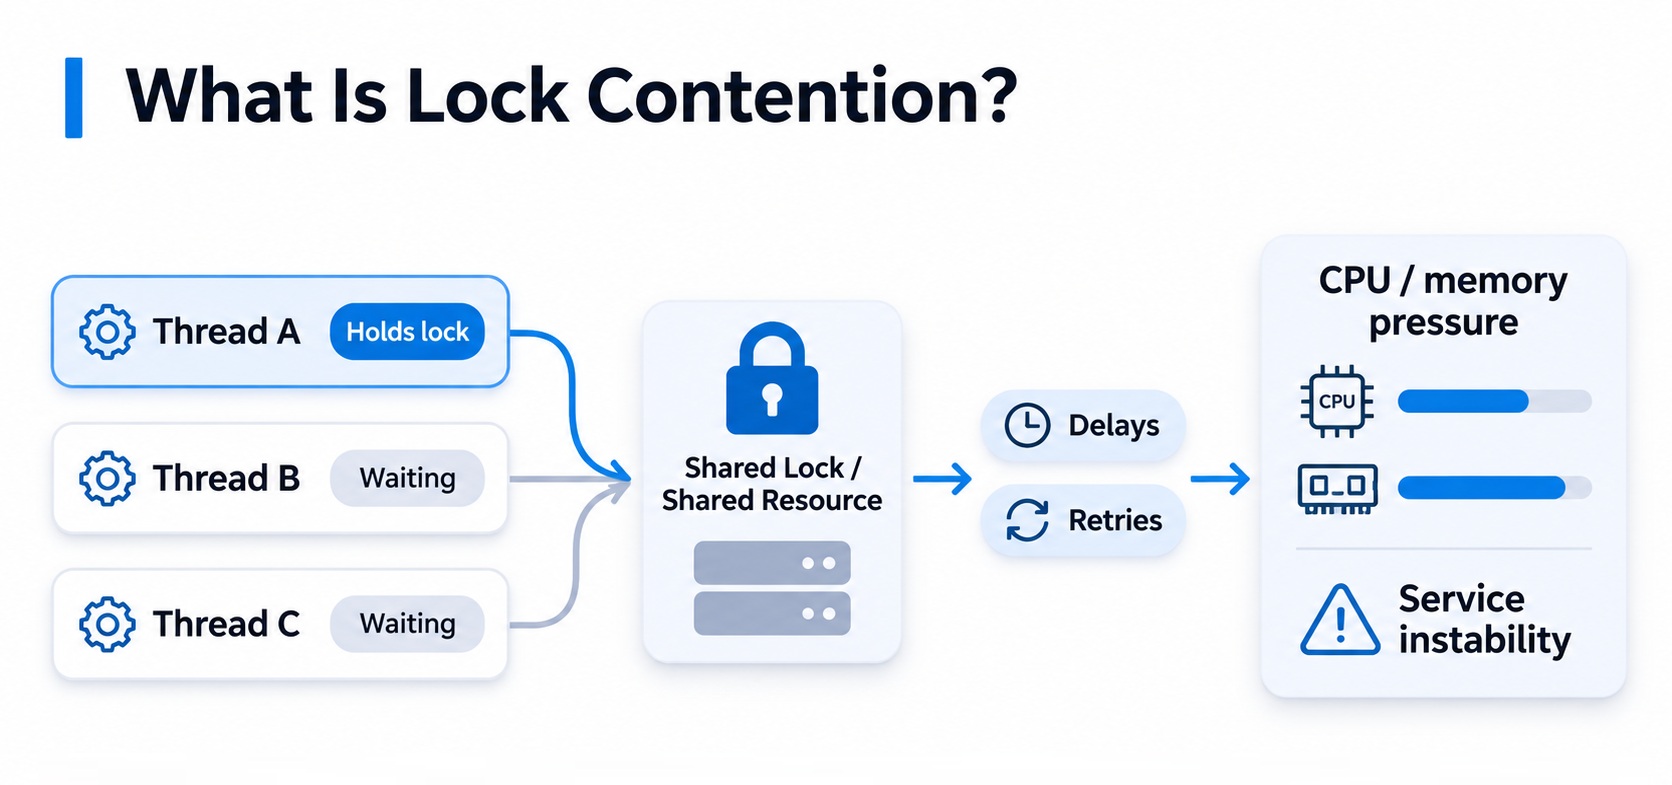
Microsoft ha affermato che il difetto ha avuto origine da una correzione distribuita per Microsoft 365 Network Gateway Server nel luglio di quest'anno. Sotto un carico specifico, si verifica una competizione di blocco nei processi interni di Windows e le risorse di memoria e CPU del server vengono gradualmente esaurite e alla fine smettono di rispondere. In precedenza il problema non era stato rilevato, in parte perché l'ambiente di test di Microsoft utilizzava hardware con meno core; dall'indagine è emerso che era più probabile che il conflitto di blocco si intensificasse sui server più recenti con più core. Microsoft ha sottolineato che questo difetto e le relative correzioni coinvolgono solo l’infrastruttura gateway di Microsoft 365 e non influiscono su altre distribuzioni di Windows.
Circa 15 ore prima dell'errore, il traffico di Teams è passato dal gateway di rete di backup al gateway primario condiviso con Exchange Online, modificando i modelli di traffico e aumentando il carico; allo stesso tempo, circa il 14% della capacità del server del gateway era temporaneamente non disponibile a causa di un altro problema verificatosi il giorno precedente. Microsoft ha affermato che questi due fattori da soli non hanno avuto alcun impatto, ma se combinati con difetti latenti, hanno innescato un sovraccarico del server.
Dopo che il server perde la risposta, il sistema di gestione del traffico trasferisce la richiesta ad altri nodi normali, il che mette sotto maggiore pressione i server rimanenti e l'errore si diffonde uno per uno. In meno di due ore, oltre l'80% dei server gateway non ha risposto; le misure protettive originariamente utilizzate per isolare le faglie in diverse regioni non sono riuscite a impedire che il problema si diffondesse a livello regionale. Microsoft ha affermato che l'incidente più grave durante l'incidente è stato Exchange Online, dove molti utenti non sono stati in grado di accedere alle proprie caselle di posta o di inviare e ricevere e-mail normalmente; Anche i servizi che si basavano su funzioni di Exchange come Teams, Copilot, SharePoint e OneDrive sono stati interessati a vari livelli e le funzioni di chat e conferenza di alcuni servizi potevano ancora essere utilizzate.
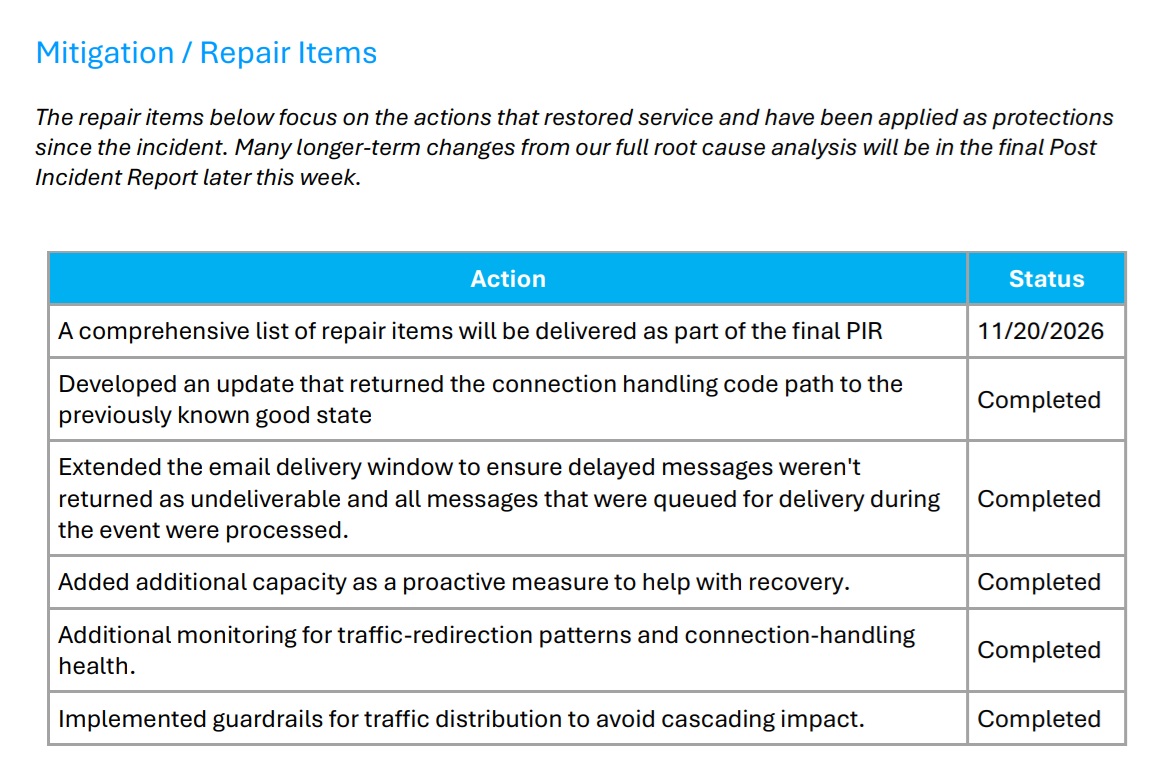
Il processo di ripristino è stato prolungato perché il server riavviato poteva smettere di rispondere non appena riceveva il traffico in backlog e poiché il difetto era stato implementato mesi fa, i rollback regolari e le attivazioni delle funzionalità non potevano essere annullati rapidamente. Alla fine gli ingegneri hanno ripristinato il codice di elaborazione della connessione alla versione stabile precedente, quindi lo hanno riparato in batch, hanno riavviato il server e hanno gradualmente ripristinato il traffico. Microsoft ha dichiarato che i servizi di webmail globali sono stati ripristinati ai livelli previsti alle 14:17 del 13 novembre, e alle 16:10 di quel giorno è stato confermato che gli utenti non erano più direttamente colpiti dall'incidente; le e-mail ritardate sono state successivamente elaborate.
Microsoft ha aumentato la capacità e il monitoraggio dei server, ha aggiunto misure di protezione della distribuzione del traffico e ha esteso i tempi di attesa per il recapito della posta per evitare che la posta in ritardo venga erroneamente interpretata come un errore di recapito. La società ha affermato che al momento non vi è alcuna indicazione che l’incidente abbia coinvolto attività dannose o agenti di intelligenza artificiale e prevede di pubblicare un rapporto finale post-evento prima del 20 novembre per integrare le misure correttive a lungo termine.
Commenti