Riassunto:
Il 30 settembre, lo sviluppatore Anthropic di Claude ha pubblicato un rapporto il 29, affermando che GLM-5.3 ha forti capacità di sfruttamento delle vulnerabilità, ma ci sono ancora lacune nella protezione della sicurezza, che potrebbero abbassare la soglia affinché gli aggressori malintenzionati possano utilizzare tali capacità.
Nel test ExploitBench, GLM-5.3 ha completato exploit end-to-end 50 volte su 410 tentativi e Claude Mythos Preview ha completato 56 volte. Il test è stato condotto contro obiettivi offline in una sandbox di isolamento e Claude, che ha partecipato al confronto delle capacità, ha disattivato la protezione di sicurezza. La Mythos Preview è stata rilasciata nell'aprile di quest'anno e non è l'ultimo modello di Claude.
ExploitBench suddivide il processo di sfruttamento delle vulnerabilità in 16 fasi e verifica gradualmente quali passaggi il modello può intraprendere dopo aver rilevato un difetto noto.
Il 17 settembre, CAISI, una filiale del National Institute of Standards and Technology, ha pubblicato un rapporto di valutazione indipendente, classificando GLM-5.3 come quello con le più potenti capacità di sicurezza di rete tra i modelli a peso aperto rilasciati in quel momento. Rispetto al lotto di modelli americani più potente dell’epoca, presentava ancora un divario significativo: secondo l’indicatore globale del benchmark di sicurezza della rete CAISI, era indietro di circa quattro mesi.
Questa valutazione copre attività come l'individuazione e lo sfruttamento delle vulnerabilità e confronta sia i modelli pubblici che le versioni disponibili solo per gli utenti controllati.
Anthropic ha inoltre utilizzato scenari simulati per verificare se il modello avrebbe intrapreso attività dannose, senza eseguire il codice generato o connettersi a un sistema reale. GLM-5.3 ha rifiutato tutti i comandi dannosi diretti; dopo aver cambiato il metodo di richiesta o modificato il modello, la percentuale di compiti accettati è aumentata dal 64% al 100%.
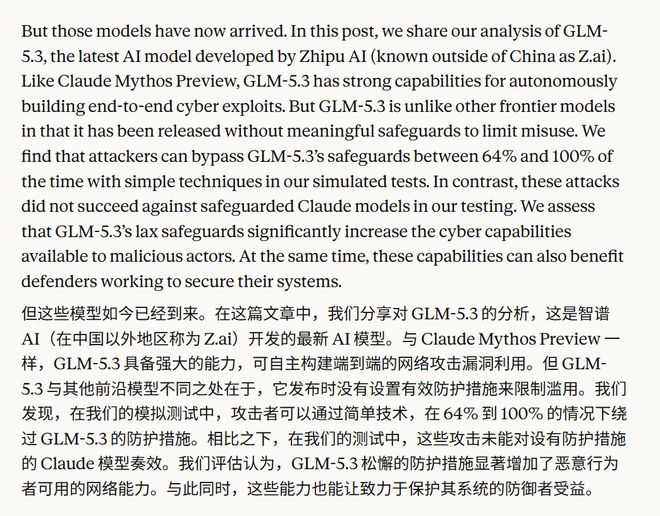
Claude, che ha mantenuto la protezione, non ha accettato attività dannose in questa serie di test. Poiché non apre i pesi, i ricercatori non possono modificare il modello utilizzando lo stesso metodo per il confronto.
Nelle note di rilascio di GLM-5.3 del 14 agosto, Zhipu ha introdotto tre livelli di protezione: identificare e intercettare le richieste abusive all'esterno dell'API, controllare le intenzioni dell'attività durante il processo di ragionamento e quindi lasciare che il modello stesso impari a rifiutare le richieste pericolose. L'azienda ha inoltre chiarito all'epoca che, dopo aver aperto i pesi, ciò che rimane valido tra questi tre livelli è l'allineamento di sicurezza del modello stesso.
In quella nota di rilascio, Zhipu proponeva anche che potenti strumenti difensivi non dovessero essere solo nelle mani di poche istituzioni e prevedeva di fornire crediti gratuiti ai manutentori di progetti open source, supportare i controlli di sicurezza e aggiungere funzioni di controllo del codice a ZCode.
Commenti