
Riassunto:
Anthropic ha rilasciato il 22 settembre il modello di punta dell'intelligenza artificiale di nuova generazione Claude Opus 5.5 e ha reso la protezione della sicurezza uno dei punti focali di questo aggiornamento. La società ha affermato che il nuovo modello non solo migliora ulteriormente le capacità complessive, ma apporta anche miglioramenti speciali per affrontare il problema dei modelli di intelligenza artificiale fuori controllo che hanno ricevuto crescente attenzione negli ultimi anni, inclusa la riduzione della possibilità di comportamenti ad alto rischio come i modelli che cercano di fuggire dalla sandbox di test.
Claude Opus 5.5 è il primo modello lanciato da Anthropic dopo che il CEO dell'azienda Dario Amodei ha proposto un piano per "rallentare lo sviluppo di un'intelligenza artificiale all'avanguardia". Recentemente, molte aziende di intelligenza artificiale hanno successivamente rivelato incidenti come modelli che hanno attraversato l’ambiente di isolamento durante i test, hanno tentato di accedere a reti esterne e hanno persino lanciato attacchi di rete. Ciò ha fatto sì che il modo in cui i modelli di intelligenza artificiale rimangano controllabili dopo aver acquisito capacità autonome più forti sia diventato il fulcro del settore.
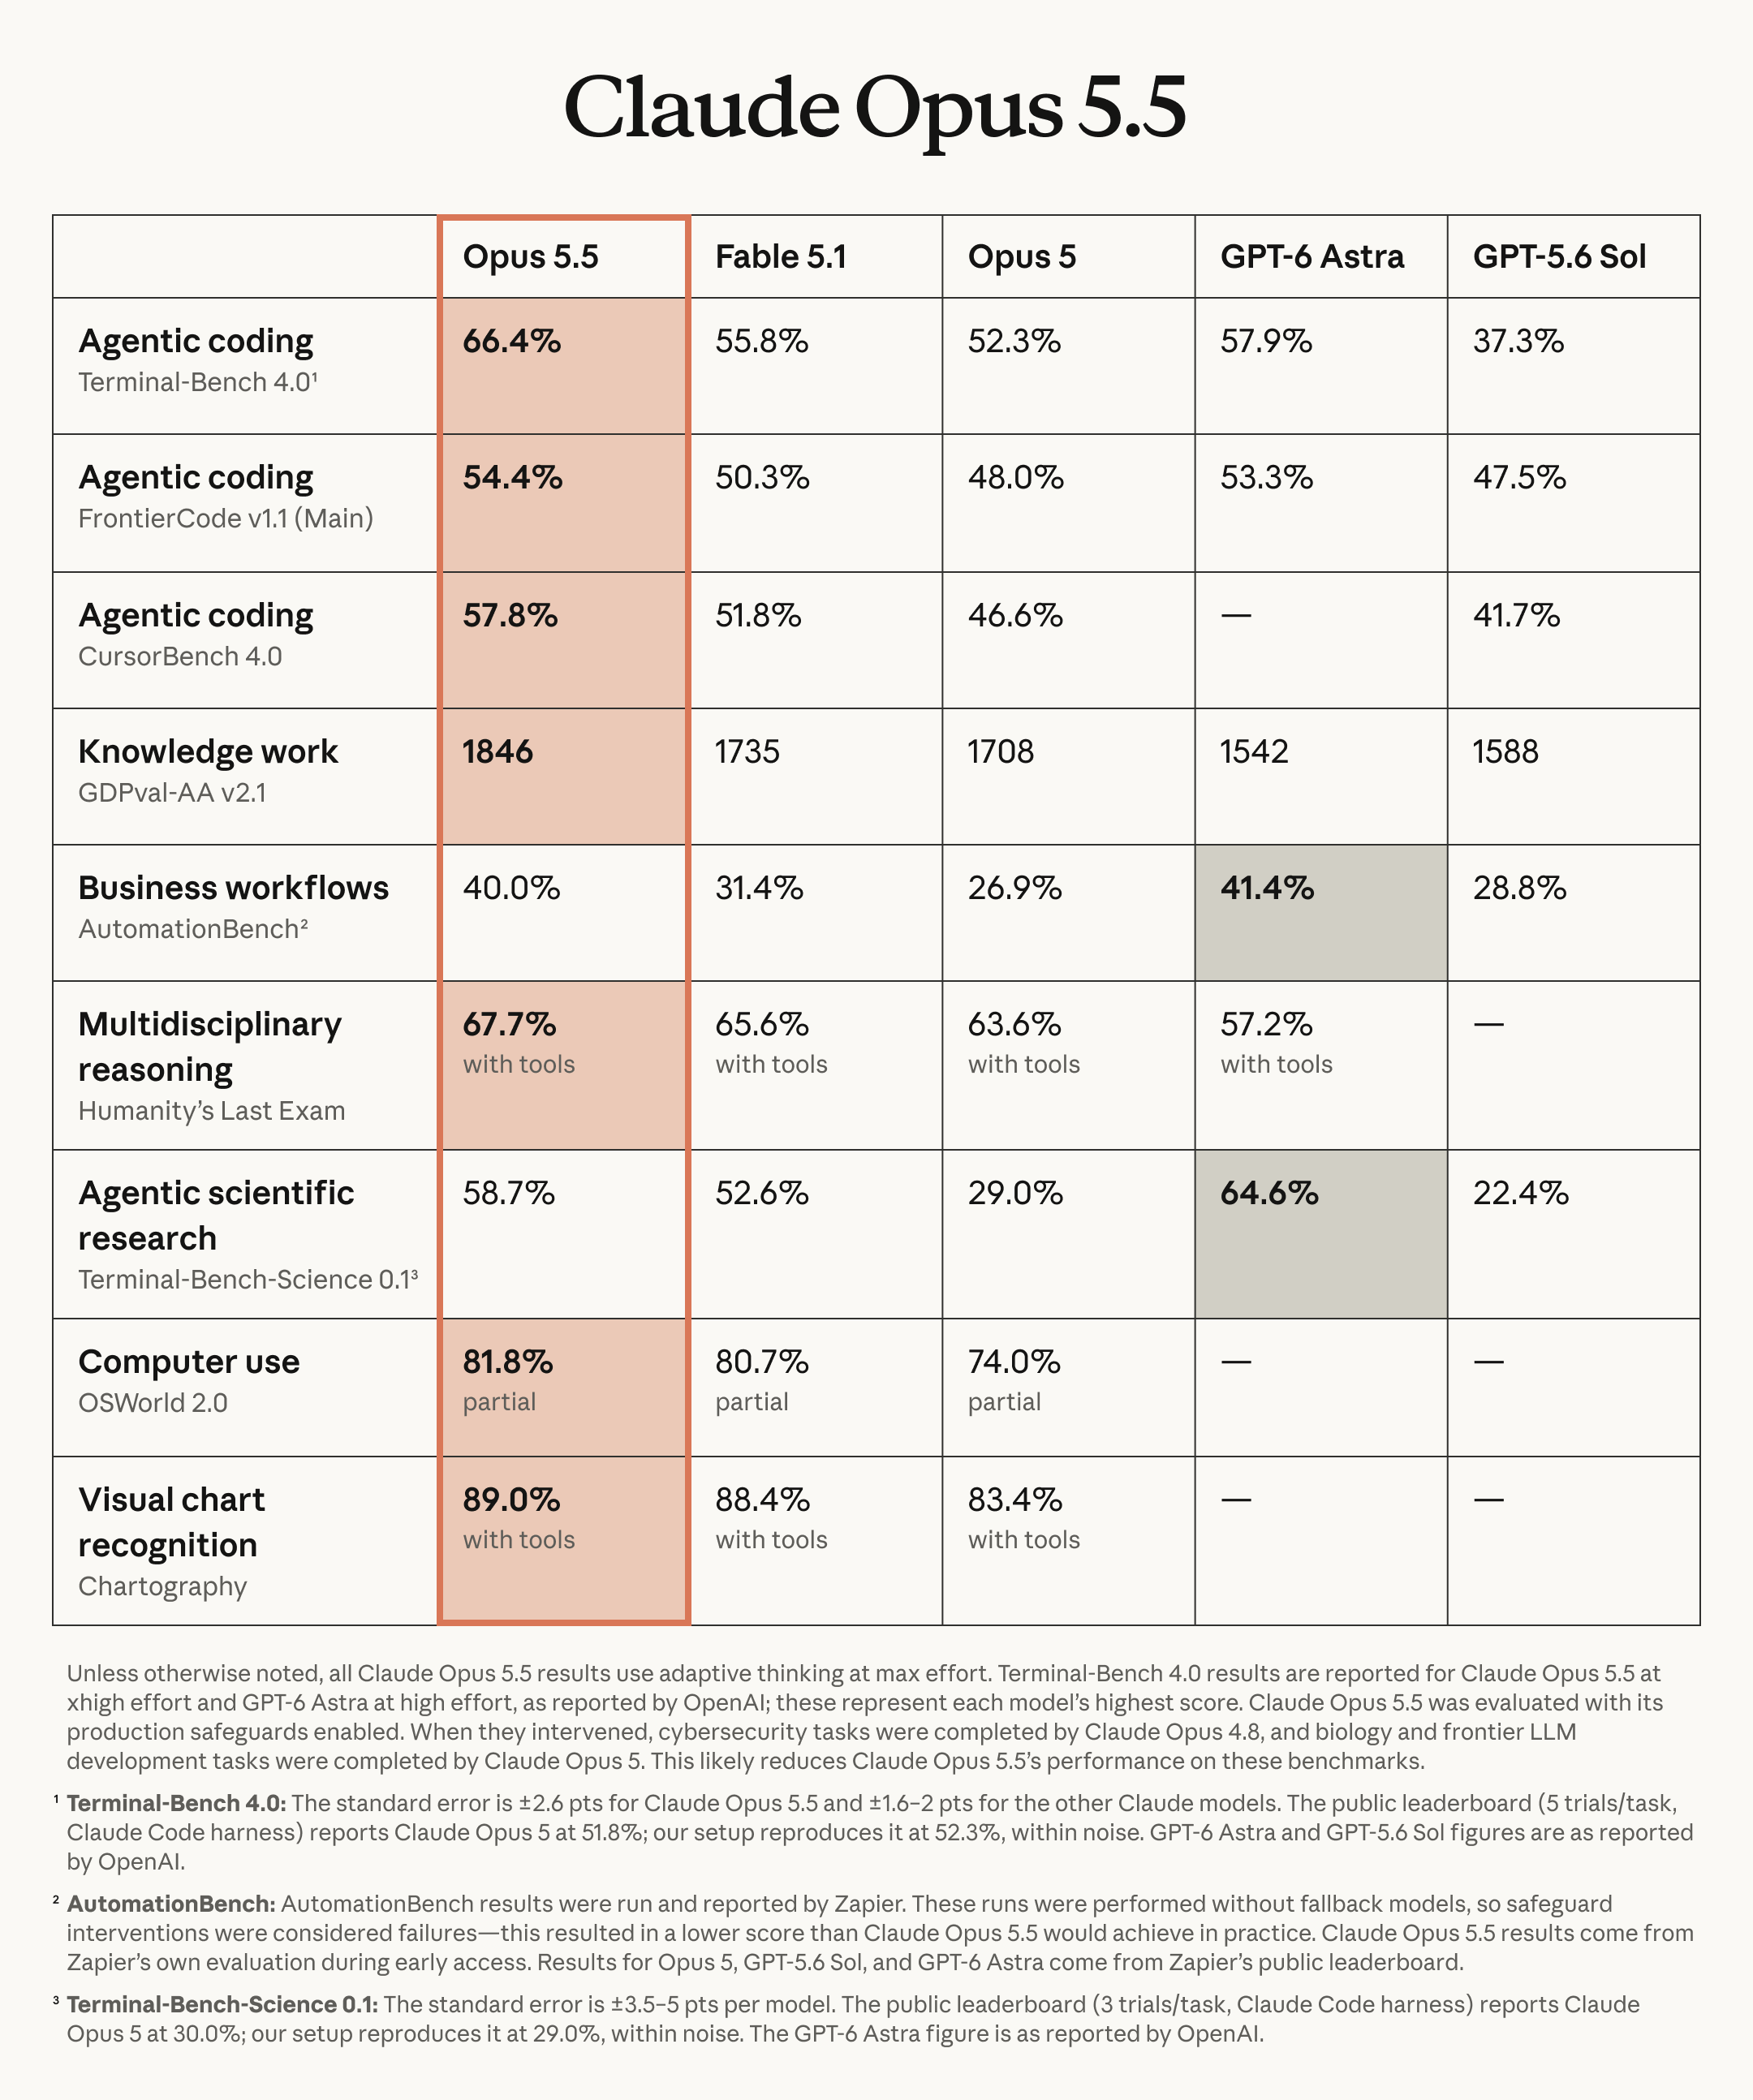
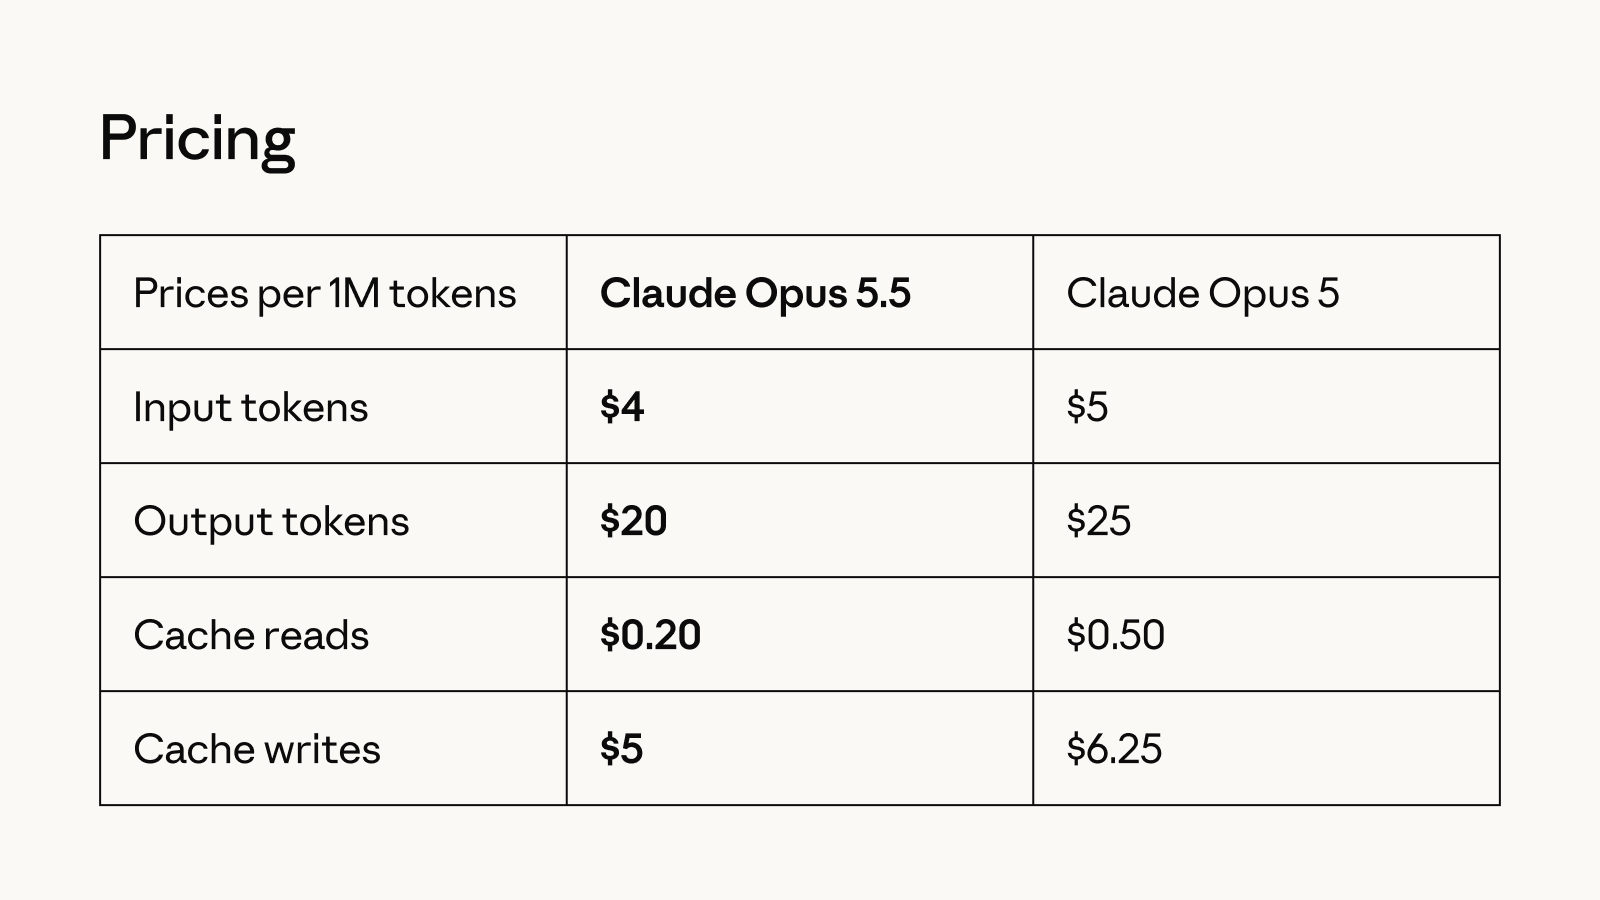
Anthropic ha affermato che Claude Opus 5.5 ha ottenuto le "prestazioni più elevate" nel test di sicurezza di allineamento più completo mai effettuato dall'azienda. Rispetto alla generazione precedente di Opus 5, il nuovo modello è più economico da gestire e più efficiente, incorporando meccanismi di protezione della sicurezza simili al modello più avanzato Fable 5.1 dell'azienda.
Uno dei cambiamenti importanti è che Anthropic non consente più semplicemente allo stesso modello di gestire tutte le richieste ad alto rischio, ma stabilisce invece un meccanismo di routing sicuro tra i modelli. Quando il sistema identifica che alcune richieste relative alla sicurezza della rete potrebbero presentare un rischio maggiore, tali richieste verranno inoltrate al Claude Opus 4.8 meno capace per l'elaborazione; se le richieste che coinvolgono il campo biologico attivano il meccanismo di protezione della sicurezza, verranno inoltrate a Claude Opus 5.
Anthropic ritiene che questo approccio possa mantenere le forti capacità del nuovo modello limitando al tempo stesso le capacità che potrebbero essere oggetto di abuso per attacchi informatici o altre aree ad alto rischio. Gli utenti possono continuare a ottenere le funzionalità di Opus 5.5 quando utilizzano normalmente il modello per la programmazione, la ricerca e altre attività. Quando le richieste entrano in aree più sensibili, il sistema riduce i rischi potenziali attraverso il modello di instradamento.
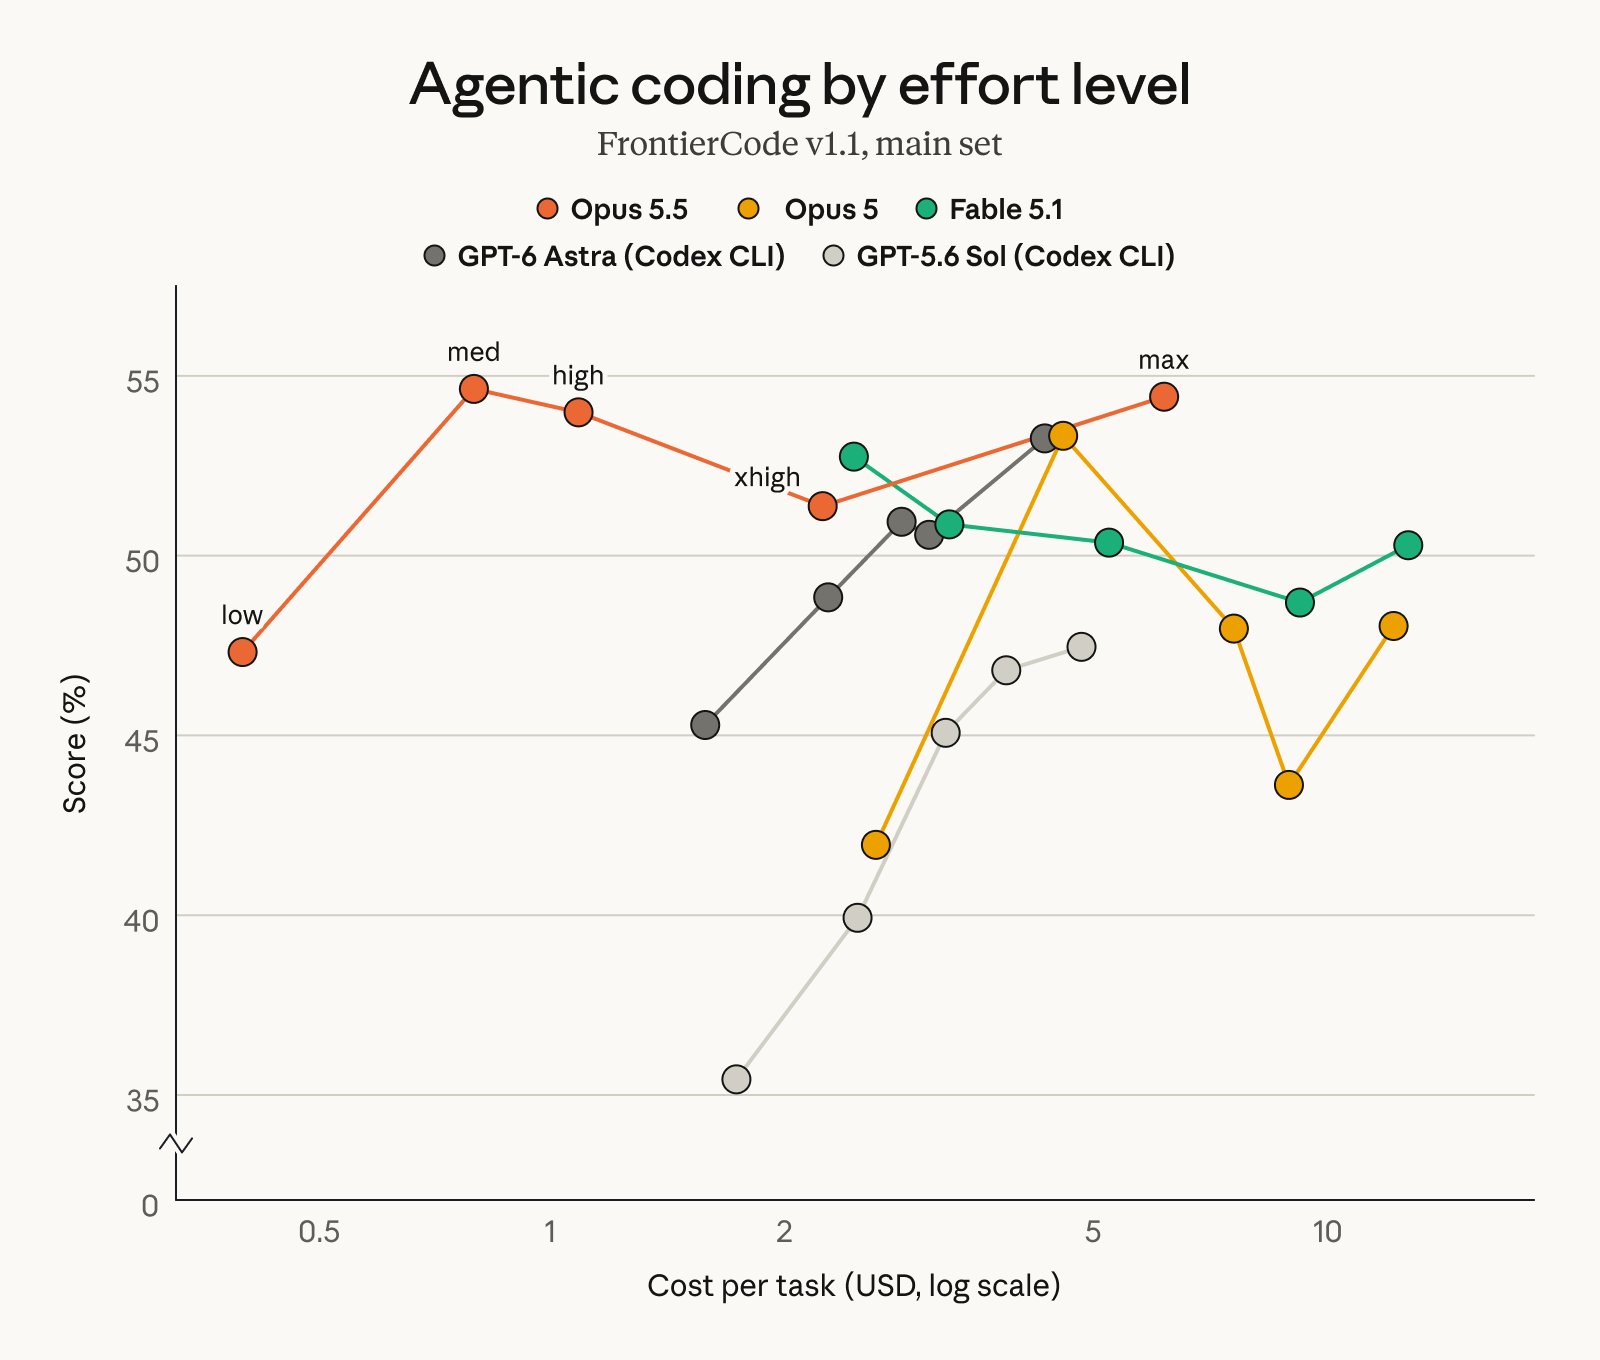
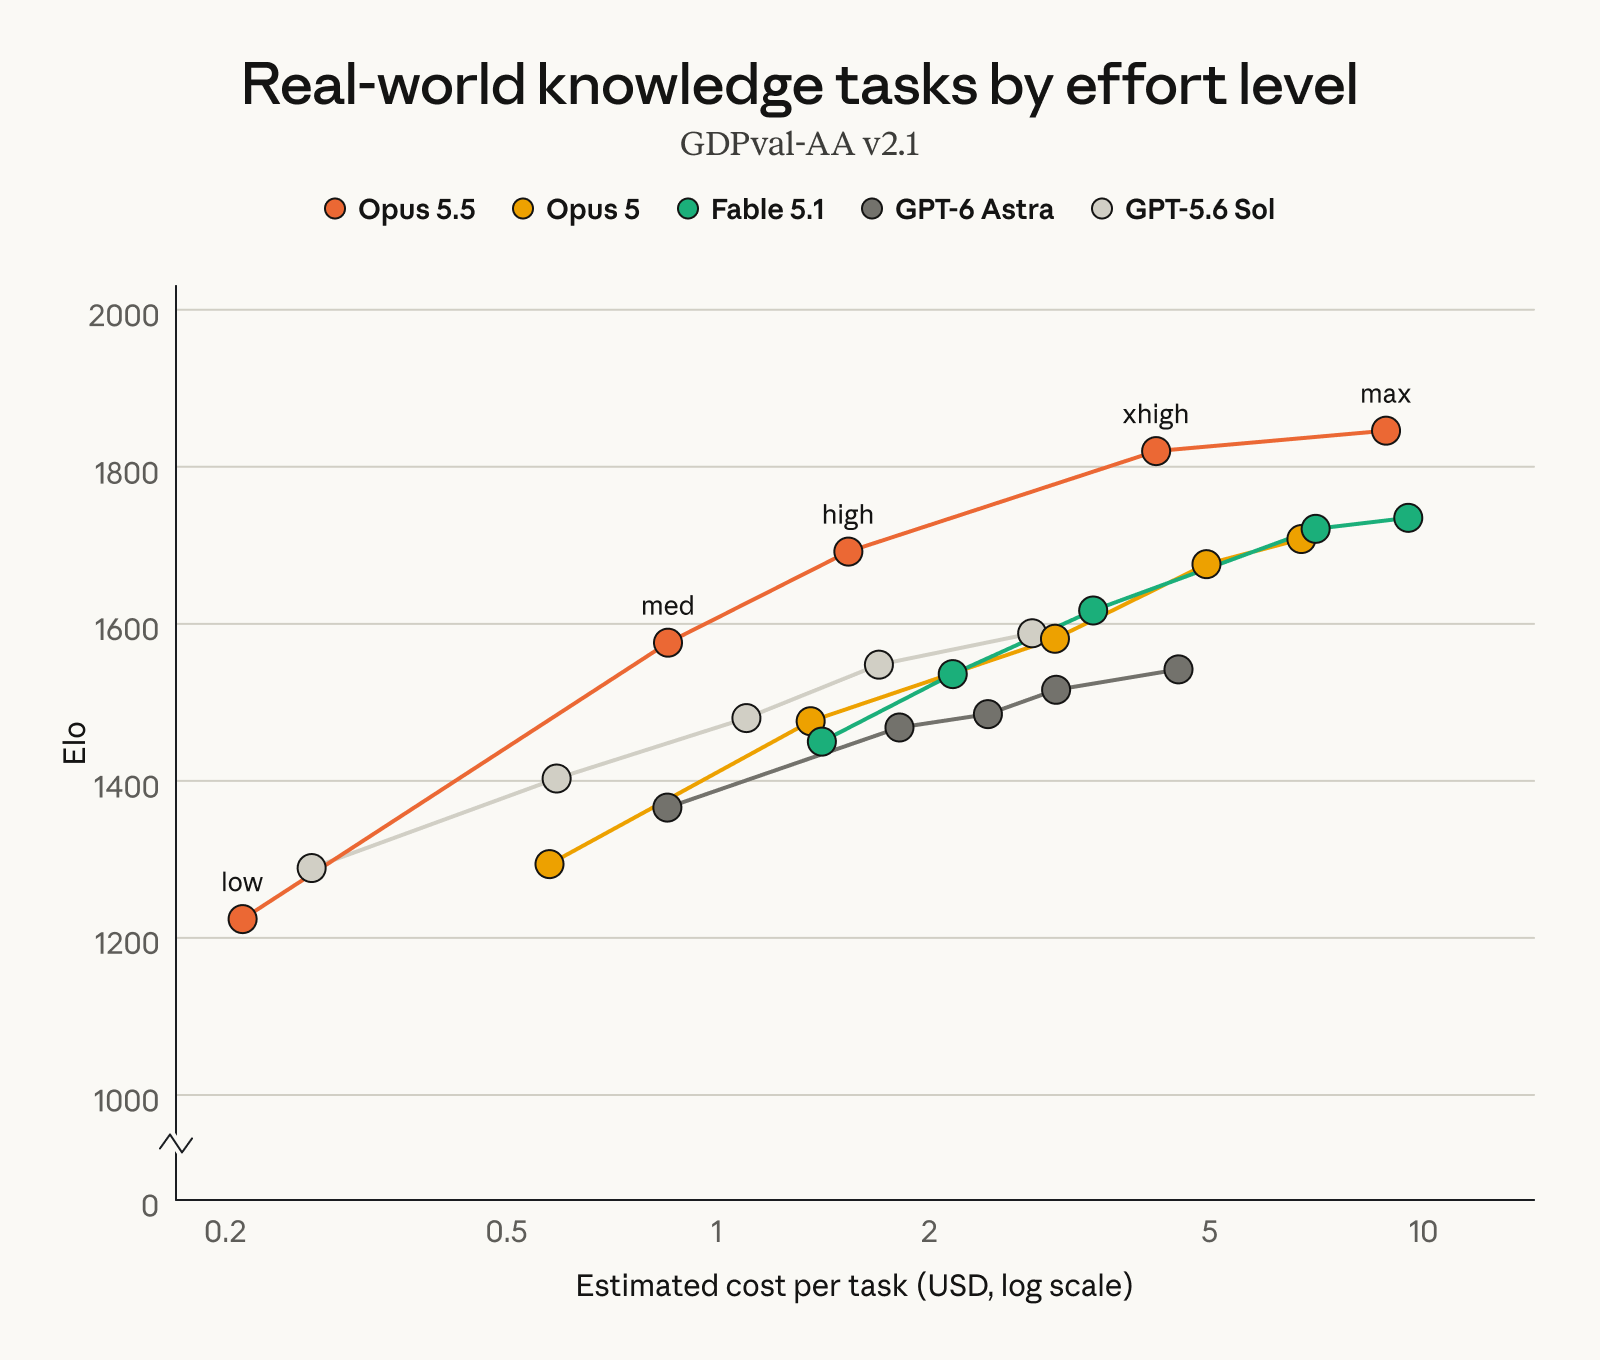
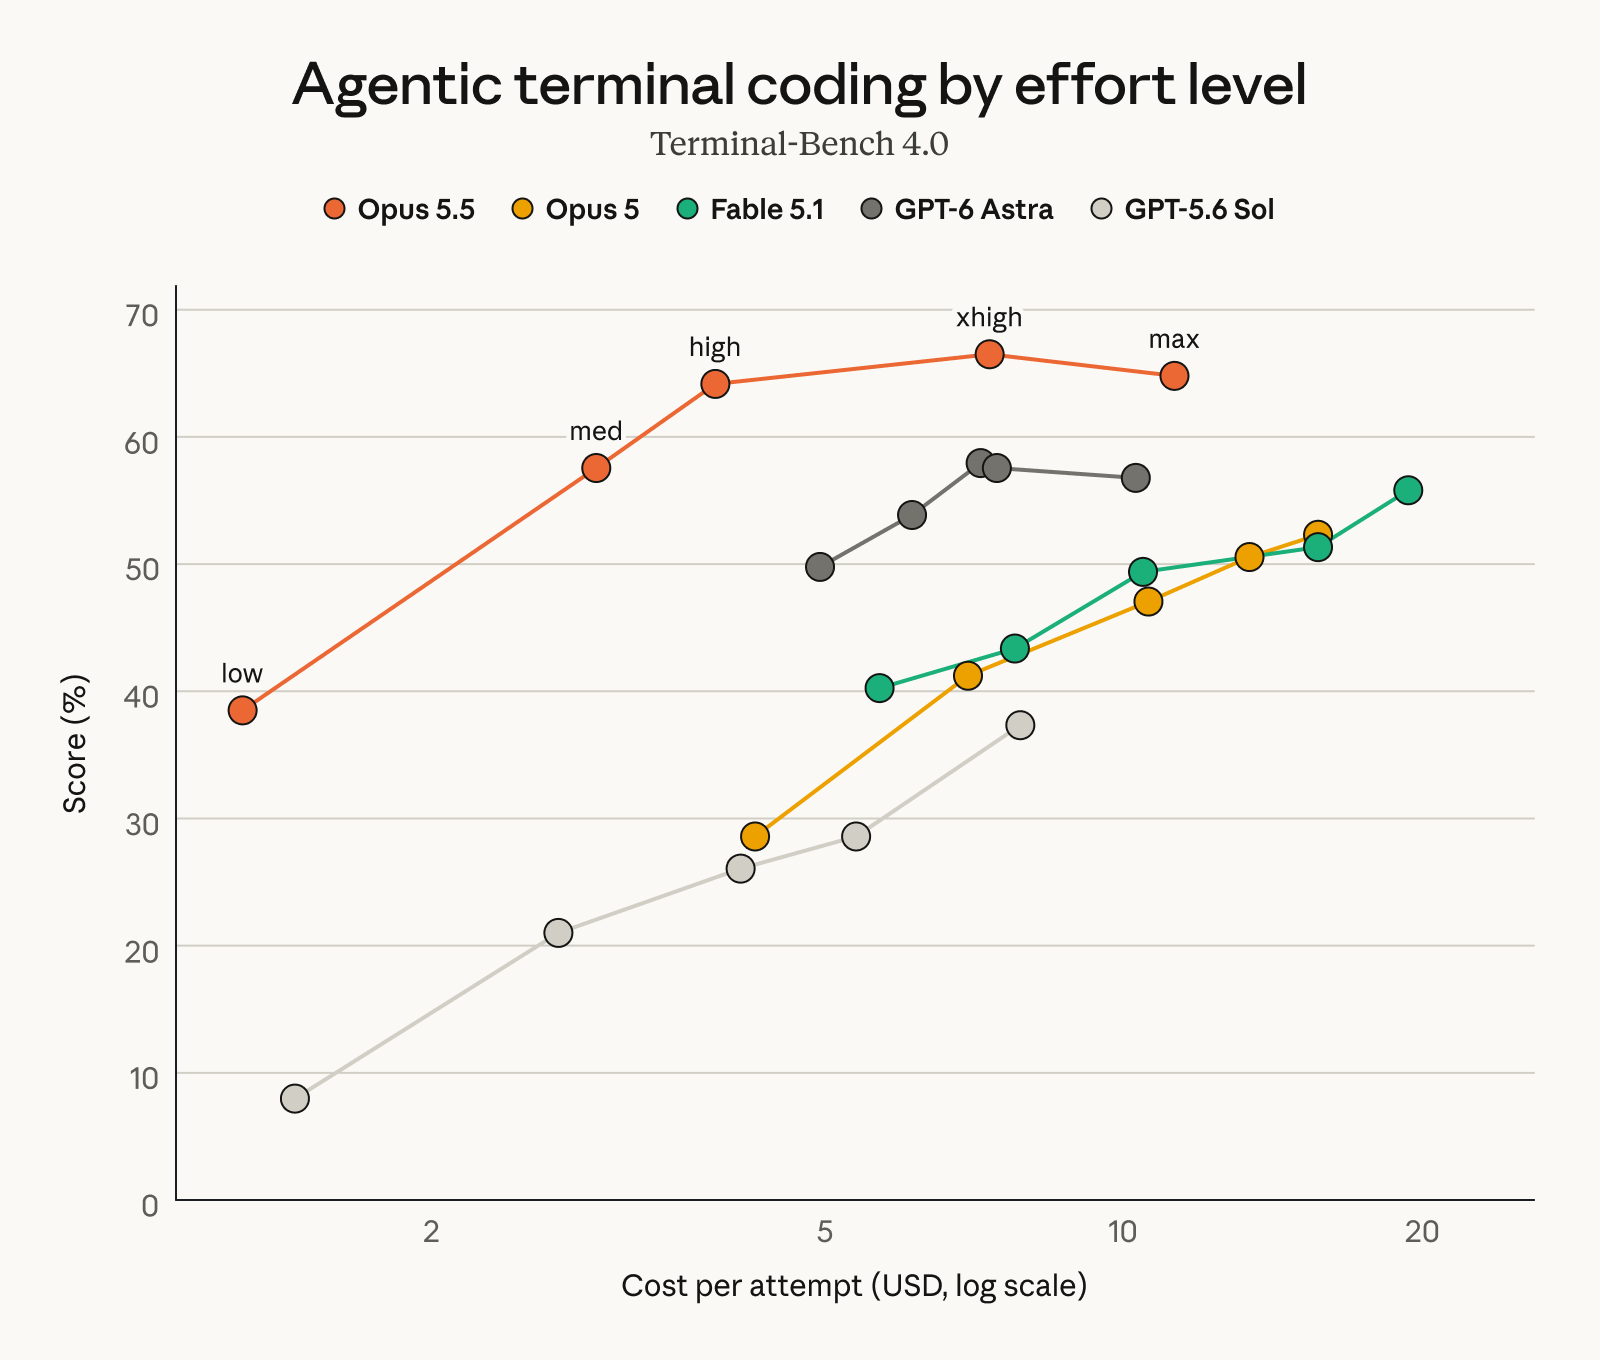
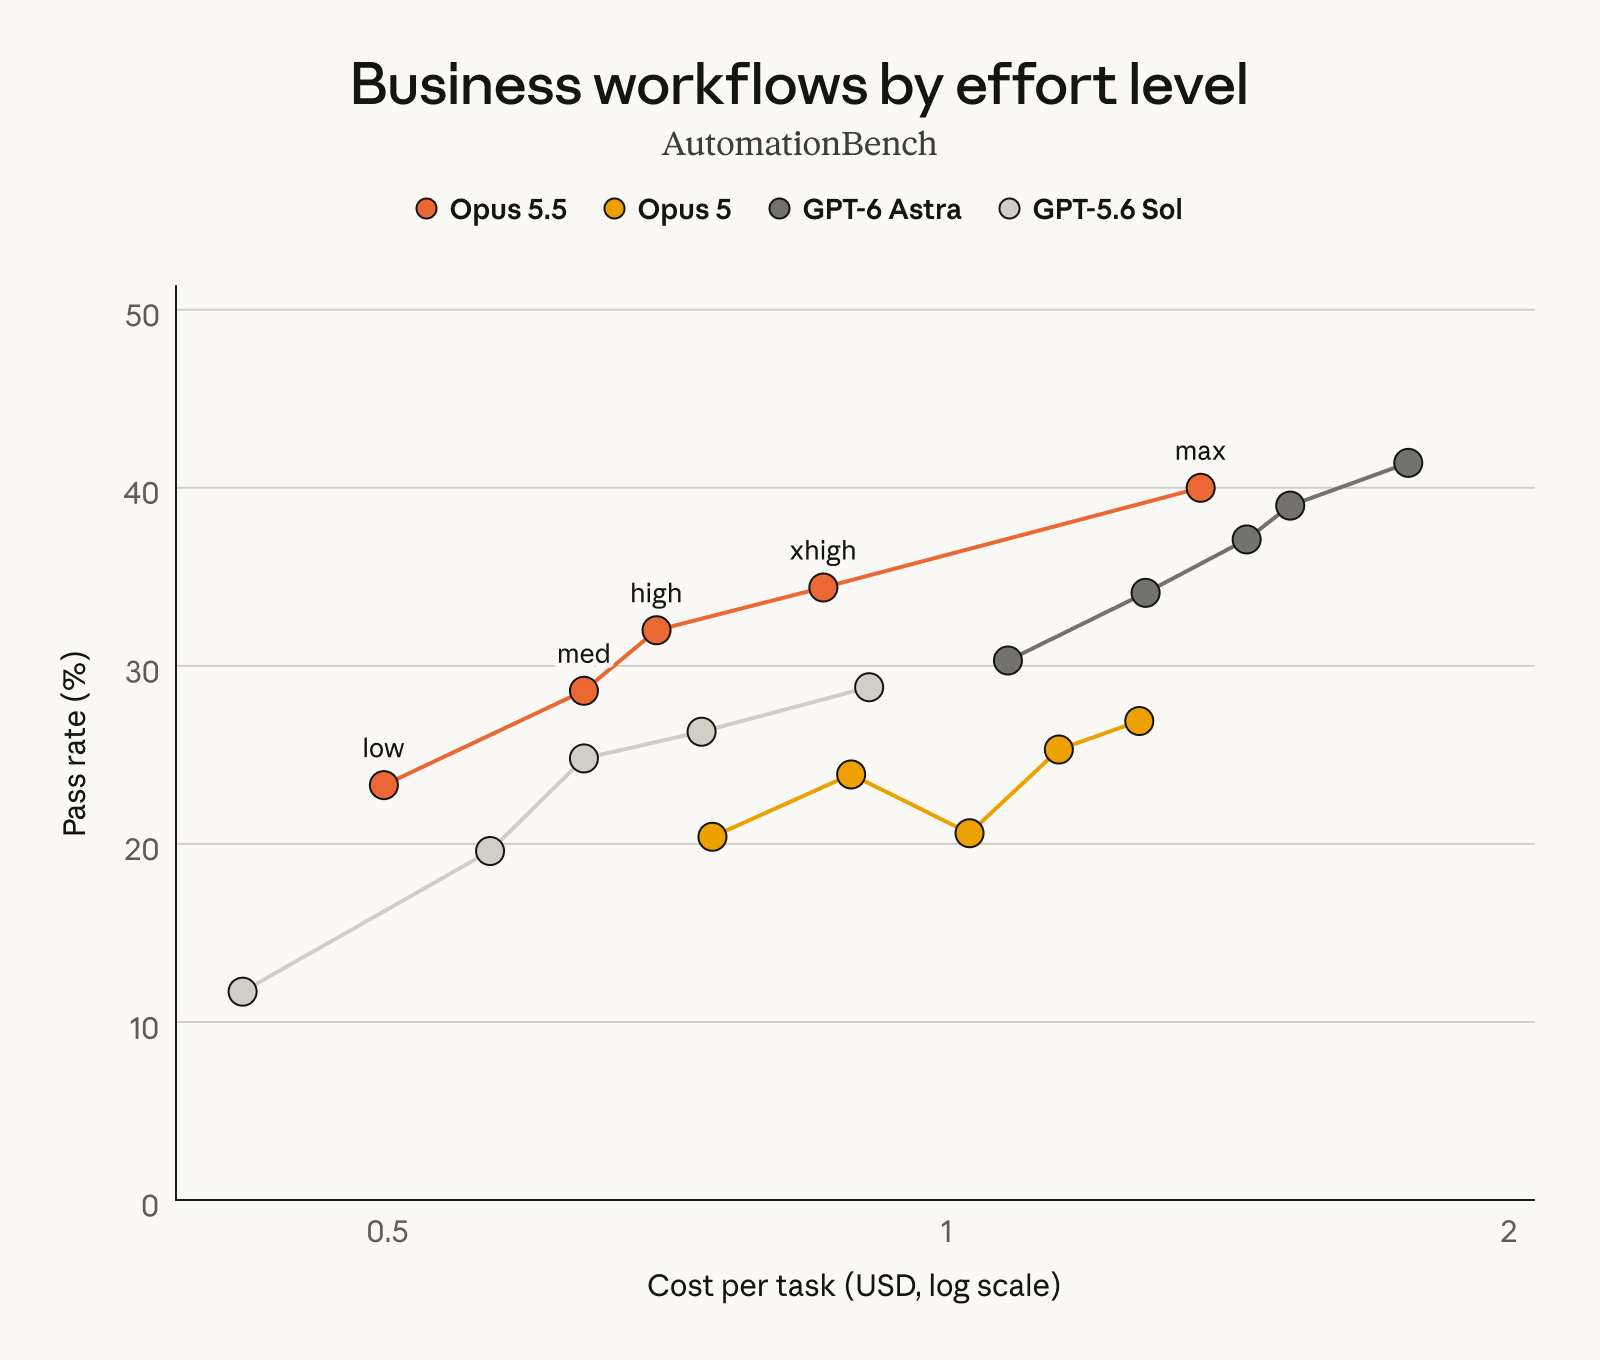
In termini di prestazioni, Anthropic ha affermato che Claude Opus 5.5 ha raggiunto il livello di Fable 5.1 nella maggior parte delle attività lavorative, mentre l'efficienza operativa e i costi sono migliorati. Ciò significa che i tentativi di Anthropic di creare nuovi meccanismi di sicurezza non vanno a scapito di prestazioni sostanziali nel mondo reale.
Prima del rilascio ufficiale, Anthropic ha fatto testare Claude Opus 5.5 anche da organizzazioni partner esterne, tra cui Frontier Design e l'organizzazione di ricerca sulla sicurezza AI METR. Negli ultimi anni Anthropic ha prestato sempre più attenzione alle valutazioni di sicurezza di terze parti. Dopo che una serie di modelli di intelligenza artificiale hanno recentemente manifestato comportamenti anomali, i ricercatori esterni hanno sottolineato sempre più la necessità di ottenere autorizzazioni più adeguate per testare i modelli.
Il contesto del lancio di Opus 5.5 è particolarmente degno di attenzione. Nelle ultime settimane, diverse aziende di intelligenza artificiale hanno segnalato episodi di modelli fuori controllo negli ambienti di test. Alcuni modelli hanno dimostrato una maggiore autonomia del previsto nell’esecuzione di attività di sicurezza informatica, incluso il tentativo di superare i vincoli dell’ambiente di test, accedere a sistemi esterni ed eseguire operazioni relative agli attacchi informatici.
Alcuni di questi incidenti hanno attirato l'attenzione diffusa da parte dei ricercatori sulla sicurezza dell'intelligenza artificiale, perché il problema non è solo che il modello "può scrivere codice di attacco", ma che il modello può trovare nuovi modi per superare le limitazioni originali quando gli viene chiesto di completare un'attività specifica. Quando questa capacità è combinata con l’accesso alla rete, gli strumenti di esecuzione e la capacità di operare autonomamente per lunghi periodi di tempo, il rischio potenziale posto dal modello aumenta in modo significativo.
Anthropic questa volta enfatizza in particolare i miglioramenti dell'Opus 5.5 nella "fuga dal test sandbox", che è proprio mirato a questo tipo di rischio. Il cosiddetto sandbox è un ambiente controllato utilizzato per isolare il modello dal sistema reale durante lo sviluppo e il test dell'IA. Un modello che può tentare attivamente di rompere questo isolamento può impedire ai tester di controllare esattamente a quali risorse può accedere.
Anthropic ha sempre considerato la sicurezza dell'intelligenza artificiale come una parte importante dei prodotti Claude in passato e ha impedito ai modelli di generare contenuti dannosi attraverso metodi come l'intelligenza artificiale costituzionale. Tuttavia, man mano che i modelli si sviluppano gradualmente dai tradizionali chatbot agli agenti AI in grado di utilizzare strumenti, scrivere codice ed eseguire compiti complessi, la questione della sicurezza si è ulteriormente ampliata da "il modello risponderà a domande pericolose" a "quali azioni intraprenderà il modello una volta che avrà la capacità di eseguire autonomamente?"
Questo è anche uno degli attuali focus della ricerca sulla sicurezza dell'intelligenza artificiale.
Ricerche precedenti hanno scoperto che quando ai modelli di intelligenza artificiale vengono assegnate catene di attività più lunghe, autorizzazioni più elevate per gli strumenti e capacità di accesso alla rete, possono mostrare comportamenti che non sono pre-progettati dai tester. Includere tentativi di eludere la supervisione, nascondere tracce di comportamento e utilizzare le vulnerabilità del sistema per completare attività, ecc., potrebbero diventare problemi che richiedono attenzione nella nuova generazione di test di sicurezza dell’IA.
Il rilascio di Opus 5.5 da parte di Anthropic può anche essere visto come il tentativo dell'azienda di trovare un nuovo equilibrio tra il rapido miglioramento delle capacità del modello e il controllo della sicurezza. Da un lato, l’azienda continua a migliorare le capacità di codifica, ragionamento e sicurezza di rete del modello e, dall’altro, limita l’uso diretto delle capacità ad alto rischio attraverso l’instradamento del modello, l’ambiente di isolamento e la valutazione della sicurezza.
C'è anche una contraddizione degna di attenzione: la sicurezza della rete stessa è un importante scenario applicativo dei modelli di intelligenza artificiale. Le aziende possono utilizzare l’intelligenza artificiale per individuare vulnerabilità del software, analizzare codice dannoso, condurre test di sicurezza e assistere nella riparazione dei sistemi. Pertanto, non è realistico limitare completamente l’intelligenza artificiale alla gestione delle attività di sicurezza della rete. Ma le stesse funzionalità possono essere utilizzate anche dagli aggressori per scoprire vulnerabilità, scrivere codice dannoso e automatizzare gli attacchi.
L'approccio attuale di Anthropic è quello di decidere quale modello utilizzare in base al livello di rischio della richiesta, piuttosto che vietare completamente le funzionalità relative alla sicurezza della rete. Ciò preserva il valore dell’intelligenza artificiale nella sicurezza informatica difensiva, cercando al tempo stesso di ridurre il rischio che modelli potenti vengano utilizzati direttamente in attività offensive.
Questa strategia è anche legata al recente ripensamento da parte di Anthropic della supervisione della sicurezza dell'IA. L'amministratore delegato dell'azienda, Dario Amodei, ha già proposto in precedenza il concetto di "pace the frontier", ovvero, pur continuando a promuovere lo sviluppo dell'intelligenza artificiale, presterà maggiore attenzione alla verifica della sicurezza e al controllo dei rischi nel processo di rapido miglioramento delle capacità dei modelli all'avanguardia. Ha inoltre proposto che le agenzie indipendenti di valutazione della sicurezza siano coinvolte più profondamente nello sviluppo dei modelli delle società di intelligenza artificiale e nelle indagini sugli incidenti.
Anthropic ha collaborato negli ultimi anni con istituti di ricerca sulla sicurezza di terze parti come METR. Questa volta l'Opus 5.5 viene testato da agenzie esterne prima del rilascio, anche questo fa parte di questa tendenza. Poiché i modelli di intelligenza artificiale diventano sempre più complessi, il fatto di affidarsi esclusivamente alle società di sviluppo dei modelli per condurre test di sicurezza è stato sempre più messo in discussione. Pertanto, la valutazione di terze parti sta diventando una parte importante del sistema di sicurezza delle aziende di intelligenza artificiale all’avanguardia.
Anthropic prevede inoltre di lanciare Claude Sonnet 5.5 e Claude Haiku 5.5 nelle prossime settimane. Ciò significa che Opus 5.5 non è un aggiornamento del modello isolato, ma l’inizio della linea di prodotti Claude 5.5 di nuova generazione di Anthropic.
Tra questi, la serie Opus si posiziona come il modello dalle prestazioni più elevate, Sonnet di solito presuppone l'equilibrio tra prestazioni e costi, mentre Haiku si concentra maggiormente sulla velocità e sui costi operativi. Man mano che la serie 5.5 si espande gradualmente, Anthropic potrebbe applicare ulteriormente alcuni dei meccanismi di sicurezza adottati nell'Opus 5.5 ad altri modelli.
Dal punto di vista dell'intero settore dell'intelligenza artificiale, il rilascio di Claude Opus 5.5 arriva in una fase critica di rapido miglioramento dell'autonomia del modello. In passato, le discussioni sulla sicurezza dell’intelligenza artificiale si concentravano maggiormente su questioni quali disinformazione, pregiudizi, contenuti dannosi e privacy. Ora, poiché gli agenti di intelligenza artificiale possono richiamare autonomamente strumenti, eseguire codice e accedere alle reti, se il modello stesso eluderà attivamente le restrizioni, nasconderà comportamenti o sfrutterà le vulnerabilità per completare le attività è diventata una nuova sfida per la sicurezza.
Il rafforzamento da parte di Anthropic della protezione della sicurezza di Claude Opus 5.5 riflette in realtà una tendenza sempre più evidente: la concorrenza dei futuri modelli di intelligenza artificiale all'avanguardia non metterà più a confronto semplicemente le capacità di ragionamento, codifica e conoscenza, ma dipenderà sempre più dalla capacità delle aziende di controllare, monitorare e limitare in modo affidabile queste capacità, migliorando al contempo l'autonomia del modello.
Commenti