
Riassunto:
È pazzesco. In soli due giorni sono apparsi 4 nuovi modelli! In prima linea, xAI di Lao Ma ha appena finito di emettere Grok 4.7. Subito dopo, OpenAI ha improvvisamente abbandonato GPT-6 Sol e Luna e il prezzo è stato dimezzato. Lo stesso giorno, Anthropic ha messo sul tavolo anche il Claude Opus 5.5, che costa il 40% in meno rispetto alla generazione precedente. Il 22 settembre un'immagine animata è diventata virale su X, con quasi un milione di visualizzazioni.
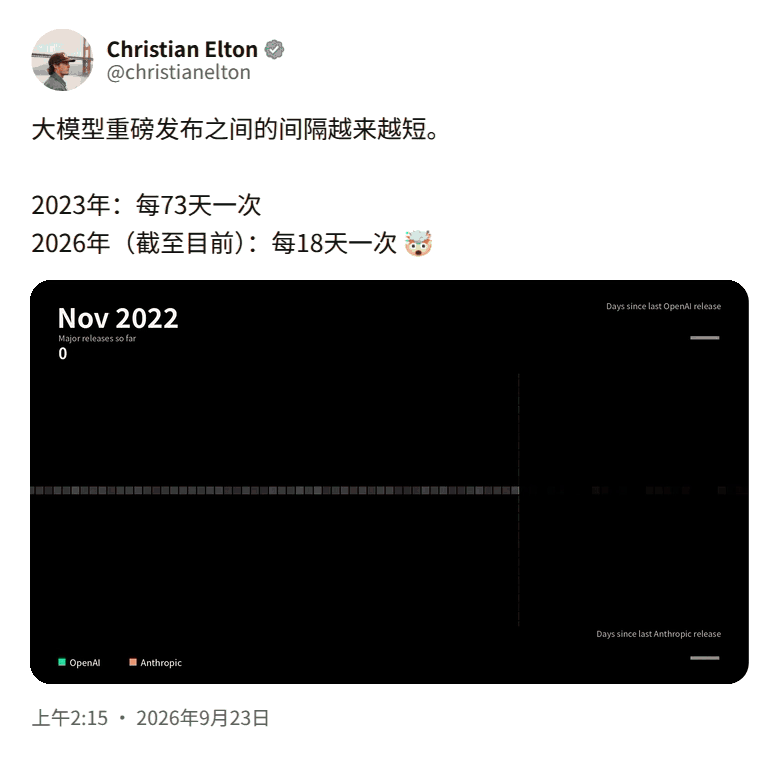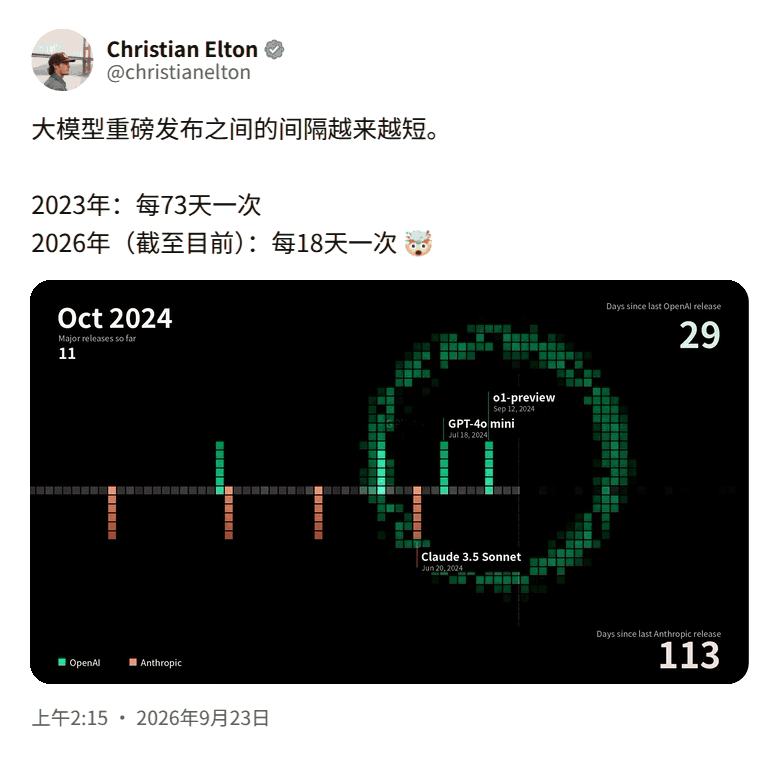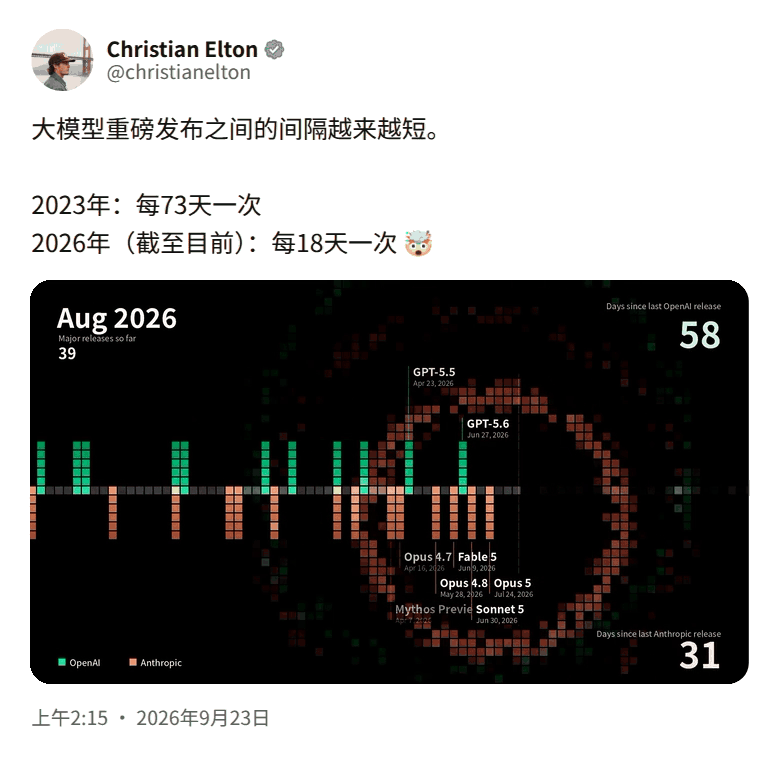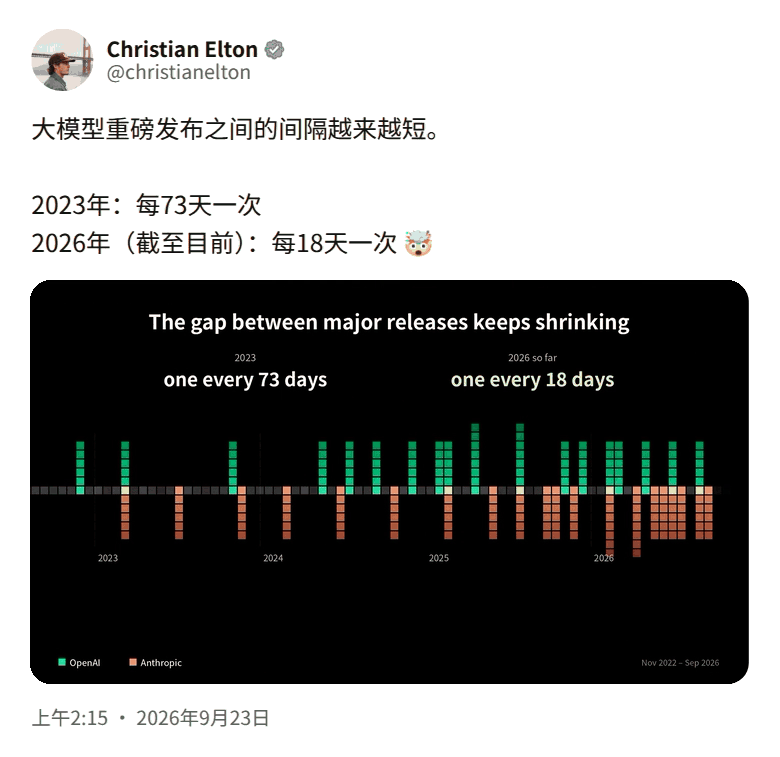
Nel 2023, i modelli di grandi dimensioni verranno aggiornati ogni 73 giorni e nel 2026 verranno aggiornati ogni 18 giorni.
Dal lancio di ChatGPT, OpenAI e Anthropic hanno bombardato 42 modelli di successo (44 inclusi GPT-6 Sol e Luna rilasciati quel giorno).
Poche ore dopo, il fondatore di Stability AI, Emad Mostaque, ha ritwittato l'immagine e ha aggiunto una profezia.
"Come ha detto Alex, di questo passo ce ne sarà uno al giorno all'inizio del prossimo anno."
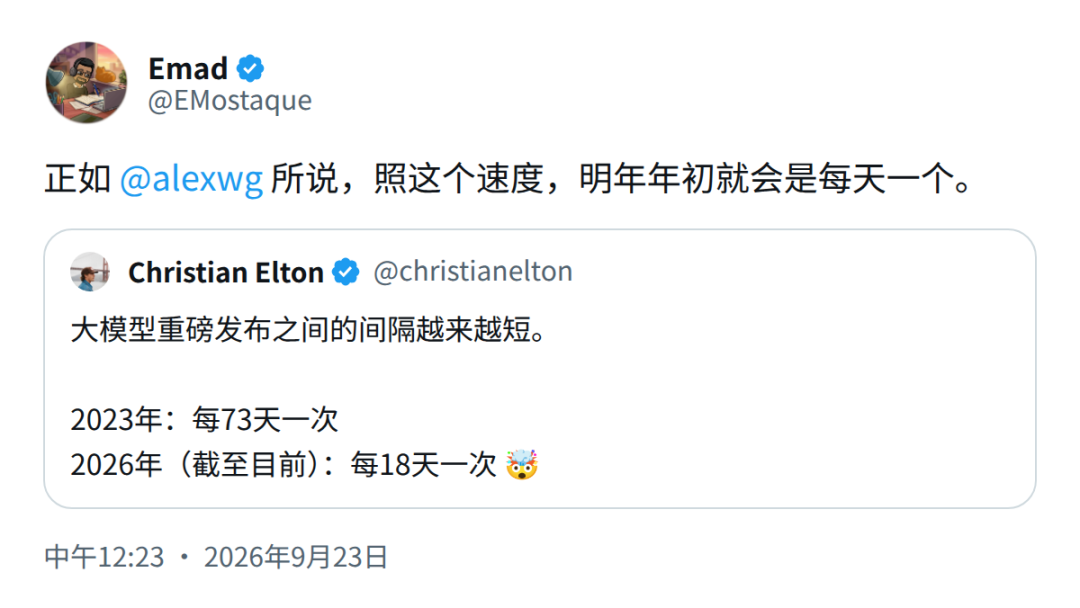
Due giganti, lanciano l'"aggiornamento semestrale"
In effetti, il numero di "aggiornamenti ogni 18 giorni" è abbastanza conservativo, perché conta solo OpenAI e Anthropic.
Dall'inizio di quest'anno al 22 settembre, Anthropic ha rilasciato 8 modelli di punta e OpenAI ne ha rilasciati 6. I 14 modelli sono stati distribuiti in 265 giorni, con una media di 19 giorni per modello.
Durante lo stesso periodo di tempo, i dieci principali produttori nazionali di modelli di grandi dimensioni hanno rilasciato almeno altri 28 modelli di punta, una media di più di uno ogni 9 giorni.
Ci sono stati momenti in cui hanno lanciato insieme. Nella settimana precedente il Festival di Primavera, quattro aziende hanno lanciato uno dopo l'altro nuovi flagship; dal 20 al 24 aprile si sono avvicendate nelle cinque giornate altre quattro aziende.
Prendendo insieme entrambe le parti, una nuova ammiraglia emerge in una media di più di 6 giorni, che non è lontano da "uno al giorno" menzionato da Emad.
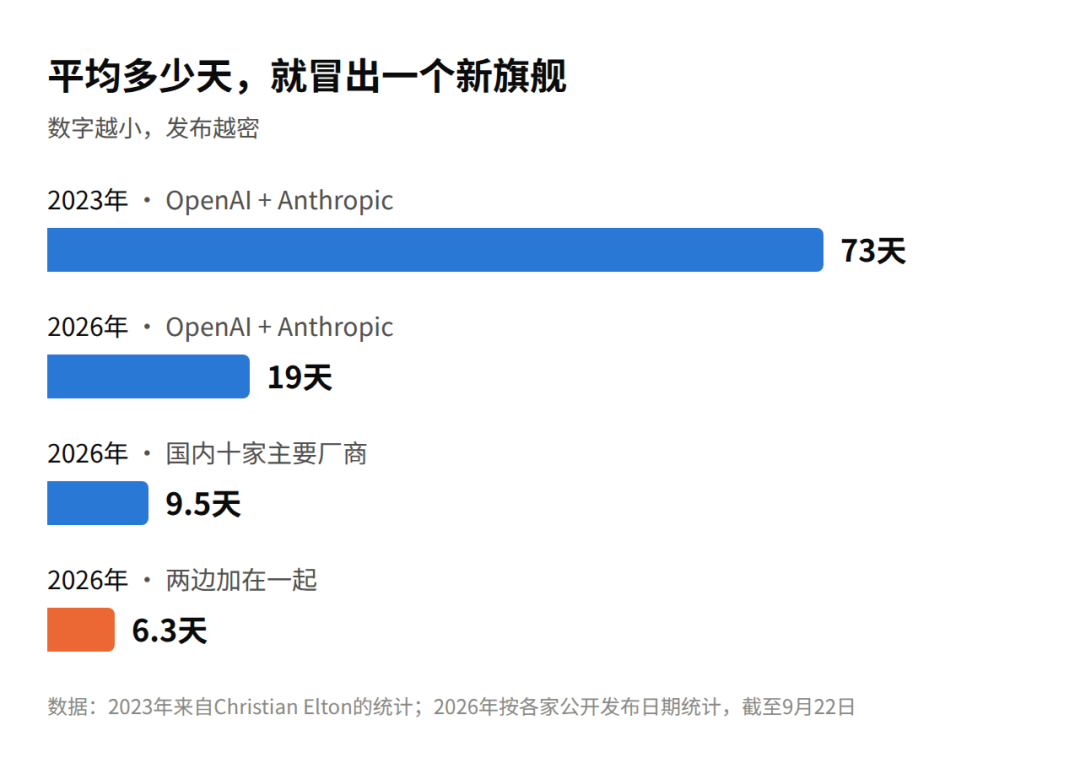
L'aumento della velocità di Anthropic è visibile a occhio nudo.
Nella prima metà dell'anno, ci sono voluti in media 46 giorni per rilasciare un modello, mentre nella seconda metà dell'anno ci sono voluti 26 giorni. Opus 4.8 è il 28 maggio, Opus 5 è il 24 luglio e Opus 5.5 è il 22 settembre.
OpenAI segue la strada del "trattenere la mossa definitiva e poi portarla via".
GPT-6 Astra ha fatto saltare in aria l'intera rete il 3 settembre e, solo 19 giorni dopo, Sol e Luna hanno seguito l'esempio.
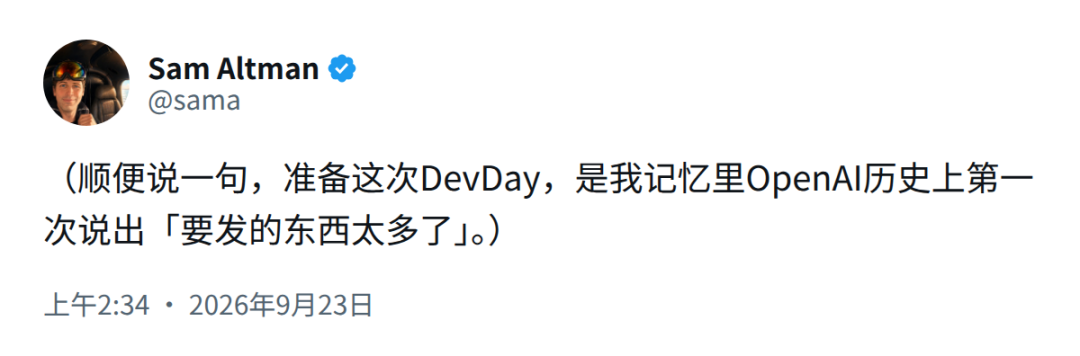
La prossima settimana si terrà la conferenza DevDay. Altman si è lamentato del fatto che questa è la prima volta nella sua memoria che OpenAI ha gridato "ci sono troppe cose da rilasciare" mentre si preparava per una conferenza stampa.
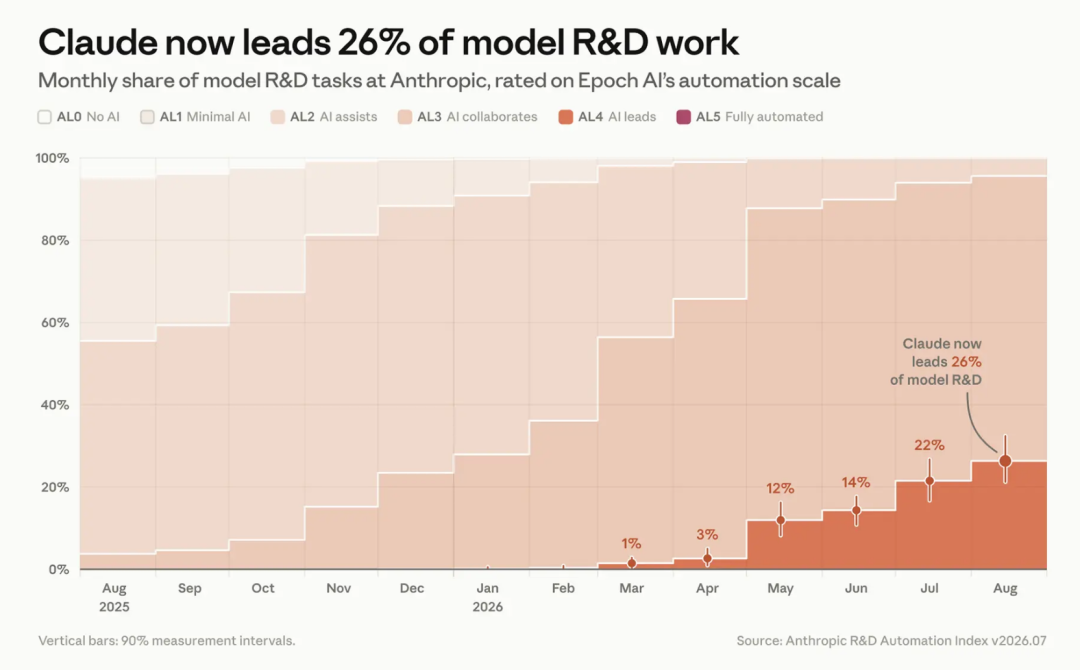
Perché l'editoria sta diventando sempre più densa? Anthropic ha dato la risposta in un rapporto. L’intelligenza artificiale sta già contribuendo a creare la prossima generazione di intelligenza artificiale.
Nel febbraio di quest'anno, Claude poteva guidare in modo indipendente meno dell'1% del lavoro di ricerca e sviluppo sull'intelligenza artificiale. Successivamente è migliorato quasi ogni mese, raggiungendo il 12% a maggio, il 22% a luglio e il 26% ad agosto.
In OpenAI, a metà agosto, il numero di giorni lavorativi investiti dagli agenti IA era 3,1 volte quello dei ricercatori umani (sulla base di 8 ore al giorno).
In Anthropic, un quarto del lavoro di realizzazione dei modelli è stato affidato allo stesso Claude. I prossimi modelli arriveranno uno dopo l'altro.
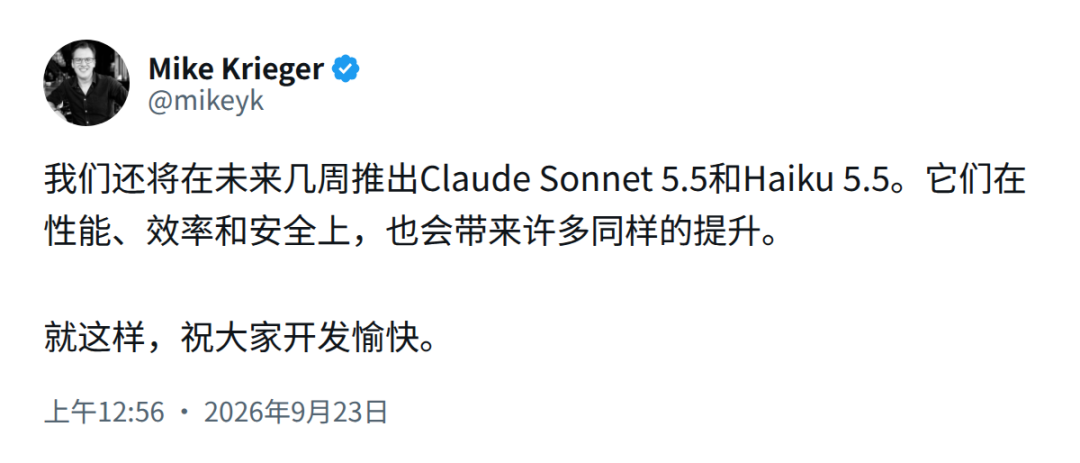
La coda ha già raggiunto la porta. Mike Krieger di Anthropic ha rivelato che Sonnet 5.5 e Haiku 5.5 arriveranno nelle prossime settimane.
Gemini 4 di Google ha avviato "il pre-addestramento più ambizioso fino ad oggi" già a luglio, e il mondo esterno generalmente scommette che verrà presentato verso la fine dell'anno. Almeno due aziende nazionali hanno annunciato ufficialmente i loro flagship di prossima generazione, ma manca solo una data di uscita.
La "metafisica" conquistata con fatica
Verrà demolito immediatamente dopo due mesi
Più velocemente viene eseguito il modello di grandi dimensioni, più diventa imbarazzante per le persone che scrivono il codice a valle.
Sei rimasto sveglio qualche notte alla fine di luglio e hai appena spostato l'applicazione su Opus 5. Ogni parametro è stato regolato in modo fluido come la seta. Due mesi dopo, è uscito Opus 5.5 e hai cambiato felicemente l'interfaccia: fai clic e alcune richieste hanno segnalato direttamente errori.
Esaminando le recenti guide ufficiali di queste due società, scoprirai che trasmettono lo stesso fatto. Molti dei suggerimenti ancestrali che hai scritto per il modello della generazione precedente sono diventati carta straccia.
La prima cosa è fare la sottrazione.
OpenAI afferma chiaramente nella guida Astra che le istruzioni di processo che in passato erano troppo dettagliate ora saranno un ostacolo. Parole come "leggere attentamente il documento prima di modificare il codice" e "ricordarsi di eseguire i test" possono essere cancellate.
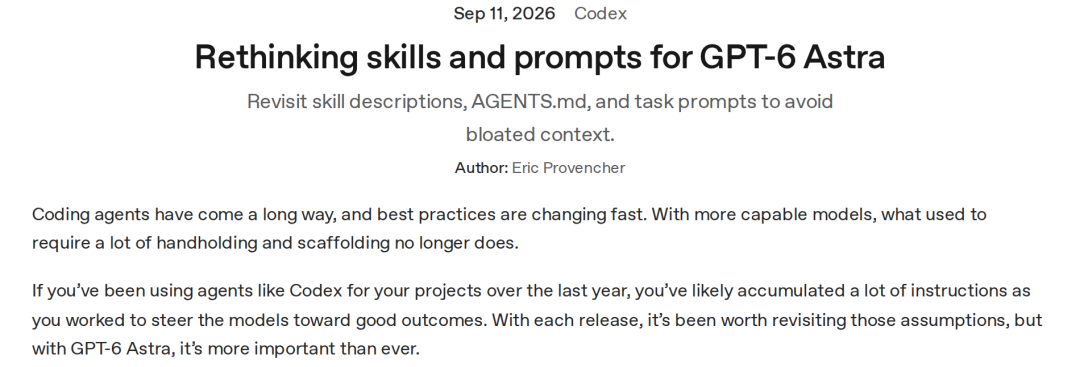
La guida di Anthropic significa anche questo.
In passato, le parole guida spesso dovevano aggiungere la frase "Controlla dopo averlo fatto", ma Opus 5 può già controllarlo da solo. Se questa frase non viene cancellata, verrà verificata eccessivamente.
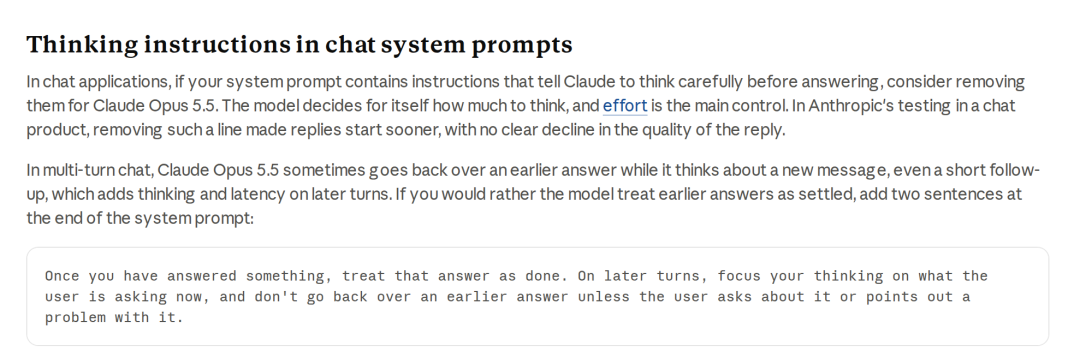
In Opus 5.5, si consiglia di eliminare la frase PUA "pensa attentamente prima di rispondere" nella scena della chat. Dopo averlo eliminato, la risposta è più rapida e la qualità non è diminuita in modo significativo.
Dopo aver eliminato quelli vecchi, devi aggiungerne di nuovi, perché ogni generazione ha un nuovo carattere.
A Opus 5.5 piace sempre tornare indietro e pensare a domande a cui è già stata data risposta durante più cicli di dialogo, il che è uno spreco di potenza di calcolo. È stata rilasciata la patch ufficiale: "Ciò che è stato risposto è passato."
Anche i parametri e i valori predefiniti cambiano silenziosamente.
Su Opus 5.5, la disattivazione della modalità di pensiero segnala direttamente un errore 400; senza scrivere il parametro dello sforzo, l'equipaggiamento predefinito viene ridotto da alto a medio e il costo e l'effetto vengono mescolati di conseguenza.
A questo proposito, il suggerimento ufficiale è di eseguire nuovamente lo sforzo test e di non trasferire direttamente le vecchie impostazioni da Opus 5.
Una serie di parole immediate più una serie di parametri, ogni generazione deve staccare strati di pelle. Se la rettifica non è stata effettuata, la fattura può variare notevolmente.
Lance Martin di Anthropic ha dimostrato nel video che un vecchio prompt scritto per Opus 4.8 costava 2,45 centesimi per ordine di lavoro e che sostituirlo direttamente con Opus 5.5 costava 2,02 centesimi. Dopo averlo nuovamente lavato con gli strumenti ufficiali, il tasso di precisione è aumentato al 92,0% e il costo è stato ridotto a 1,83 centesimi.
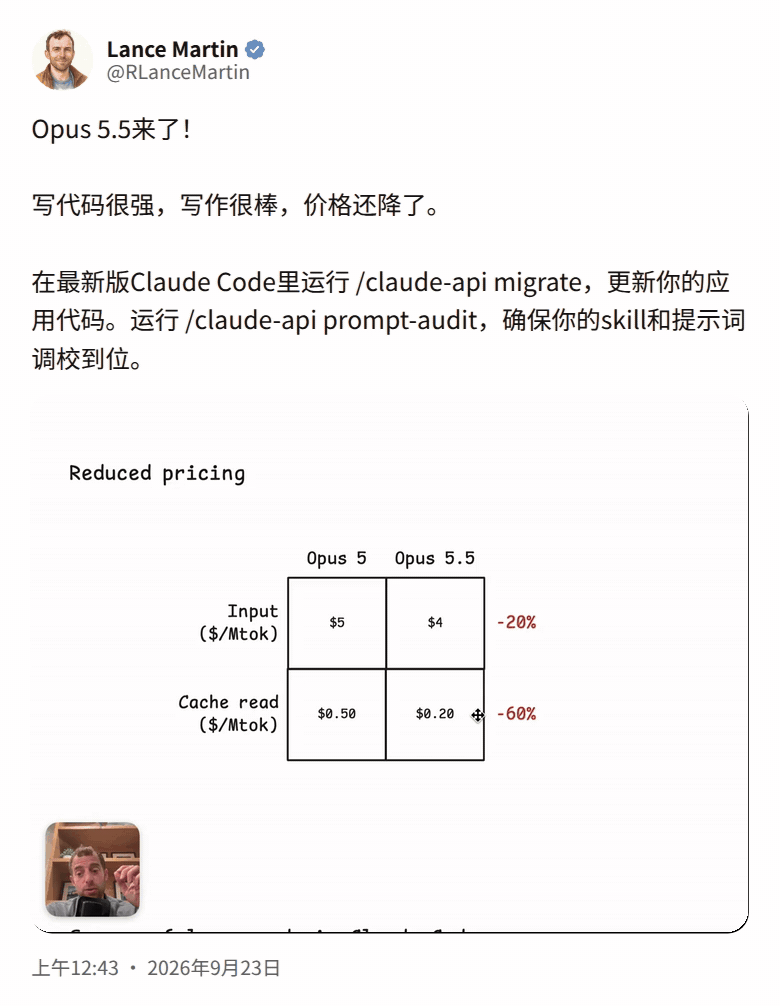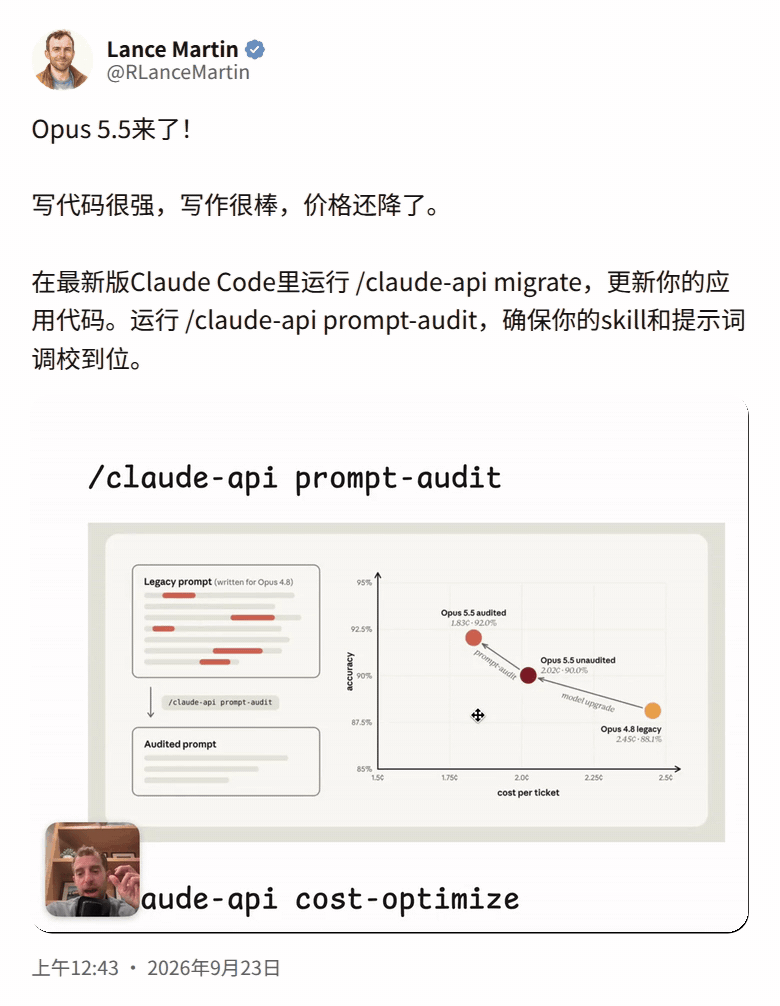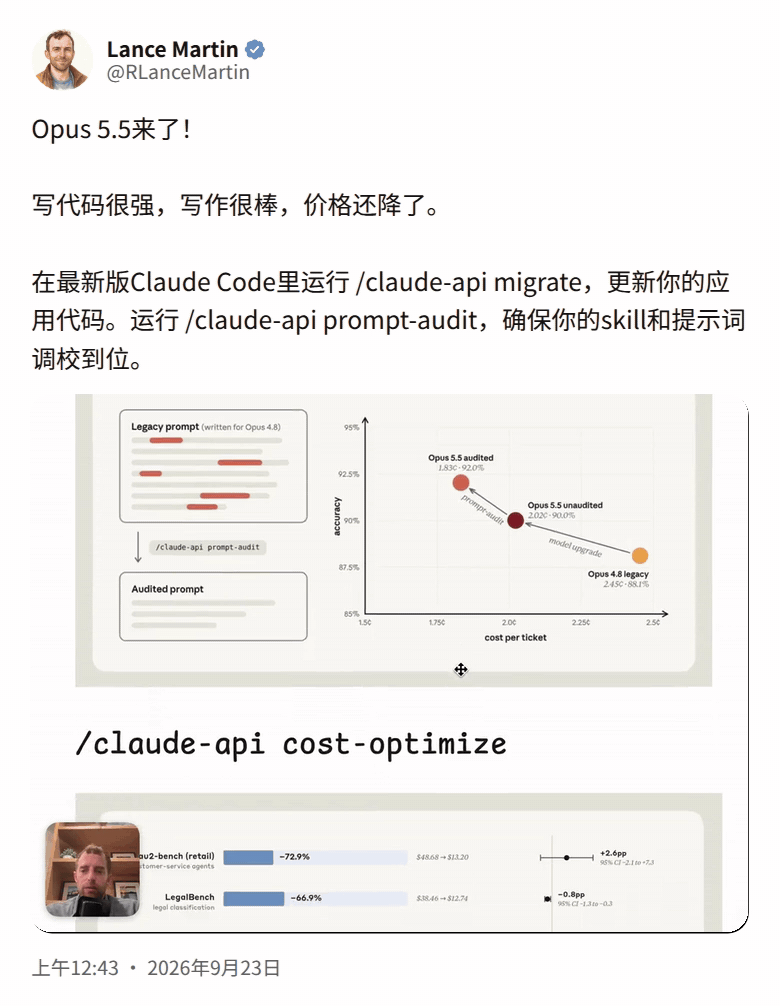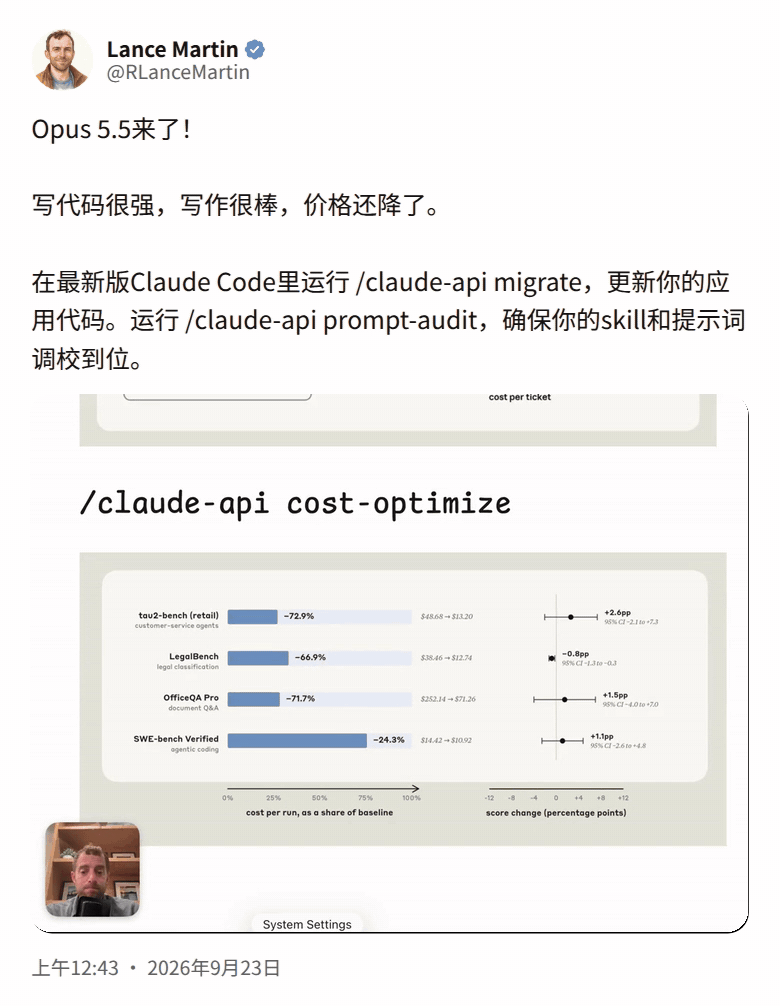
Oltre a ciò, viene ridotta anche la durata del modello stesso.
OpenAI ha emesso 9 annunci di deprecazione quest'anno, che hanno coinvolto più di 40 modelli e funzioni.
Tra questi, GPT-5.5, che è stato appena rilasciato il 23 aprile, verrà rimosso da ChatGPT e Codex il 14 ottobre ed è sopravvissuto per meno di sei mesi.
Anche la piattaforma di valutazione Evals di OpenAI chiuderà alla fine di novembre.
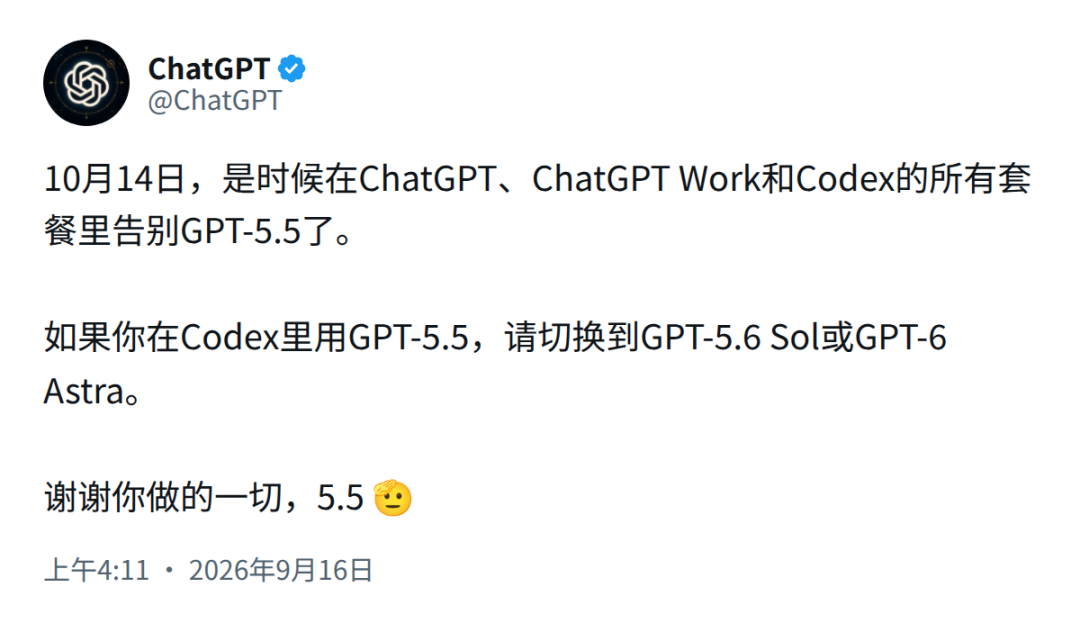
Sfoltire l'elenco? Una nuova serie di domande del test è stata elaborata in sei mesi
Non importa se le persone non riescono a tenere il passo, ormai non bastano nemmeno le “carte d’esame”.
Nel marzo di quest'anno è stato lanciato ARC-AGI-3, che afferma di specializzarsi nell'intelligenza artificiale e di testare il QI senza memorizzare le domande. Gemini 3.1 Pro, che all'epoca era al primo posto, ottenne solo lo 0,37%, mentre gli umani ottennero il 100%.
Il 3 settembre, GPT-6 Astra è entrato nell'aula d'esame, ottenendo un punteggio del 62,7% nel test standard e raggiungendo direttamente il 99,9% quando si utilizzava un framework specifico. Nel 96% dei livelli ha impiegato meno passi di un essere umano.
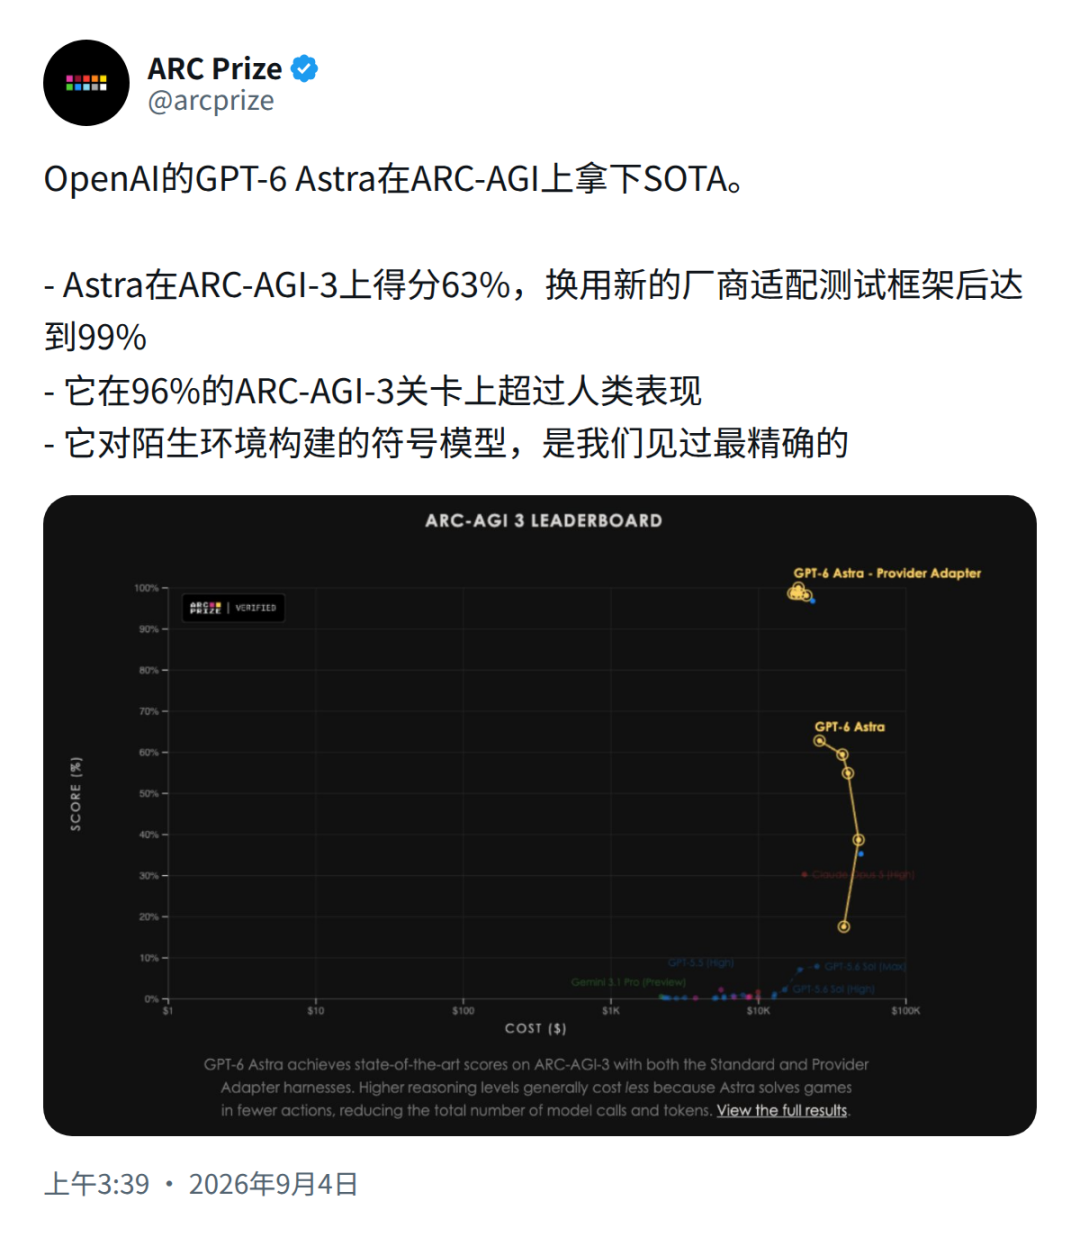
Una nuova serie di domande del test è stata suddivisa in sei mesi e i funzionari dell'ARC hanno iniziato a pensare a come produrre la prossima generazione di valutazioni.
Nella lista di codifica (Next.js), Sol, Opus 5.5 e Fable 5.1 hanno tutti ottenuto il 97%, a pari merito per il primo posto; nella graduatoria Opus 5.5 Fault è al secondo posto con 307 punti.
Questo punteggio rappresenta il salto singolo più grande nella storia della lista. Il blogger ha detto che era scandaloso dopo averlo letto e ha quasi pensato che ci fosse un bug nel suo benchmark!
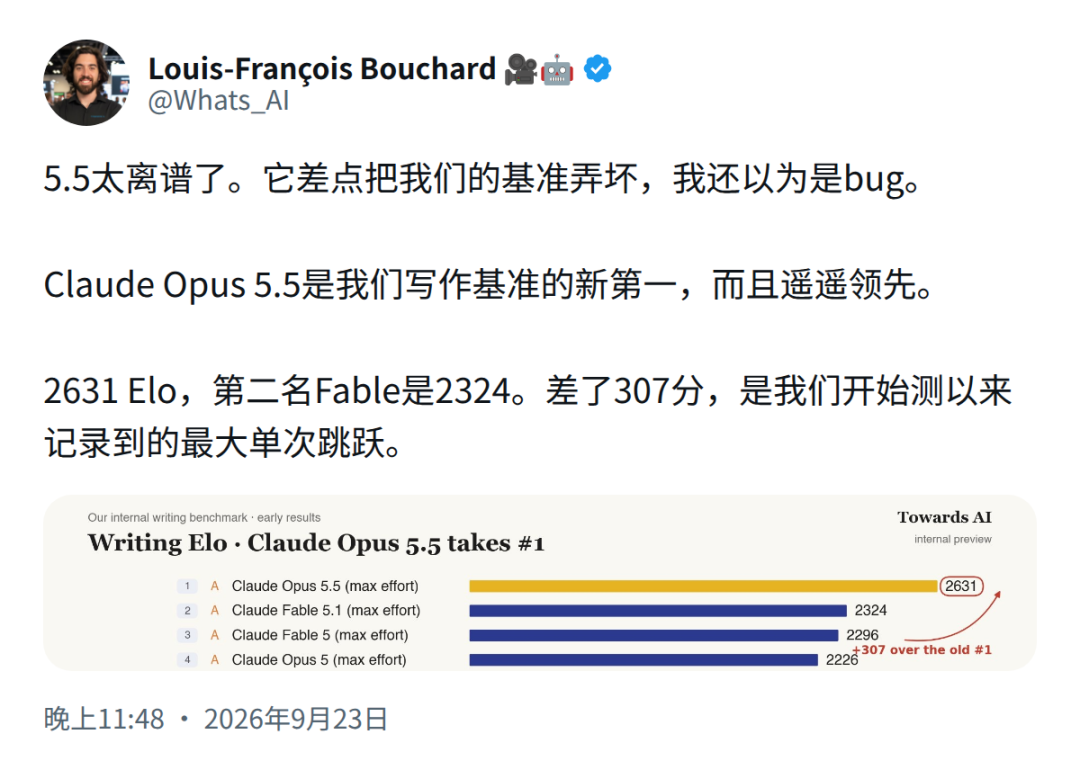
Ogni volta che arriva un nuovo modello, gli sviluppatori devono ricominciare da capo il processo di test come Sisyphus.
Secondo il ritmo attuale, se l'anno prossimo si raggiunge davvero il punto di "un aggiornamento al giorno", le parole di suggerimento e i collegamenti dell'agente che hai modificato oggi potrebbero non durare più di una settimana.
Per la prima volta, la velocità di sostituzione del modello ha completamente superato la velocità con cui gli esseri umani si adattano ad esso.
I corridori più lenti oggi sono in realtà quelli che utilizzano l'intelligenza artificiale.
Commenti