Riassunto:
Microsoft ha lanciato la tecnologia RDMA su USB4 per Windows 11, che consente a più PC comuni di lavorare insieme tramite connessioni USB4 o Thunderbolt per condividere memoria e potenza di calcolo della GPU, eseguendo così modelli di intelligenza artificiale su larga scala che originariamente superavano la capacità di memoria di una singola macchina. Si prevede che questa tecnologia abbasserà la soglia hardware per l’inferenza dell’intelligenza artificiale locale e consentirà agli sviluppatori di utilizzare i computer esistenti per costruire sistemi informatici distribuiti.
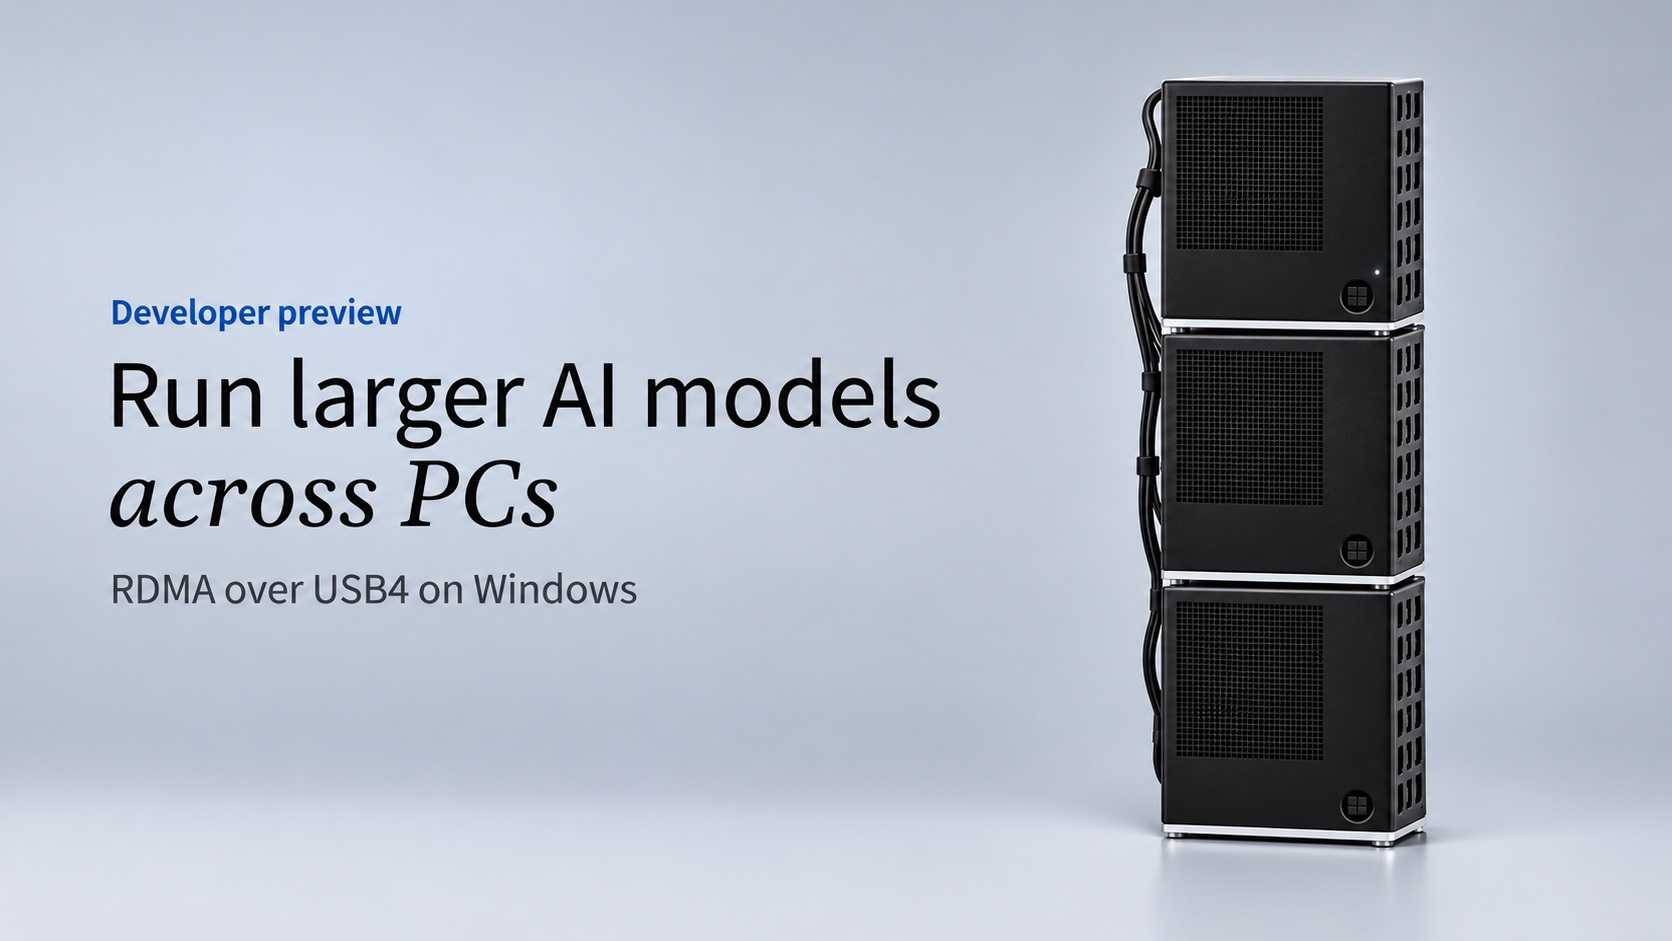
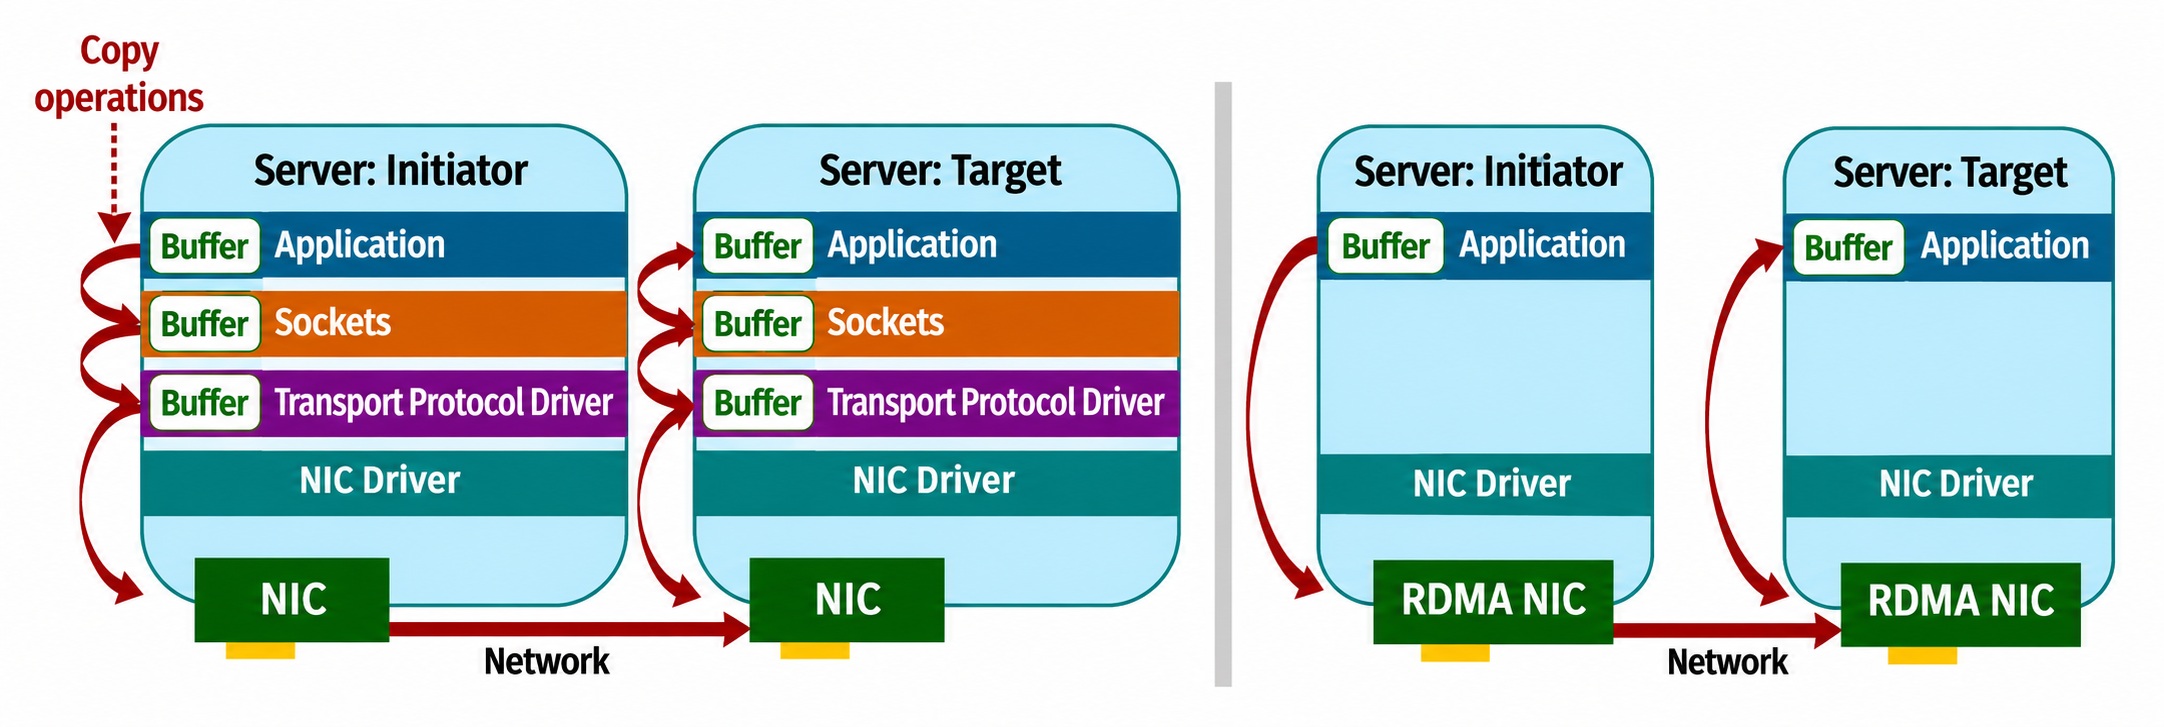
Questa tecnologia si basa sull'accesso diretto alla memoria remota (RDMA). A differenza delle comunicazioni di rete tradizionali che si basano su TCP/IP, RDMA consente ai dispositivi collegati di leggere e scrivere direttamente nella memoria degli altri, bypassando alcuni collegamenti di elaborazione di rete del sistema operativo e della CPU, riducendo così la copia dei dati, abbassando i ritardi di comunicazione e migliorando l'efficienza della trasmissione. RDMA era precedentemente utilizzato principalmente in server e data center ad alte prestazioni, ma questa volta Microsoft lo sta introducendo sui PC Windows consumer.
Microsoft afferma che RDMA su USB4 è implementato utilizzando l'interfaccia NetworkDirect esistente e un nuovo provider software RDMA. I dispositivi compatibili comunicano direttamente tramite USB4 o connessioni Thunderbolt supportate, eliminando la necessità di una scheda di rete RDMA dedicata o di uno switch di rete. I test mostrano una latenza di andata e ritorno compresa tra circa 28 e 50 microsecondi durante la trasmissione di piccoli messaggi, circa quattro volte inferiore rispetto alla tradizionale comunicazione Ethernet su USB4 basata su UDP. Questa bassa latenza viene mantenuta sia con le connessioni a 40 Gbps che a 80 Gbps, sebbene quest'ultima abbia il doppio della larghezza di banda nominale.
Nella dimostrazione reale, Microsoft ha collaborato con AMD per connettere tre mini PC dotati di processore Ryzen AI Max+ 395, scheda grafica Radeon 8060S e memoria unificata da 128 GB attraverso una rete USB4 a 40 Gbps completamente interconnessa. Tre dispositivi hanno eseguito con successo il modello esperto ibrido Qwen3-235B-A22B con 235 miliardi di parametri, raggiungendo una velocità di inferenza di circa 18,5 token al secondo con quantizzazione a 4 bit. I test indipendenti di AMD mostrano che la velocità di decodifica può raggiungere 21,98 token al secondo e la velocità di elaborazione testi tempestiva può raggiungere 117,98 token al secondo.
Intel ha anche condotto una dimostrazione simile utilizzando tre e quattro PC con processori Core Ultra serie 3, 64 GB di memoria e connessioni Thunderbolt 4 che eseguono il modello GPT-OSS-120B. Con una lunghezza del contesto di 1000 token, la velocità è di circa 49,4 token al secondo con tre dispositivi, salendo a 54,2 token al secondo con quattro dispositivi. Vale la pena notare che questo modello da 120 miliardi di parametri non può essere caricato completamente in un singolo PC con 64 GB di memoria, quindi la collaborazione tra più macchine diventa la chiave per eseguire il modello.
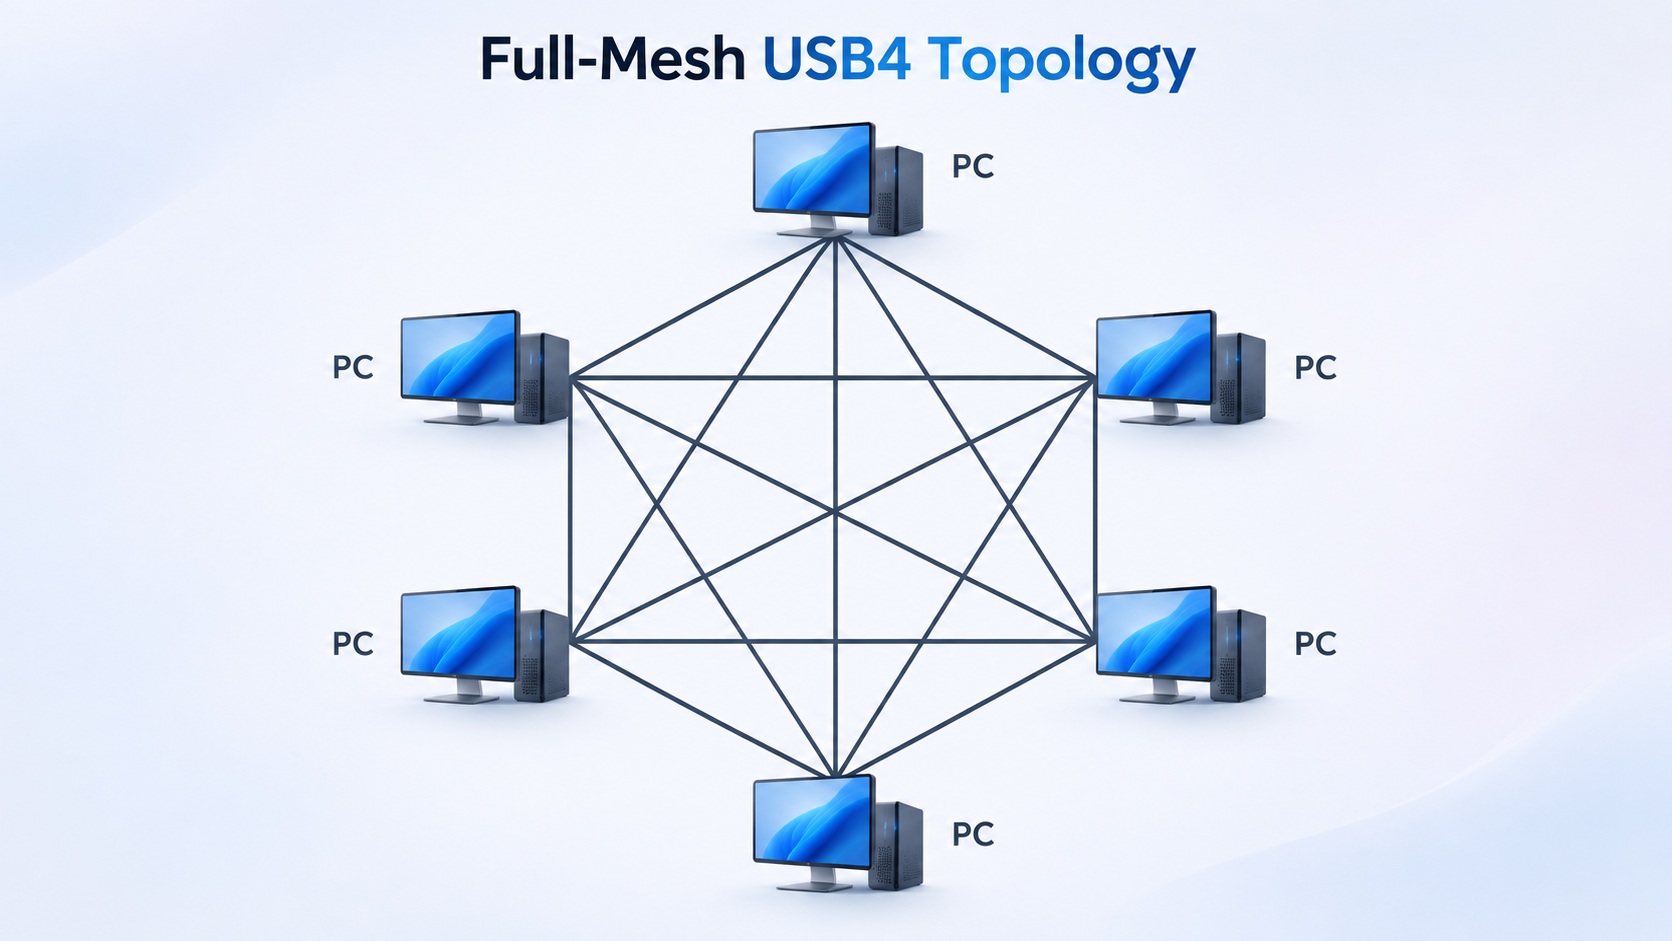
Microsoft ha sottolineato che RDMA su USB4 è ancora in fase sperimentale e presenta requisiti elevati sia per la configurazione hardware che per quella software. I PC partecipanti devono disporre di una connessione USB4 gestita da Windows, preferibilmente a 40 Gbps o superiore. Microsoft consiglia inoltre una topologia full-mesh, in cui ciascun PC è collegato direttamente a tutti gli altri dispositivi, anziché tramite collegamento a margherita, che può ridurre significativamente le prestazioni.
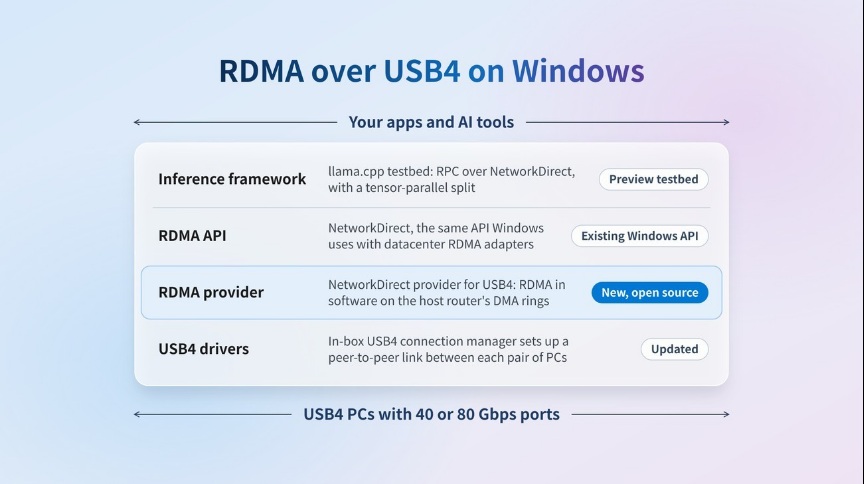
Inoltre, le applicazioni devono supportare esplicitamente l'esecuzione distribuita attraverso un framework conforme. Microsoft ha reso open source il provider NetworkDirect e ha rilasciato un'implementazione modificata di llama.cpp che dimostra la tecnologia. Si prevede che RDMA su USB4 verrà lanciato con una futura versione "Future Platforms" del canale sperimentale di Windows Insider, ma Microsoft non ha ancora annunciato un tempo di rilascio specifico.
Durante la fase di anteprima dello sviluppatore, questa funzionalità è disattivata per impostazione predefinita e deve essere abilitata tramite la configurazione del registro e la firma di test; l'abilitazione della firma di prova potrebbe anche richiedere la disattivazione temporanea dell'avvio protetto. Microsoft consiglia pertanto agli utenti di eseguire test su apparecchiature di sviluppo dedicate anziché sui computer che utilizzano ogni giorno.
Sebbene i tempi ufficiali per un'adozione diffusa siano incerti, se questa tecnologia alla fine verrà realizzata, potrebbe rendere più comune la potente inferenza dell'intelligenza artificiale locale. Gli sviluppatori potrebbero non dover più acquistare costosi server IA dedicati, ma possono combinare le risorse di memoria e GPU di più PC esistenti per eseguire modelli IA locali su larga scala.
Commenti