
Riassunto:
Il fondatore del kernel Linux Linus Torvalds sta sviluppando una soluzione di ottimizzazione delle prestazioni del kernel Linux con l'aiuto dello strumento di programmazione dell'intelligenza artificiale Claude Code.
Questo lavoro mira a un collo di bottiglia delle prestazioni nel meccanismo di gestione della memoria del kernel Linux. L'obiettivo è ridurre la concorrenza causata dal conteggio dei riferimenti alle pagine di memoria quando più thread leggono lo stesso file contemporaneamente, migliorando così l'efficienza di lettura dei file.
Torvalds non solo ha utilizzato l'intelligenza artificiale per assistere nella scrittura del codice, ma ha utilizzato questo strumento anche per scrivere programmi di test, condurre revisioni del codice e redigere note di patch pertinenti.
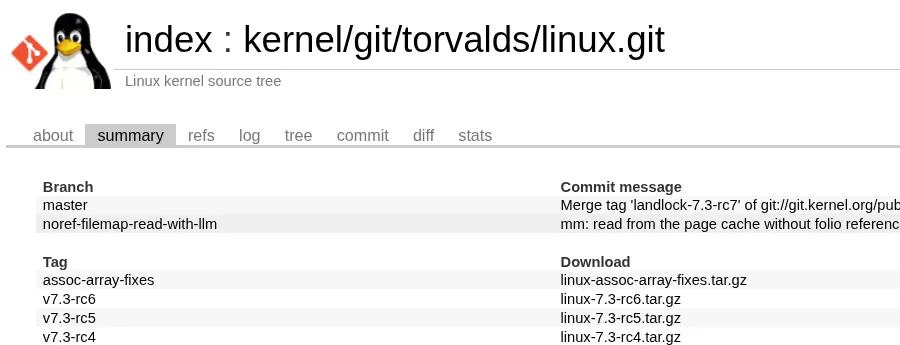
Mentre aspettava il rilascio di Linux 7.3-rc7, Torvalds ha recentemente aggiornato il repository del codice Git del kernel Linux e ha scoperto che nel repository era apparso un nuovo ramo insolito. A differenza della sua pratica abituale di mantenere il ramo principale, questo ramo chiamato "noref-filemap-read-with-llm" è dedicato allo sviluppo di una serie di patch di miglioramento del kernel. Come si può vedere dal LLM nel nome della filiale, questo lavoro è legato alla programmazione assistita da modelli linguistici di grandi dimensioni.
Torvalds ha poi chiarito nelle relative note della patch che questo lavoro è stato completato sotto la sua guida e con l'aiuto di Claude Code. L'intelligenza artificiale non solo ha partecipato all'implementazione del codice, ma ha anche assistito nella scrittura di programmi di test, nella conduzione di revisioni del codice e nella stesura della versione iniziale della documentazione della serie di patch. Le misurazioni delle prestazioni rilevanti sono state effettuate sul computer di Torvalds.
Questa ottimizzazione mira principalmente a un problema specifico nel percorso di lettura dei file del kernel Linux. Quando più thread leggono piccole porzioni di dati dallo stesso file contemporaneamente, possono competere sul conteggio dei riferimenti delle pagine di memoria nella cache delle pagine del file, facendo sì che i thread competano tra loro per le strutture dati correlate, limitando così le prestazioni di lettura.
Per comprendere questo problema, è necessario prima capire come il kernel Linux gestisce la lettura dei file.
Linux utilizzerà la cache delle pagine (Page Cache) per salvare i dati dei file letti dal dispositivo di archiviazione. Quando un programma accede nuovamente al contenuto di un file che è stato memorizzato nella cache, il kernel può spesso fornire i dati direttamente dalla memoria senza dover rivisitare ogni volta il disco o un altro dispositivo di archiviazione. La memorizzazione nella cache delle pagine è quindi un meccanismo importante per Linux per migliorare l'efficienza dell'accesso ai file.
Per gestire questi dati memorizzati nella cache, il kernel deve tenere traccia del ciclo di vita degli oggetti di memoria correlati. Il meccanismo di conteggio dei riferimenti nelle implementazioni tradizionali può aiutare il kernel a determinare se un oggetto di memoria è ancora in uso e quando può rilasciare in sicurezza le risorse correlate.
Tuttavia, quando un numero elevato di thread accede frequentemente allo stesso file, anche se i dati letti sono già in memoria, le operazioni di conteggio dei riferimenti correlate potrebbero comunque comportare un ulteriore sovraccarico di sincronizzazione. In un sistema con processore multi-core, se più thread aggiornano continuamente lo stesso valore di conteggio condiviso, potrebbero verificarsi problemi come un aumento del traffico di coerenza della cache e dei core del processore in attesa l'uno dell'altro.
Per scenari a thread singolo o a bassa concorrenza, questo sovraccarico potrebbe non essere evidente. Ma in server, database, sistemi di build e altri carichi di lavoro altamente simultanei che devono gestire un numero elevato di richieste di lettura di file contemporaneamente, le operazioni di sincronizzazione ricorrenti possono gradualmente diventare un collo di bottiglia delle prestazioni.
La serie di patch che Torvalds sta sviluppando è progettata per ridurre le operazioni di conteggio dei riferimenti non necessarie. L'idea centrale è quella di regolare il percorso di lettura del file in modo che il kernel possa leggere i dati direttamente dalla cache della pagina in determinate condizioni senza dover eseguire le tradizionali operazioni di gestione dei riferimenti al folio per ogni accesso rilevante.
folio qui è una delle astrazioni di base utilizzate dal kernel Linux per gestire un insieme di pagine di memoria contigue o associate. Negli ultimi anni, il kernel Linux ha gradualmente utilizzato il meccanismo folio per sostituire alcuni dei vecchi metodi di gestione a pagina singola al fine di gestire le attività di gestione della memoria in modo più efficiente. Come ridurre il sovraccarico causato dal conteggio dei riferimenti al folio è quindi diventato un compito importante nell'ottimizzazione delle prestazioni del kernel.
Da un punto di vista tecnico, questo tipo di ottimizzazione non elimina semplicemente il conteggio dei riferimenti. Il kernel deve comunque garantire che gli oggetti di memoria non vengano rilasciati prematuramente durante l'accesso e non deve introdurre corruzione dei dati o problemi di sicurezza della memoria riducendo le operazioni di sincronizzazione. Pertanto, le patch devono trovare un equilibrio tra correttezza, sicurezza dell'accesso simultaneo e prestazioni.
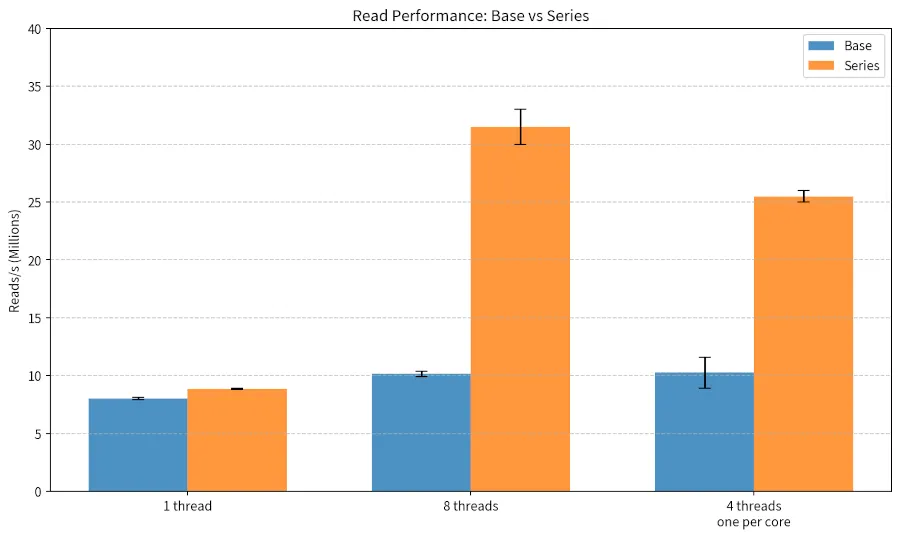
Questa ottimizzazione ha comportato cambiamenti delle prestazioni piuttosto significativi con il carico di lavoro target. Il test si rivolge principalmente allo scenario in cui più thread leggono contemporaneamente piccole porzioni di dati dallo stesso file, il che corrisponde al problema di concorrenza che la patch sta cercando di risolvere.
Tuttavia, questi risultati dovrebbero essere intesi come prestazioni in condizioni di test specifiche, non che tutte le operazioni sui file su Linux riceveranno lo stesso miglioramento. I vantaggi effettivi dipendono dai modelli di accesso dell'applicazione, dal numero di thread, dalle dimensioni dei file, dal dispositivo di archiviazione, dalla configurazione della memoria e da altri fattori di sistema. Gli effetti di ottimizzazione potrebbero essere limitati per i carichi di lavoro che non comportano gli stessi problemi di conflitto.
Attualmente, queste patch sono ancora archiviate nel ramo Git personale di Torvalds e non si può concludere che siano entrate ufficialmente nel kernel principale di Linux. Se verrà accorpato in futuro e quale metodo di attuazione verrà adottato alla fine richiede un'ulteriore osservazione.
Secondo l'attuale ritmo di sviluppo, questa serie di patch potrebbe entrare in ulteriore fase di discussione o revisione durante la prossima finestra di fusione di Linux 7.4, ma se alla fine potrà essere unita dipende ancora dalla revisione del codice, dai risultati dei test e dal giudizio del manutentore.
Vale la pena notare che l'uso di Claude Code da parte di Torvalds non è il suo primo tentativo di utilizzare l'intelligenza artificiale per gestire il lavoro di sviluppo relativo a Linux.
In precedenza, ha parlato dell'utilizzo del debugging del kernel assistito dall'intelligenza artificiale e ha provato strumenti di programmazione AI come Google Antigravity al di fuori del kernel Linux. Per Torvalds, l’intelligenza artificiale non significa sostituire gli sviluppatori come decisori indipendenti, ma piuttosto uno strumento di sviluppo che può essere utilizzato con obiettivi chiari e supervisione umana.
Da quest'anno, gli strumenti di programmazione dell'intelligenza artificiale stanno gradualmente entrando nel processo di sviluppo di software open source. Sempre più sviluppatori sfruttano modelli linguistici di grandi dimensioni per analizzare codice, individuare bug, scrivere test e generare patch iniziali. La comunità del kernel Linux sta inoltre riscontrando un numero crescente di codici assistiti dall'intelligenza artificiale e segnalazioni di bug.
Questa tendenza comporta sia opportunità che sfide. Da un lato, l’intelligenza artificiale può aiutare gli sviluppatori esperti a esplorare più velocemente percorsi di codice complessi, a trovare idee di ottimizzazione e a ridurre il tempo necessario per scrivere codice ripetitivo. D'altra parte, un gran numero di patch e segnalazioni di bug generati automaticamente aumentano anche il carico di revisione sui manutentori, e alcuni dei contributi potrebbero avere problemi di bassa qualità, invii duplicati o mancanza di valore effettivo.
Torvalds ha già dichiarato pubblicamente in passato di ritenere che l'intelligenza artificiale sia uno strumento utile, ma che la comunità del kernel deve affrontare la pressione lavorativa causata dal rapido aumento dei contenuti generati dall'intelligenza artificiale. Non sostiene il rifiuto del codice solo perché utilizza l’intelligenza artificiale, ma presta maggiore attenzione alla qualità, alla correttezza e all’effetto reale del codice finale.
Il progetto di ottimizzazione del kernel a cui Claude Code ha partecipato questa volta riflette un metodo applicativo più specifico di sviluppo assistito dall'intelligenza artificiale: gli sviluppatori che hanno familiarità con i meccanismi interni del kernel identificano i problemi, propongono indicazioni di ottimizzazione e supervisionano l'implementazione, quindi verificano i risultati attraverso test e revisione del codice.
A differenza del fatto di affidarsi esclusivamente all'intelligenza artificiale per generare automaticamente l'intero progetto software, lo sviluppo del kernel Linux prevede meccanismi di concorrenza complessi, requisiti di sicurezza della memoria e comportamento dell'hardware. Qualsiasi modifica apparentemente semplice può influenzare un gran numero di applicazioni e diverse piattaforme hardware. Pertanto, anche se l’intelligenza artificiale può aiutare a generare codice, gli sviluppatori devono comunque capirne il funzionamento e assumersi la responsabilità dell’implementazione finale.
Se questo insieme di patch supererà finalmente la revisione e entrerà nella linea principale di Linux, diventerà un altro caso di sviluppo assistito dall'intelligenza artificiale che partecipa all'ottimizzazione del software di sistema sottostante. Il suo valore risiede non solo nei miglioramenti prestazionali che possono essere ottenuti in scenari specifici, ma anche nel dimostrare come modelli linguistici di grandi dimensioni possano assistere ingegneri esperti nell'analisi e nel miglioramento di sistemi complessi.
Con il continuo sviluppo degli strumenti di programmazione IA, in futuro potrebbero essere presenti lavori più simili nel kernel Linux e in altri grandi progetti open source. Tuttavia, ciò che determinerà se questi risultati potranno effettivamente essere implementati sarà comunque una rigorosa verifica tecnica, la revisione della comunità e i requisiti a lungo termine per la stabilità del sistema.
Commenti