
Riassunto:
Il fondatore di Linux Linus Torvalds sta esplorando ulteriormente l'applicazione degli strumenti di programmazione dell'intelligenza artificiale nello sviluppo del kernel. Dopo aver recentemente sviluppato una patch per l'ottimizzazione delle prestazioni del kernel Linux con l'aiuto di Claude Code di Anthropic, Torvalds ha utilizzato un LLM (Large Language Model) per analizzare un pezzo di codice del kernel che era stato difficile da comprendere per molto tempo. Non solo ha confermato un difetto segnalato in precedenza dallo sviluppatore, ma ha anche scoperto altre tre vulnerabilità rimaste dormienti per più di dieci anni. Questi problemi sono tutti legati all'implementazione dell'array associativo nel kernel Linux.
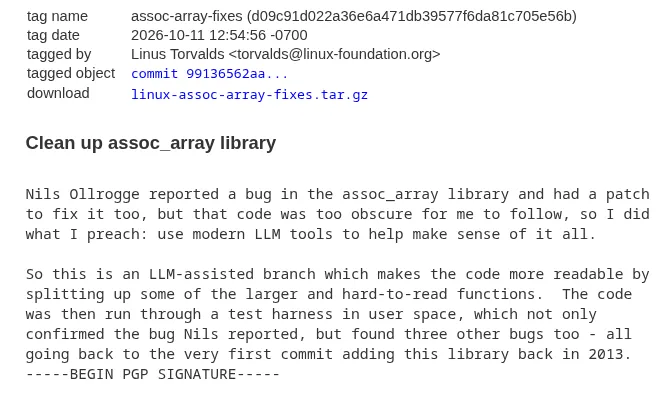
Secondo un rapporto pubblicato da Phoronix il 12 ottobre, Torvalds ha recentemente aggiunto un tag Git chiamato "assoc-array-fixes" al suo repository di codice del kernel Linux per organizzare e contrassegnare una serie di riparazioni al codice dell'array associativo. Questo lavoro è indipendente dal suo precedente progetto di utilizzo di Claude Code per ottimizzare le prestazioni di lettura dei file, ma entrambi riflettono i suoi tentativi di introdurre strumenti di intelligenza artificiale nel complesso processo di sviluppo del kernel.
La causa di questo lavoro è che lo sviluppatore Nils Ollrogge ha segnalato un bug nella libreria degli array associativi e ha inviato una patch di correzione corrispondente. Tuttavia, quando Torvalds esaminò la patch, scoprì che l'implementazione del codice in questione era troppo oscura per comprenderne direttamente la logica specifica, quindi era impossibile giudicare facilmente se la patch risolvesse correttamente il problema.
Di fronte a questa situazione, Torvalds ha scelto di utilizzare modelli linguistici moderni su larga scala per assistere l'analisi. Ha scritto nella descrizione del tag Git che questa volta ha adottato l'approccio che aveva sostenuto in precedenza, ovvero utilizzare i moderni strumenti LLM per aiutare a comprendere il codice complesso.
Torvalds ha quindi organizzato una serie di patch con modifiche assistite dall'intelligenza artificiale per suddividere alcune funzioni grandi e difficili da leggere in una struttura più chiara, rendendo la logica del codice più facile da comprendere e rivedere. Vale la pena notare che l’obiettivo di questo lavoro non è semplicemente lasciare che l’IA riscriva l’intera implementazione dell’array associativo, ma migliorare prima la leggibilità del codice esistente e poi verificare tramite test se il suo comportamento è quello previsto.
Dopo aver completato la modifica, anche il codice pertinente è stato inserito nel framework di test dello spazio utente per essere eseguito. I test non solo hanno confermato che il bug originariamente segnalato da Olrog era effettivamente presente, ma hanno anche scoperto tre ulteriori problemi.
Ancora più preoccupante è che questi difetti non sono problemi nuovi introdotti di recente. Secondo Torvalds, le tre ulteriori vulnerabilità scoperte risalgono al 2013, quando la libreria di array associativi fu introdotta per la prima volta nel kernel Linux. In altre parole, sono rimasti nascosti nel codice per più di un decennio, senza essere completamente rilevati dai test pertinenti.
L'array associativo nel kernel Linux è una struttura dati utilizzata per organizzare e recuperare i dati in base al valore chiave. A differenza degli array ordinari che accedono agli elementi tramite pedici interi, gli array associativi possono trovare dati corrispondenti in base a chiavi specifiche, quindi sono adatti per scenari che richiedono indicizzazione e gestione flessibile degli oggetti.
L'implementazione dell'array associativo nel kernel Linux soddisfa le esigenze di gestione dei dati all'interno del kernel. Poiché il codice del kernel deve essere eseguito rispettando rigorosi requisiti di prestazioni, sicurezza della memoria e accesso simultaneo, l'implementazione di tali componenti di base è spesso più complessa di codice simile nelle applicazioni ordinarie. Anche se una funzione esegue apparentemente solo l'inserimento, la cancellazione o la ricerca di dati, può comportare la regolazione della struttura ad albero, la gestione del ciclo di vita dei nodi e varie condizioni al contorno.
La mancanza di una struttura chiara in questo tipo di codice rende più difficile per i manutentori comprenderne il comportamento. Gli sviluppatori non devono solo confermare la logica operativa in circostanze normali, ma devono anche analizzare input anomali, stati speciali della struttura dei dati e problemi che possono verificarsi quando vengono eseguite più operazioni ininterrottamente.
Mentre il codice continua ad evolversi, i difetti che non vengono facilmente rilevati nelle prime implementazioni potrebbero persistere a lungo. Soprattutto nelle strutture dati complesse, alcuni errori verranno scoperti solo in sequenze operative specifiche o stati strutturali speciali, e i test ordinari potrebbero non necessariamente coprire tutte le situazioni.
L'idea adottata in questo lavoro assistito dall'intelligenza artificiale è quella di suddividere innanzitutto funzioni di grandi dimensioni difficili da comprendere in parti più facili da analizzare, quindi verificare la logica pertinente attraverso un programma di test indipendente. Una struttura del codice più chiara aiuta gli sviluppatori a identificare la relazione tra le diverse operazioni e rende anche più semplice per gli strumenti di test creare condizioni di verifica per comportamenti specifici.
Tuttavia, le tre vulnerabilità scoperte questa volta non possono essere semplicemente attribuite alla capacità dell'intelligenza artificiale di comprendere programmi che vanno oltre gli esseri umani. Più precisamente, il refactoring del codice assistito dall'intelligenza artificiale, le revisioni degli sviluppatori e i framework di test lavorano tutti insieme. I modelli linguistici di grandi dimensioni possono aiutare a organizzare la logica del codice e identificare potenziali problemi, ma alla fine è ancora necessario confermare se i difetti sono reali attraverso l’esecuzione effettiva e test ripetibili.
La particolarità di questo caso è che l'intelligenza artificiale non solo ha partecipato all'analisi del codice, ma ha anche aiutato Torvalds a superare le barriere di comprensione durante il processo di revisione delle patch. Per gli sviluppatori che gestiscono grandi progetti open source, questo può essere un metodo di lavoro di valore pratico: quando il codice è troppo complesso ed è difficile per i manutentori giudicare rapidamente se il piano di riparazione è corretto, l'intelligenza artificiale può essere utilizzata per aiutare a sistemare la struttura del codice, e quindi le conclusioni possono essere verificate attraverso test e revisione manuale.
Attualmente, questo insieme di correzioni per gli array associativi non è stato ancora integrato nella linea principale del kernel Linux. Secondo i rapporti di Phoronix, il lavoro correlato dovrebbe essere ulteriormente avanzato durante la prossima finestra di fusione di Linux 7.4, ma se la fusione finale dipenderà ancora dai risultati delle successive revisioni e test del codice.
Vale la pena notare che questa non è la prima volta che Torvalds ha recentemente dimostrato pubblicamente l'uso dell'intelligenza artificiale nello sviluppo del kernel Linux.
In precedenza, ha utilizzato Claude Code per svolgere un altro lavoro di ottimizzazione del kernel. L'obiettivo era risolvere il problema della concorrenza causato dall'operazione di conteggio dei riferimenti alle pagine di memoria quando più thread leggono lo stesso file contemporaneamente. La patch pertinente tenta di ridurre le operazioni di conteggio dei riferimenti non necessarie regolando il percorso di lettura del file, migliorando così le prestazioni di lettura con carichi di lavoro specifici.
In questo lavoro, l'intelligenza artificiale ha partecipato alla scrittura iniziale del codice, allo sviluppo del programma di test, alla revisione del codice e alla stesura dei documenti delle note sulla patch. Torvalds è responsabile della determinazione delle direzioni di ottimizzazione, della supervisione del processo di sviluppo e della misurazione delle prestazioni sul proprio computer.
Gli obiettivi tecnici delle due attività sono diversi, ma incarnano un modello di sviluppo simile: gli ingegneri che hanno familiarità con il kernel determinano il problema, quindi utilizzano l'intelligenza artificiale per comprendere implementazioni complesse, scrivere o modificare il codice e infine verificare i risultati tramite test.
Questo modello può essere particolarmente utile per progetti open source su larga scala e con cicli di manutenzione lunghi come Linux. Il codice del kernel ha continuato ad evolversi nel corso di decenni e contiene un'ampia storia di implementazione e complessi requisiti di compatibilità. Anche i manutentori esperti non possono sempre avere familiarità con tutti i dettagli di ciascun sottosistema.
La revisione del codice tradizionale si affida principalmente agli sviluppatori per leggere il codice, analizzare la logica e progettare test. Gli strumenti di intelligenza artificiale hanno l'opportunità di aiutare i manutentori a risolvere più velocemente il codice non familiare, spiegare la relazione tra le funzioni, proporre possibili condizioni al contorno e assistere nella generazione di casi di test. Non sostituiscono la revisione professionale, ma dovrebbero ridurre il tempo necessario per comprendere un codice complesso.
Allo stesso tempo, anche il codice generato dall'intelligenza artificiale presenta dei limiti. I modelli linguistici di grandi dimensioni possono fraintendere flussi di controllo complessi, ignorare rare condizioni al contorno o proporre modifiche che appaiono ragionevoli ma che in realtà non garantiscono la correttezza. Per i kernel del sistema operativo, questi problemi sono particolarmente importanti perché gli errori di codice possono influire sulla stabilità del sistema, sulla sicurezza della memoria e persino sul funzionamento affidabile dell'intero sistema.
Pertanto, la partecipazione dell'intelligenza artificiale allo sviluppo del kernel non significa che i requisiti di revisione possano essere allentati. Invece, il refactoring del codice, i test automatizzati, la revisione delle patch e la verifica effettiva rimangono fondamentali per garantire la qualità delle modifiche. Il progetto della matrice associativa è stato in grado di scoprire problemi di vecchia data, il che dimostra semplicemente che gli strumenti di intelligenza artificiale devono essere combinati con rigorosi processi di verifica ingegneristica per essere efficaci.
Torvalds ha sempre avuto un atteggiamento pragmatico nei confronti degli strumenti di programmazione dell'intelligenza artificiale. Ha riconosciuto il valore dell'intelligenza artificiale per aiutare nel processo di sviluppo, ma non ha sostenuto che gli sviluppatori dovessero accettare il codice generato dalla macchina senza revisione. Questa volta ha dichiarato pubblicamente di utilizzare LLM per analizzare il codice, il che ha ulteriormente dimostrato che l'intelligenza artificiale sta diventando un'opzione ausiliaria negli strumenti di sviluppo del kernel.
Più in generale, l'incidente mette in luce anche una difficoltà di lunga data nella gestione di grandi progetti software: il codice non deve solo funzionare correttamente, ma deve anche essere comprensibile ai futuri sviluppatori. Per il software di base mantenuto per più di dieci anni o addirittura decenni, la leggibilità stessa è un fattore importante che influisce sull'affidabilità.
Questa modifica migliora la struttura del codice suddividendo funzioni complesse e utilizza i test per scoprire problemi precedentemente trascurati, dimostrando la stretta connessione tra leggibilità del codice e risoluzione dei problemi dei difetti. Quando la logica del programma è più chiara, è più facile per gli sviluppatori identificare potenziali percorsi di errore e creare test che coprano i comportamenti rilevanti.
Se questo insieme di patch alla fine entrerà nella linea principale di Linux, la sua importanza non solo risolverà i quattro problemi identificati, ma fornirà anche una base di codice più chiara per la successiva manutenzione.
Con il continuo sviluppo degli strumenti di programmazione dell'intelligenza artificiale, in futuro potrebbero verificarsi altri casi simili in grandi progetti open source. Tuttavia, per i software di base chiave come il kernel Linux, ciò che determina realmente se lo sviluppo assistito dall’intelligenza artificiale può ottenere un riconoscimento a lungo termine è se la patch può superare una revisione rigorosa, se il test può riprodurre il problema e se il codice finale è sufficientemente affidabile.
Questa volta l'intelligenza artificiale non si è sostituita al fondatore di Linux nel dare il giudizio finale, ma lo ha aiutato a comprendere il codice originariamente difficile da rivedere e a portare alla luce ulteriori difetti nascosti per molti anni. Per l’ingegneria del software matura, questa potrebbe essere una delle direzioni applicative più pratiche dell’intelligenza artificiale.
Commenti