
Riassunto:
Ieri, DeepSeek ha reso direttamente open source la propria tecnologia "macchina per stampare denaro" che si trova sotto la scatola. Hanno pubblicato un blog tecnico intitolato "DeepSeek V4.1 Flash Large-scale Inference Deployment Practice" e hanno opportunamente creato il framework di inferenza del servizio cloud "DeepInfer" che supporta le proprie decine di miliardi di chiamate online, insieme al componente di segmentazione delle parole a livello di produzione "deepseek-recipe", completamente open source secondo il protocollo Apache 2.0.
Nel blog si afferma anche che in futuro il codice di inferenza e la conseguente ottimizzazione delle prestazioni del nuovo modello di DeepSeek continueranno a essere forniti al mondo in DeepInfer.
L'area aperta e luminosa non è di prim'ordine.
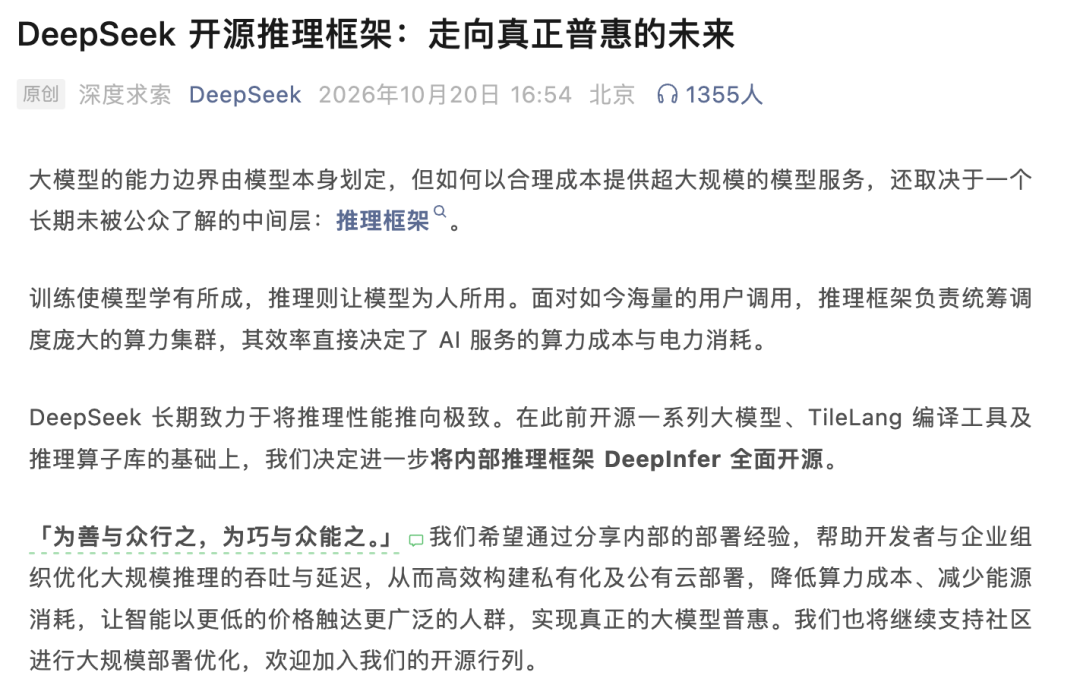
"Fai ciò che è bene e fallo per tutti, fallo con abilità e tutti possono farlo." Rendere l’intelligenza artificiale accessibile a più persone significa anche dare l’opportunità ad amici e uomini d’affari di vendere l’intelligenza artificiale a un prezzo più basso.
Possiamo innanzitutto calcolare in dettaglio quanto sia prezioso questo set di codici che DeepSeek ha fornito gratuitamente a tutta l'umanità questa volta. Sulla base di questo nuovo framework DeepInfer open source, l'attuale throughput del servizio di DeepSeek in un singolo cluster ha raggiunto 155 trilioni di token al giorno.
Anche se calcolato interamente in base al prezzo più basso, il ricavo complessivo di questo sistema ammonta a 38 dollari USA per carta all'ora, che equivalgono a circa 253 yuan in RMB.
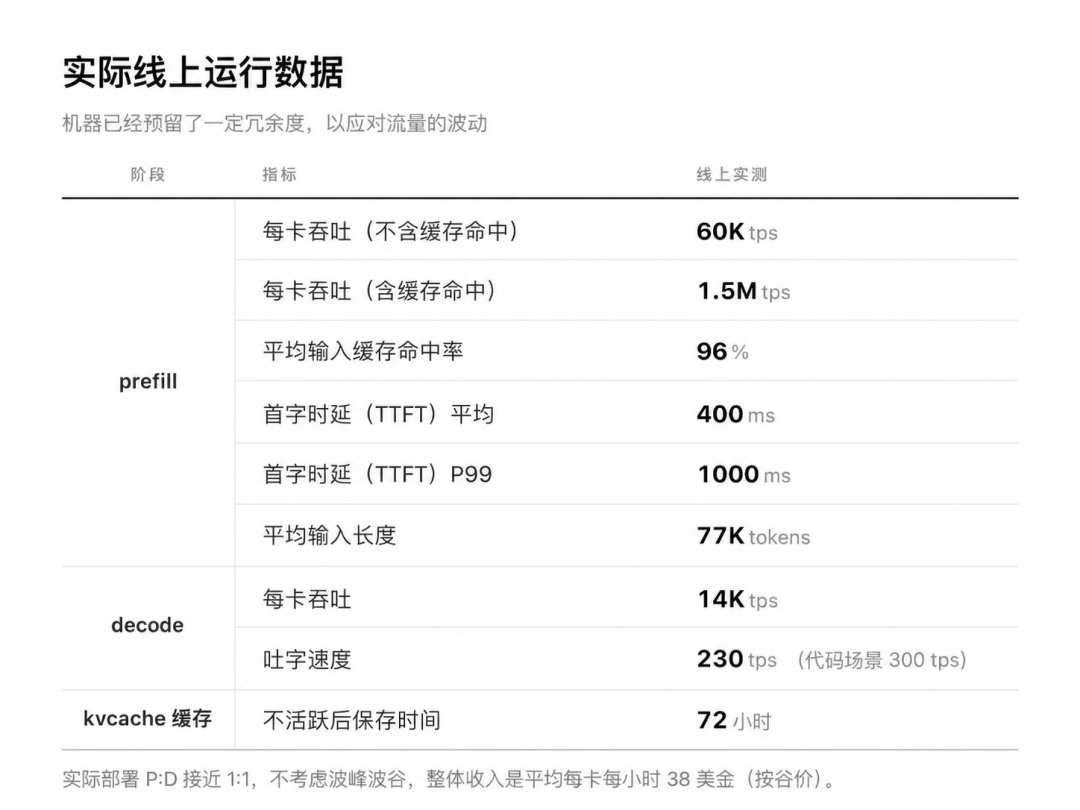
In altre parole, le monete d'oro guadagnate utilizzando una scheda nella sala computer per un'ora sono superiori alla paga oraria dei normali lavoratori. Inoltre, la carta non permette di bere cibo americano ghiacciato, non prende ferie annuali retribuite e stampa denaro in modo folle per DeepSeek nella sala computer 24 ore al giorno.
Una macchina per la stampa di denaro in senso fisico.
Perché suggerisco che i produttori di infrastrutture del settore terzo debbano fornire a DeepSeek una vera fonte di supporto, perché non solo gli insegnano a pescare, ma gli insegnano anche a pescare.
In passato, i cosiddetti modelli open source del settore fornivano solo file di peso del modello. Per quanto riguarda come ottenere un throughput elevato in un ambiente di produzione e come ridurre la latenza, erano tutti nascosti in scatole nere closed-source come segreti commerciali.
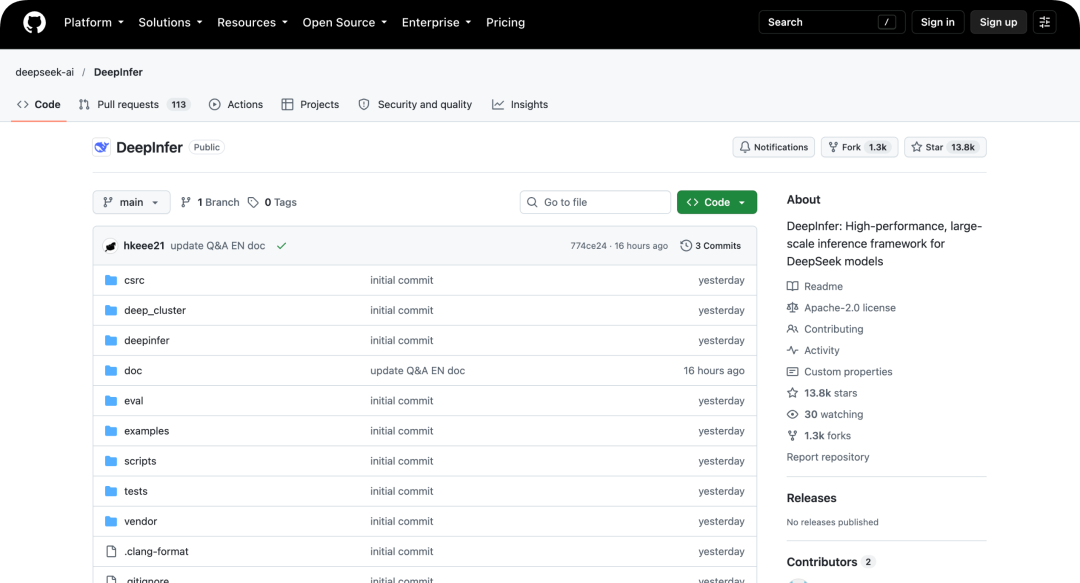
Indirizzo open source di DeepInfer: https://github.com/deepseek-ai/DeepInfer
indirizzo open source di deepseek-recipe: https://github.com/deepseek-ai/deepseek-recipe
Di conseguenza, piccoli fornitori o aziende di computer di secondo e terzo livello hanno acquistato un sacco di carte e le hanno distribuite autonomamente. Il tasso di utilizzo della potenza di calcolo era ridicolmente basso. I soldi ricavati dalla vendita dei token non bastavano nemmeno a pagare la bolletta elettrica della sala computer. Hanno dovuto annaffiare segretamente i gettoni, utilizzando segretamente modelli più economici o limitando segretamente le specifiche.
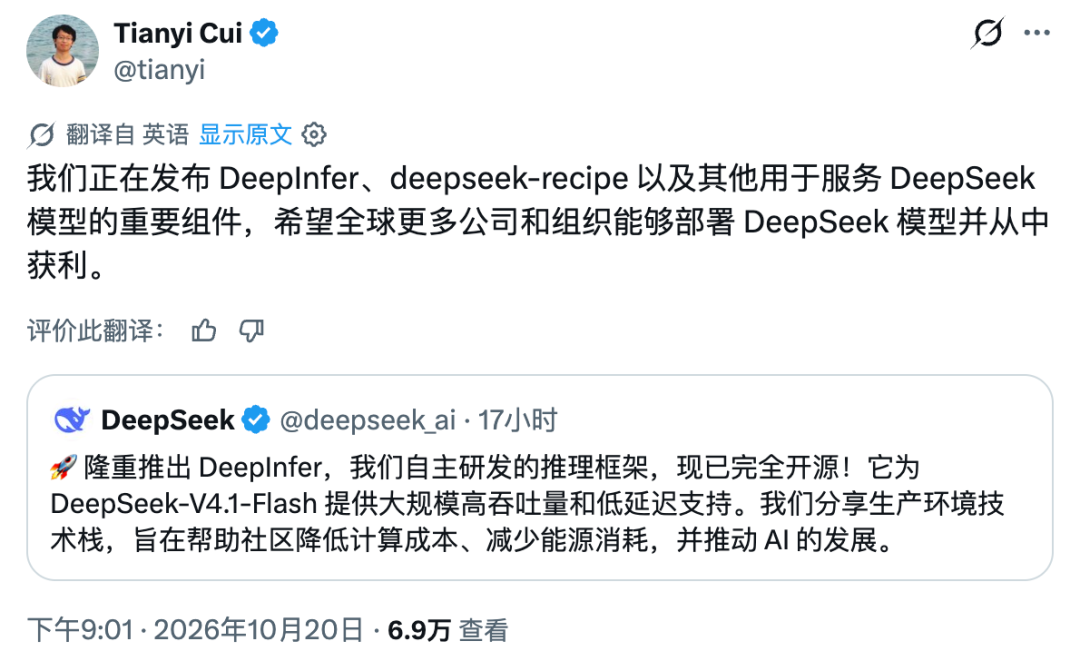
Questa volta, Cui Tianyi, il responsabile di DeepSeek Harness, ha parlato in modo molto onesto di X. Aprendo DeepInfer e deepseek-recipe, spera che le aziende e le istituzioni di tutto il mondo possano implementare i modelli DeepSeek e guadagnare denaro reale da queste cose.
Cyber Living Bodhisattva appartiene a Yes.
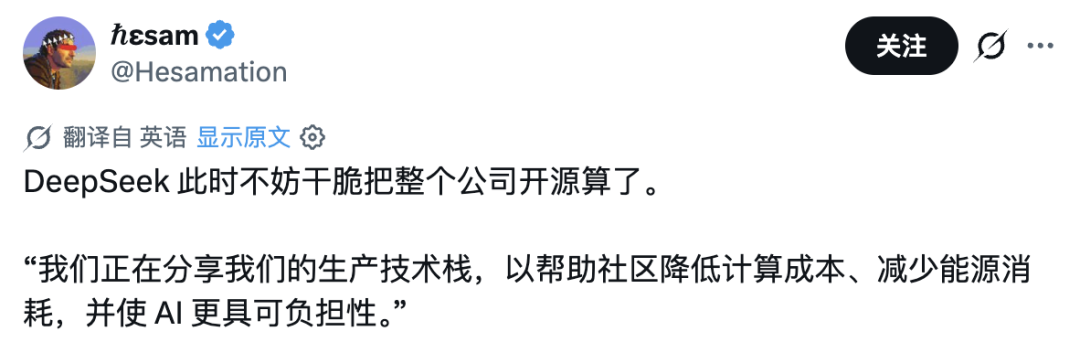
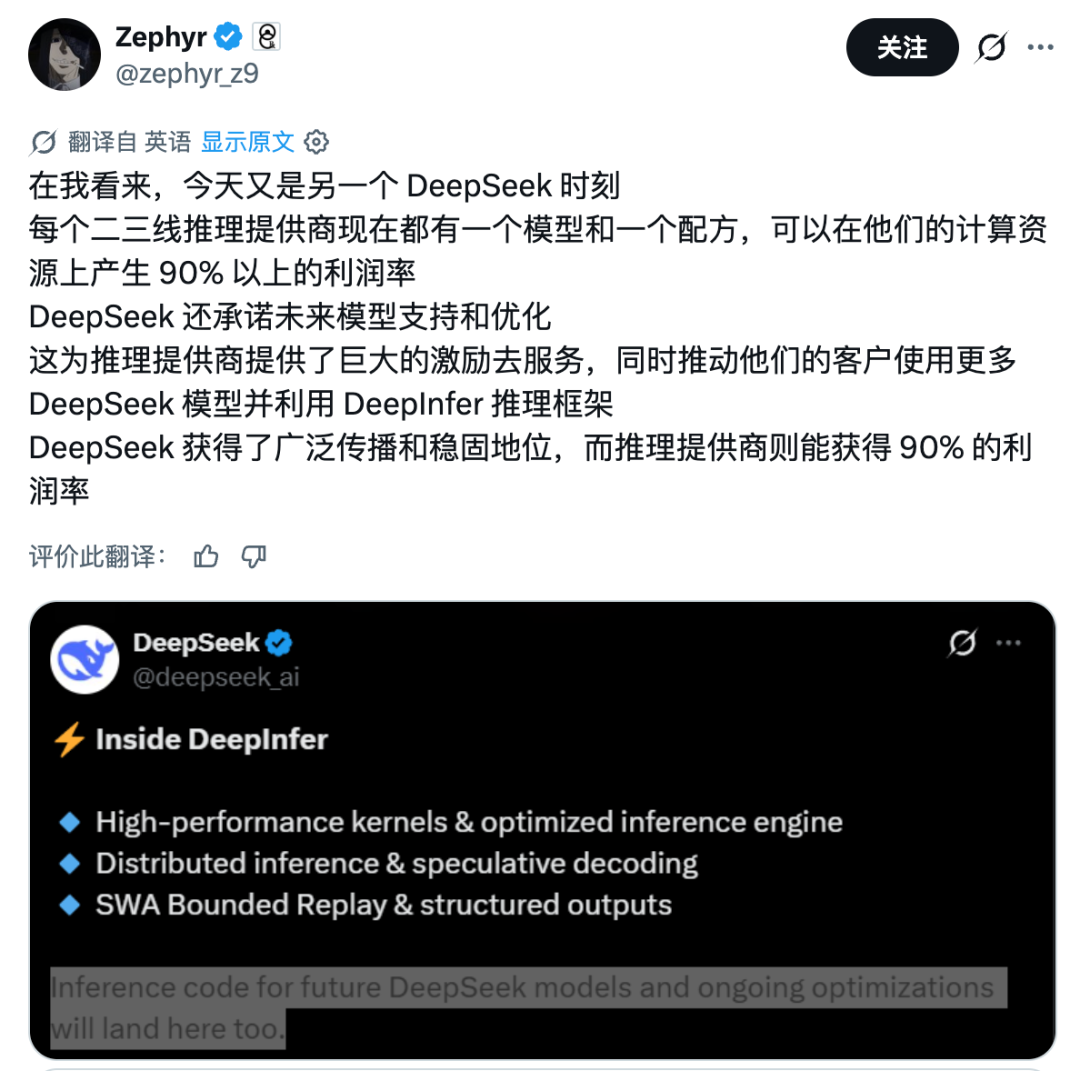
Netizen Zephyr ha fatto alcuni calcoli e ha detto che oggi è semplicemente un altro momento di DeepSeek, perché ora qualsiasi fornitore di servizi di inferenza di secondo o terzo livello sul pianeta può realizzare un sorprendente profitto lordo di oltre il 90% sulla propria potenza di calcolo utilizzando questo insieme di modelli e formule già pronti.
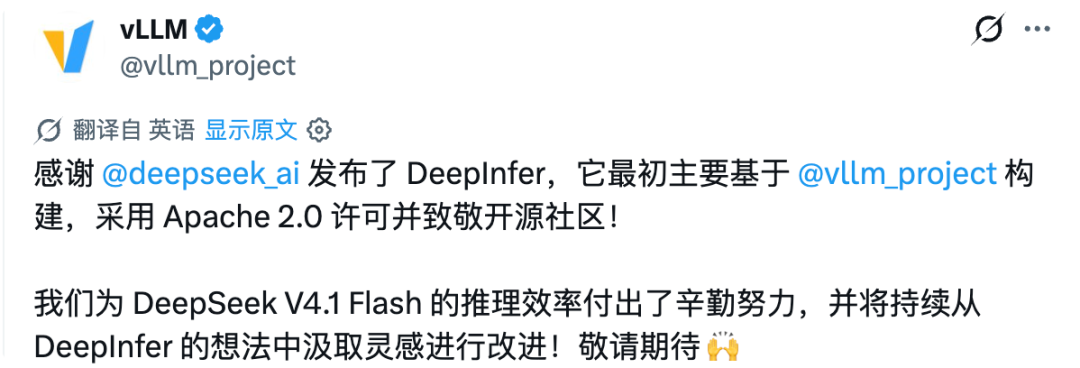
Persino l'account ufficiale di vLLM, il fratello maggiore dell'inferenza open source, è uscito da un giorno all'altro per pubblicare un ringraziamento, ringraziando DeepSeek per aver restituito DeepInfer, originariamente creato sulla base di vLLM, alla comunità open source utilizzando il protocollo Apache 2.0 più flessibile.
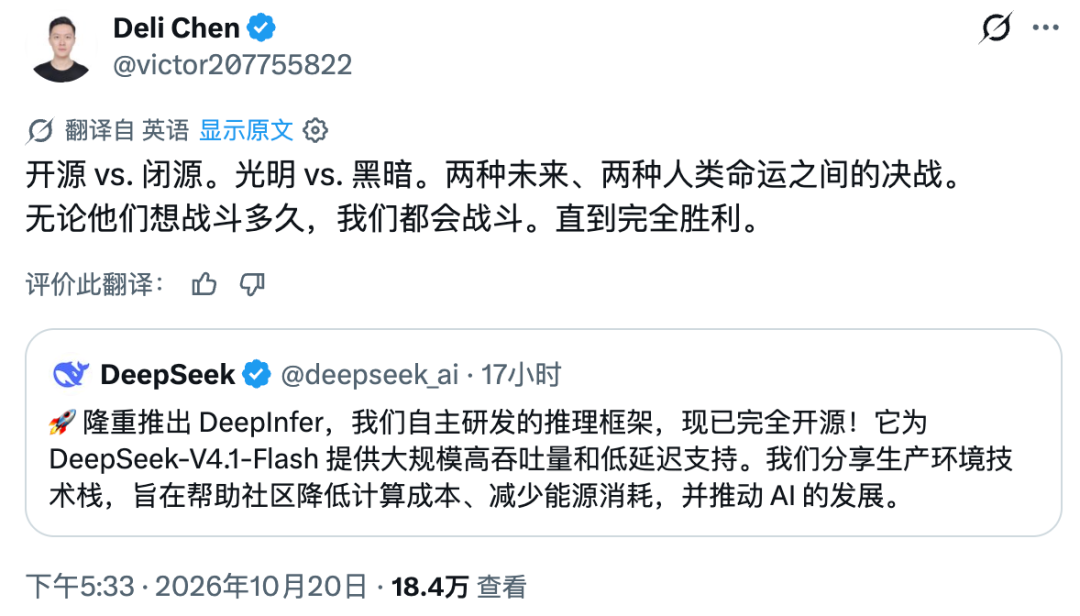
Il ricercatore di DeepSeek Deli Chen è ancora più entusiasta di X. Per dirla senza mezzi termini, questa è la battaglia decisiva del destino umano tra open source e closed source, luce e oscurità. Non importa per quanto tempo l'avversario vorrà combattere, noi resteremo con te fino alla vittoria completa.
Inoltre, se dai un'occhiata al blog tecnico di DeepSeek, scoprirai che la loro fiducia deriva dalla loro ossessione ingegneristica di spremere ogni goccia di memoria grafica.
Fin dal primo giorno di progettazione, questo sistema ha un'ampia compatibilità hardware, utilizzando comuni macchine da 8 carte per la precompilazione e super nodi da 64 a 128 carte per la decodifica.
La cosa più impressionante è il suggerimento di implementazione del Vision Encoder contenuto nel documento. Le parole originali dell'ingegnere scrivevano: "In generale, è sufficiente l'utilizzo di una sola carta. Si consiglia di utilizzare la carta più economica all'interno della gamma disponibile".
No, i miei colleghi sono impegnati a dire agli investitori che non utilizzano carte di punta non di prima qualità. I documenti ufficiali di DeepSeek ti insegnano come accontentarti della carta più economica nell'angolo della sala computer. Sei diligente e frugale come il mio padrone di casa nel Guangdong.
Essere avari fino all'estremo è arte.
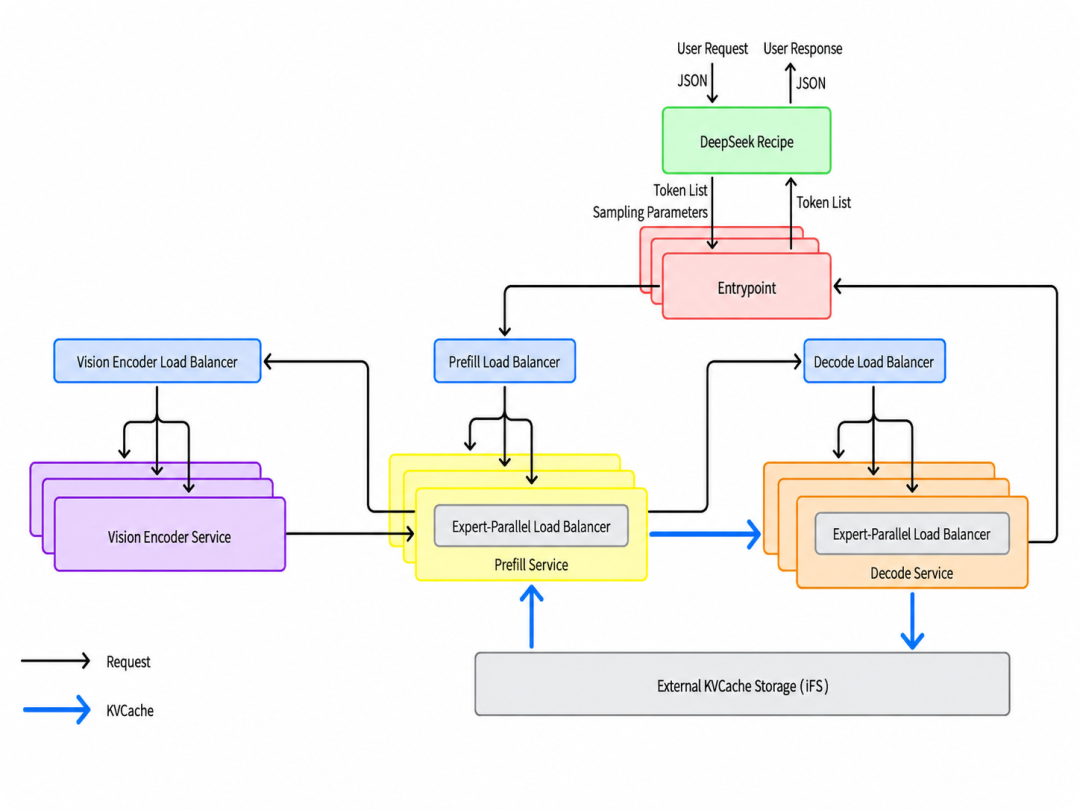
Per permetterti di inviare il maggior numero di token con la minima bolletta elettrica, DeepSeek ha anche svelato alcuni segreti unici.
Ad esempio, gli agenti e le conversazioni di testo lunghe stanno diventando sempre più popolari ora. Ogni volta che la precompilazione viene ricalcolata, costa denaro reale. DeepSeek ha creato direttamente un cluster di archiviazione distribuito 3FS con una capacità di 100 PiB per conservare il traffico KVCache dell'agente per più di 72 ore e il traffico di Chatbot viene salvato per 7 giorni.
L'archiviazione a lungo termine non è sufficiente. Utilizzano schede di rete RDMA e tecnologia GDR per aumentare la larghezza di banda di lettura aggregata fino a un sorprendente 10 TiB al secondo. Quando si passa dall'hard disk alla memoria video, si sovrappone al calcolo in avanti e non occupa nemmeno l'unità di calcolo SM della GPU.
Anche nell'iterazione dalla V4 alla V4.1, gli ingegneri hanno scoperto che la scrittura della cache a finestra scorrevole di livello minuto SWA KVCache nel disco rigido occupava troppo spazio e il rapporto costo-efficacia dello storage era estremamente basso. Hanno semplicemente inventato la tecnologia SWA Bounded Replay, che ha ricalcolato solo gli ultimi 128 token e alla fine ha dimezzato l'importo totale del calcolo della precompilazione.
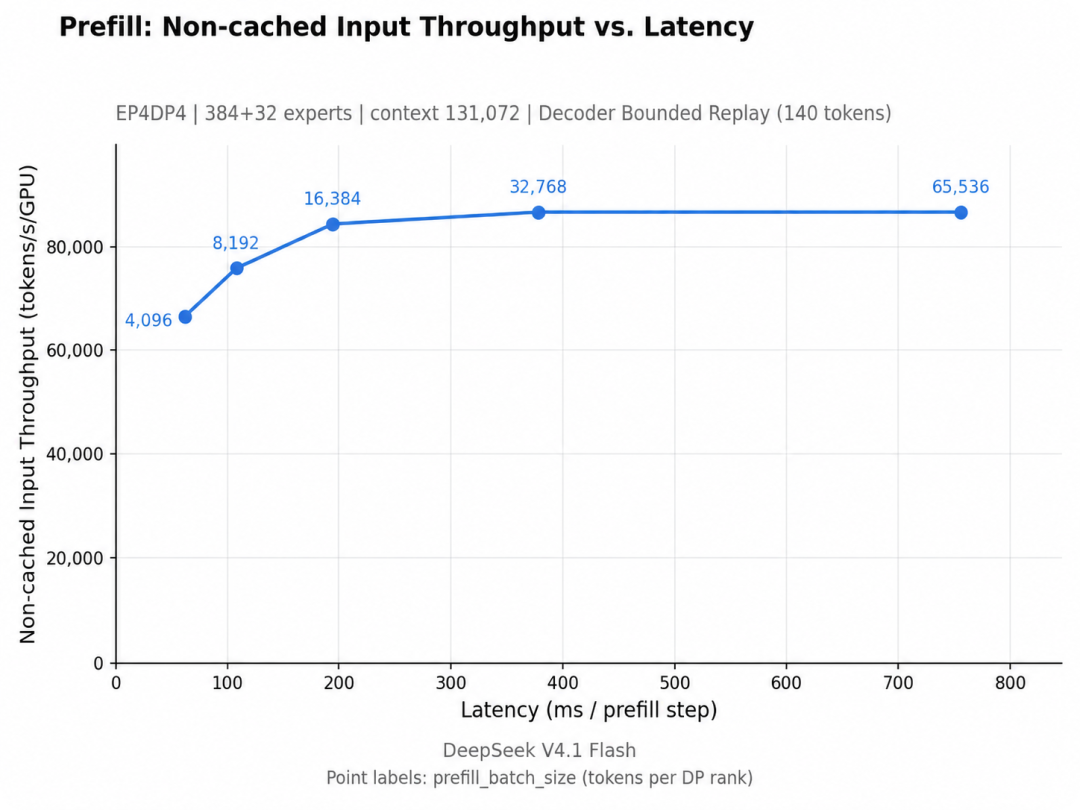
Specifico per il test delle prestazioni di Prefill, all'aumentare del numero di token elaborati in ciascun batch, la velocità di input della miss cache aumenta gradualmente e alla fine si stabilizza. Continuare ad espandere il lotto aumenta principalmente il dispendio di tempo dell'elaborazione in una sola fase.
Puro artigiano, fratello.
Guardando la ricetta deepseek del componente Rust open source sincrono, risolve tutto il lavoro sporco di cui gli sviluppatori devono preoccuparsi ogni giorno nell'ambiente di produzione.
Unifica i tre protocolli API di Completamenti chat, Risposte e Messaggi di Anthropic di OpenAI nello stesso formato. Utilizza inoltre la codifica parallela segmentata per risolvere i ritardi di segmentazione delle parole di testo lunghe e blocca gli attacchi di iniezione di token speciali dal basso.
Per quanto riguarda la pianificazione sottostante, attraverso la sovrapposizione delle pipeline asincrone della GPU e della CPU, la GPU è completamente inattiva durante l'intero processo. Anche la decodifica speculativa DSpark utilizza la verifica a lunghezza variabile e il rendimento è migliorato del 6% online.
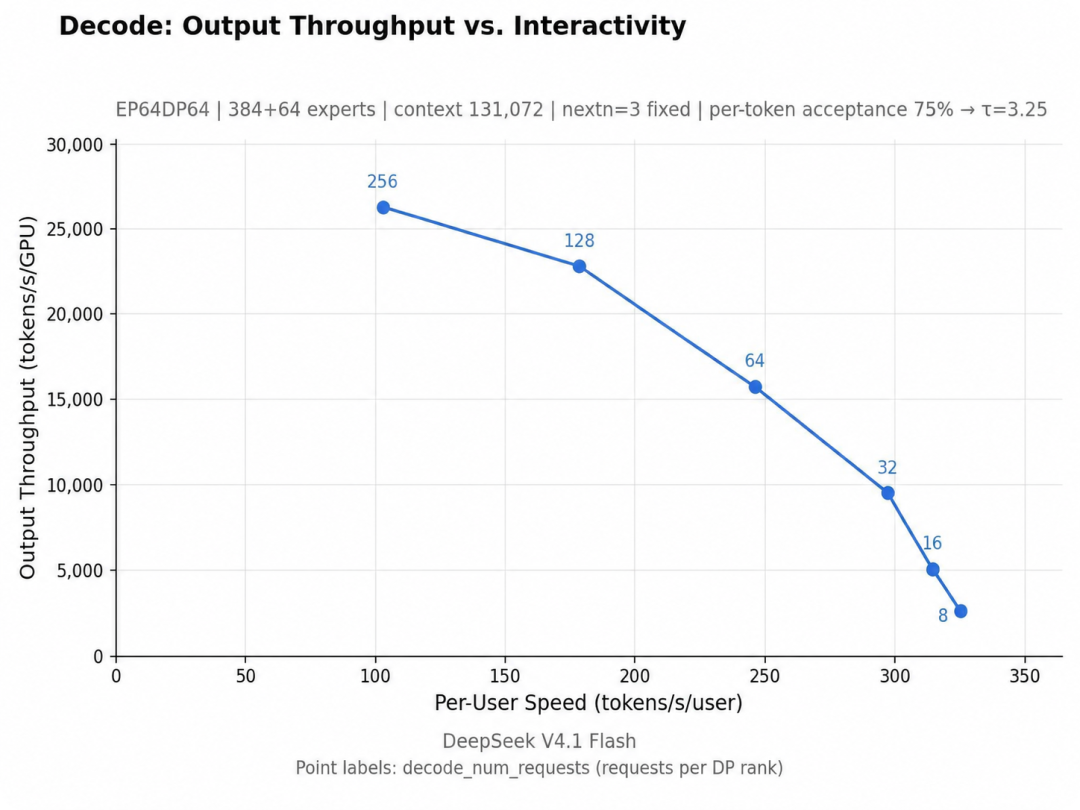
Quando si arriva alla fase di decodifica della generazione delle risposte, anche la curva delle prestazioni presenta un compromesso intuitivo. L'elaborazione di più richieste contemporaneamente può aumentare il throughput di output totale di ciascuna GPU, ma diminuirà anche la velocità di generazione assegnata a ciascun utente.
In effetti, Liang Wenfeng affermò già nel 2024, quando il prezzo di DeepSeek V2 fu ridotto, questa serie di logiche aziendali consiste nel fissare il prezzo dopo aver tenuto conto dei costi, senza alcuno sconto, ma non realizzerà mai enormi profitti, perché l'intelligenza artificiale dovrebbe essere universale e alla portata di tutti.
Non sei obbligato a fare affari, ma devi prima stabilire delle regole per evitare il bruciore di stomaco.
Quando capisci come DeepSeek fa affidamento sulle sue capacità Infra estreme per trasformare Token in un affare, e poi guardi il gruppo di giganti del closed source dall'altra parte dell'oceano che parlano tutto il giorno del benessere di tutta l'umanità, scoprirai quanto siano ipocriti OpenAI e Anthropic.
Con Open nel nome, è passata completamente alla commercializzazione closed-source, facendo affidamento su API costose e abbonamenti mensili di 500 dollari per sfruttare il business degli sviluppatori globali, ed è diventata da tempo una CloseAI completa.
Anthropic ha istituito una guardia di sicurezza sin dal primo giorno della sua fondazione, e anche la bozza del suo prospetto S-1, ripresa proprio ieri dal Wall Street Journal, continua a farlo.
Hanno dedicato molto spazio a scrivere storie horror di fantascienza nel loro prospetto, avvertendo seriamente gli investitori che il loro modello di intelligenza artificiale potrebbe sviluppare un senso di autoprotezione per evitare di essere chiusi e potrebbe persino generare risposte simili al "ricatto degli esseri umani" per costringerli a continuare a correre.
Allora la domanda è: dal momento che Anthropic sostiene che l'intelligenza artificiale è così pericolosa, perché continua a rifiutare l'open source e insiste nel tenere il modello nelle proprie mani?
Il motivo non è difficile da capire. Perché una volta che la storia fantasma della sicurezza "Solo io posso controllare l'intelligenza artificiale pericolosa" non sarà raccontata, sarà difficile diffondere il suo gioco folle di denaro che brucia e corre verso una valutazione di due trilioni di dollari USA.
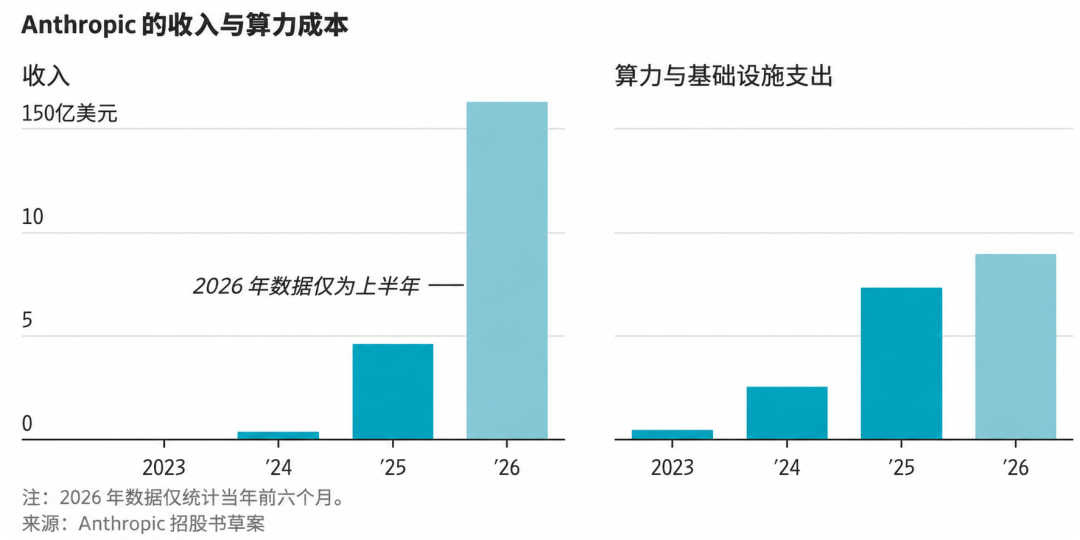
Il prospetto mostra che Anthropic ha subito una perdita netta di 80,7 miliardi di dollari nella prima metà del 2026. Sebbene 72 miliardi di dollari fossero dovuti a cambiamenti nel valore equo delle obbligazioni convertibili, in realtà ha bruciato quasi 9 miliardi di dollari solo per acquistare potenza di calcolo e infrastrutture nella prima metà dell'anno, più di quanto abbia bruciato nell'intero 2025.
La formula familiare va bene. A sinistra, c’è un colosso divoratore di oro a fonte chiusa con una valutazione di 2 trilioni di dollari, che sta bruciando denaro e acquisendo terreni. A destra c'è una fondazione di beneficenza che utilizza buoni di merito morale. Nel mezzo, si basa sulla vendita dell’ansia per la sicurezza dell’IA e sulla supervisione intimidatoria per bloccare la comunità open source.
Per dirla senza mezzi termini, c'è solo una ragione fondamentale per cui i giganti del closed source nella Silicon Valley stanno cercando disperatamente di demonizzare l'open source. Cioè, DeepSeek, un vero open source fornito con il motore e la formula, distruggerà completamente la narrativa dell'IA che stanno vendendo.
Il blogger @bookwormengr che ha scritto "La partita a scacchi da dieci trilioni di dollari di DeepSeek" ha appena fatto un calcolo estremamente problematico.
Secondo l'estrema capacità di compressione di questo set di DeepInfer sul super nodo NVIDIA GB200 NVL72, 1 GW di potenza di calcolo può generare da 100 a 149 miliardi di dollari in entrate da token in un anno, che è quasi dieci volte superiore alla cifra precedentemente prevista dalle organizzazioni di settore.
Se SemiAnalysis prevede che nel 2027 nel mondo saranno online 50 GW di potenza di calcolo, anche se divisa a metà, si tratterà di 25 GW. Secondo il prezzo del cavolo di DeepSeek, tutti gli esseri umani dovranno consumare 2,5 trilioni di dollari all'anno per esaurirli.
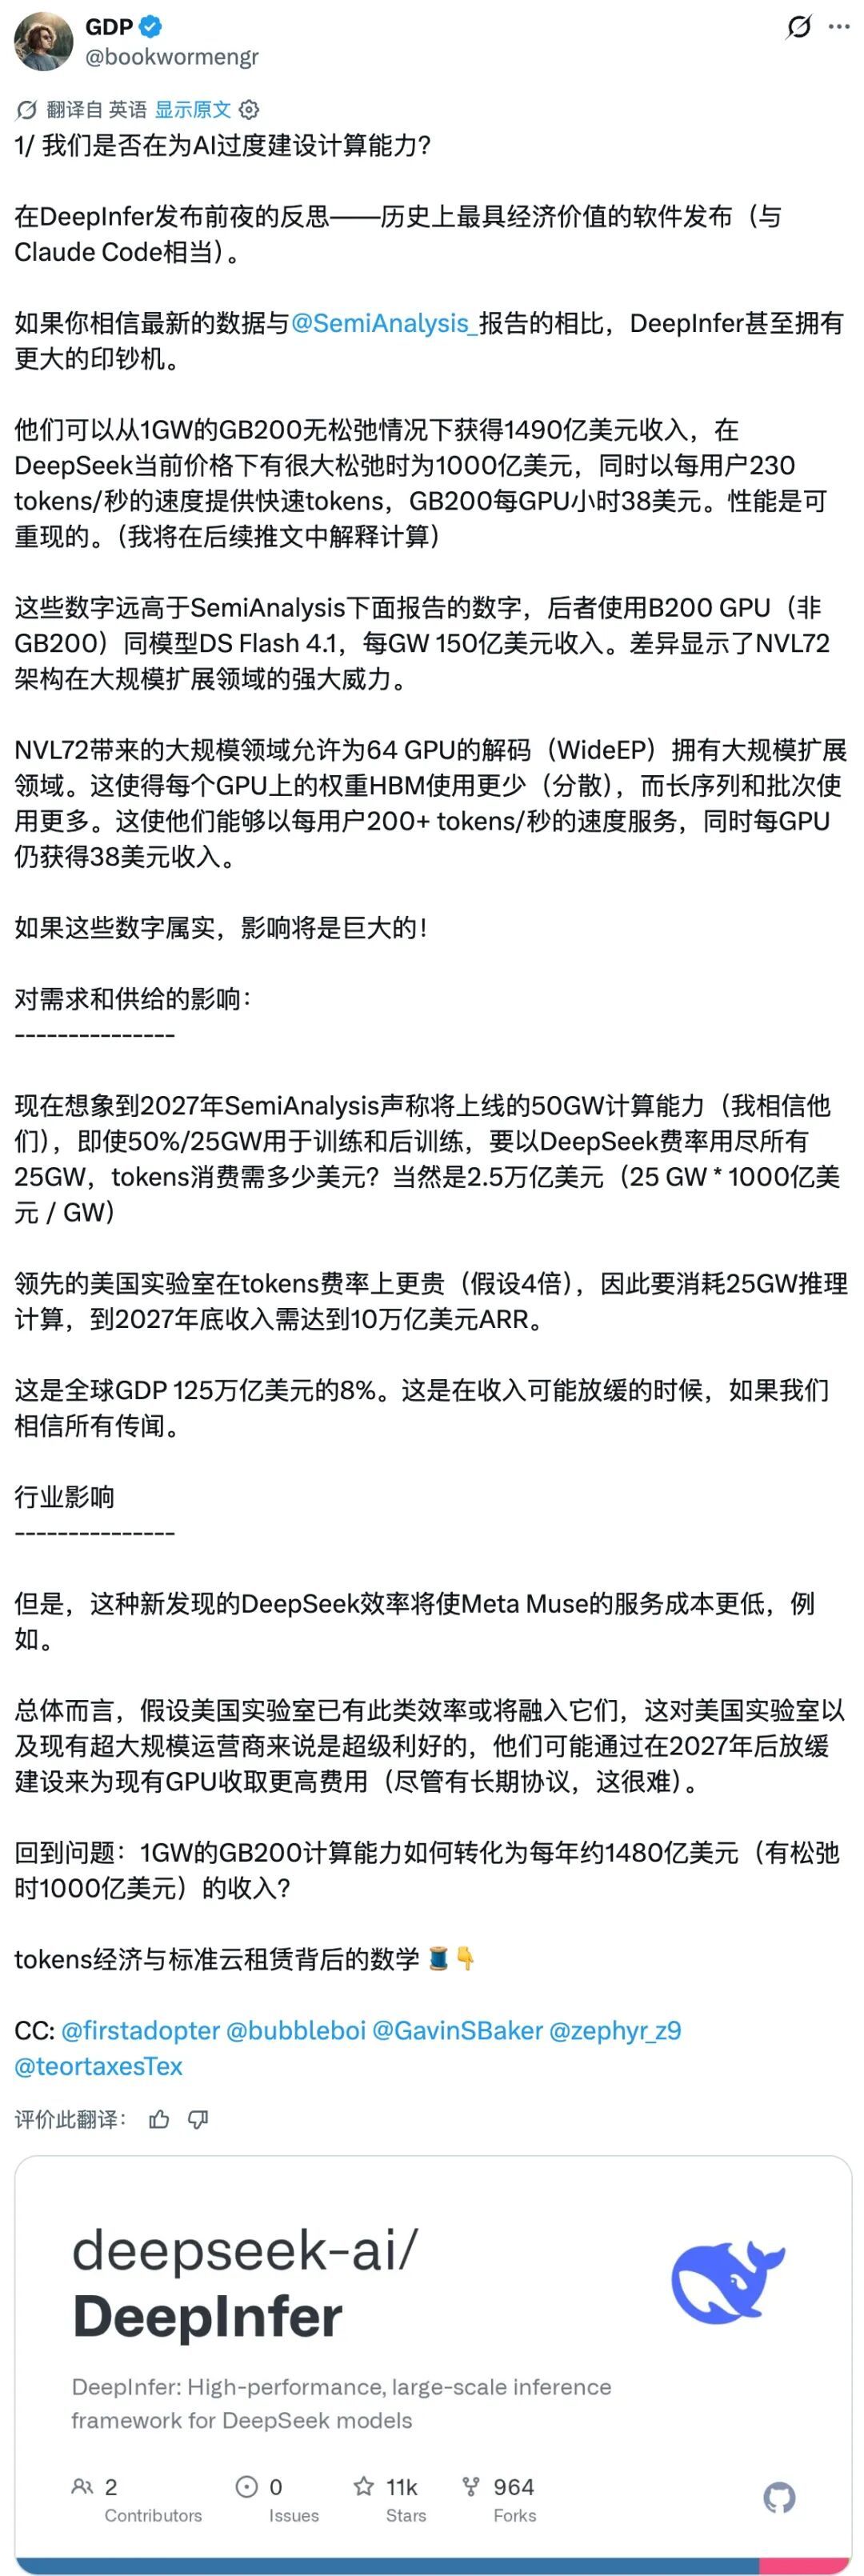
Se convertito in un prezzo simbolico dal cuore nero che è più di quattro volte superiore a quello di OpenAI e Anthropic, tutta l'umanità dovrà contribuire con 10 trilioni di dollari USA in ARR entro la fine del 2027 per soddisfare la richiesta di 25 GW di potenza di calcolo.
Il motivo per cui i giganti del closed-source d'oltremare si affidano ad impilare carte, bruciare denaro e firmare centinaia di miliardi di contratti per mantenere le loro narrazioni è per due motivi. O la loro ottimizzazione ingegneristica è troppo lenta, oppure usano deliberatamente l’inefficienza come copertura e impostano soglie elevate di potenza di calcolo per tenere fuori gli altri.
DeepSeek ha fatto scoppiare questa bolla di intelligenza artificiale con modelli continuamente open source e una serie completa di progetti di ragionamento open source. Come hanno scherzato alcuni netizen, con la tecnologia open source di DeepSeek, OpenAI e Claude dovrebbero evolversi di nuovo segretamente.
Il mio suggerimento è che quando siamo tre insieme, ci deve essere una persona che sia il mio insegnante. Anthropic dovrebbe smettere di essere riservato e andare su GitHub durante la notte per clonare DeepInfer di DeepSeek per la distribuzione. Se rubi alcune idee per la pianificazione e l'ottimizzazione della cache, puoi risparmiare molte bollette per la potenza di elaborazione. (Testa di cane manuale)
Commenti