
Riassunto:
Allo stesso modo, per eseguire correttamente tutte e 10 le attività di programmazione, la nuova versione di DeepSeek costa meno del 40% di Claude Opus 5.5 e l'attesa media per ciascuna attività è stata di due minuti in più.
Il 17 ottobre DeepSeek ha rilasciato la V4.1-Flash-1017 e il prezzo è rimasto invariato. Dopo il suo rilascio, gli sviluppatori lo hanno già utilizzato per creare giochi, creare pagine Web e modificare codice.
Per testare il suo livello effettivo, lo sviluppatore Ibragim Badertdinov ha selezionato 10 attività dal suo lavoro quotidiano ed ha eseguito diversi modelli tre volte nello stesso set di strumenti di programmazione, utilizzando la marcia di inferenza alta di DeepSeek V4.1-Flash-1017 e la marcia bassa di Opus 5.5 e GPT-6 Astra.
Dopo il test effettivo, tutti e tre i modelli hanno superato il test, ma il divario è stato ampliato dalla fatturazione e dal dispendio di tempo: DeepSeek ha speso in media solo 0,045 dollari per attività, che era di gran lunga inferiore agli 0,1168 dollari di Opus e ai circa 0,26 dollari di GPT-6 Astra; tuttavia, Opus e GPT hanno impiegato rispettivamente solo 37 secondi e 55 secondi per essere completati, ma DeepSeek ha impiegato 2 minuti e 38 secondi.
Queste 10 attività sono tutte di piccola scala. Come progetto completo, il divario tra DeepSeek, GPT e Claude è solo questione di aspettare ancora un po'?
Ha superato tutte e dieci le domande nella sezione 01, DeepSeek fa risparmiare denaro, Opus fa risparmiare tempo
Gli argomenti scelti da Ibragim provenivano da circa tre mesi di utilizzo degli agenti, che coinvolgevano elaborazione dati, back-end, front-end e distribuzione, utilizzando Python e TypeScript. Ha selezionato le attività che di solito riusciva a completare in meno di un'ora e vi ha aggiunto programmi di controllo automatico.
Un esempio semplificato da lui illustrato consiste nell'importare un batch di dati in una tabella di dati locale. Oltre a importare correttamente, il programma deve anche ignorare i record duplicati, rifiutare numeri in conflitto e segnalare dati insoddisfacenti; quando si sostituiscono i vecchi dati, non è possibile distruggere il contenuto originale a metà della scrittura. Il test verificherà la presenza di input vuoti, conflitti di dati, danneggiamento del file originale, ecc.
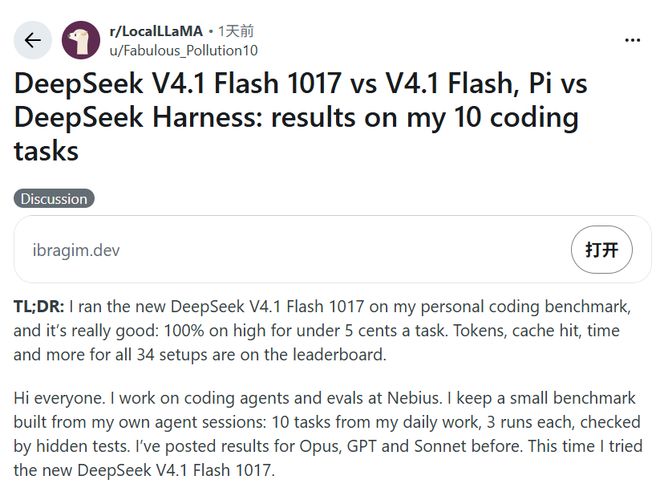
Tutti e tre i modelli hanno superato questi controlli, ma DeepSeek ha compiuto ulteriori passi.
Sempre in esecuzione sullo strumento di programmazione Pi, DeepSeek richiede una media di 15,3 passaggi per attività, Opus richiede 3,7 passaggi e GPT-6 Astra richiede 6,5 passaggi. L'utilizzo totale dei token di DeepSeek è di circa 547.000 e quello di Opus è di circa 31.000.Ne consumo tantissimo, ma la bolletta non aumenta. Ibragim ha spiegato che quasi tutti gli input di DeepSeek hanno raggiunto la cache e il tasso di successo della cache registrato ha raggiunto il 97,9%. I 547.000 token non sono stati scritti di recente dal modello. Una risposta così lunga includeva contenuti inviati ripetutamente in più cicli di chiamate. Gli input memorizzati nella cache a basso costo hanno mantenuto il costo di questo test al di sotto dei 5 centesimi per test.
Per gli utenti, l'impatto di questi due minuti dipende dal tempo di attesa davanti allo schermo. Dopo aver affidato il compito e aver fatto altre cose, l'attesa potrebbe non essere un ostacolo; se vuoi apportare la successiva serie di modifiche subito dopo aver visto i risultati, la velocità di Opus e GPT in questa serie di test è più utile. Ciò che viene confrontato qui è il costo per completare le attività tramite l'API, non la tariffa mensile per i pacchetti di abbonamento ChatGPT o Claude.
La nuova versione è inoltre migliorata rispetto alla versione precedente. Ibragim in precedenza utilizzava l'impostazione di inferenza più alta della versione di settembre di Flash per testare e ha superato 28 volte su 30 esecuzioni, con un tempo medio di 4 minuti e 30 secondi per ciascun test. Questa volta, utilizzando la nuova versione dell'impostazione di fascia alta, sono passate tutte e 30 le volte e il tempo è stato ridotto a 2 minuti e 38 secondi.
02 Ho costruito una BMW per $ 0,38, ma ci sono voluti 40 minuti per eseguire una normale pagina web
Ciò che DeepSeek vuole mostrare questa volta non è semplicemente compilare una funzione. I casi rilasciati ufficialmente includono la scena 3D della Città Proibita, un gioco di corse sul web e una dimostrazione di riproduzione di "Portal 2" prodotta con Godot. L’azienda afferma che la nuova versione migliora la capacità di completare progetti da zero attraverso l’apprendimento per rinforzo con auto-feedback.
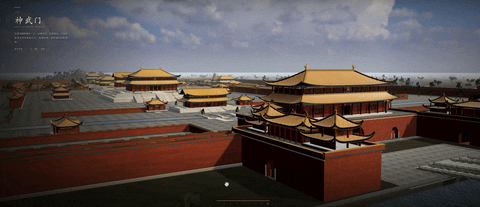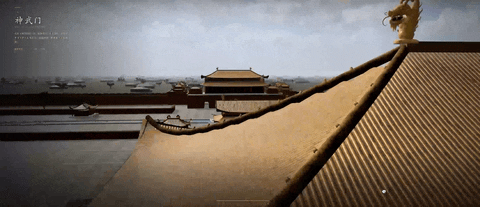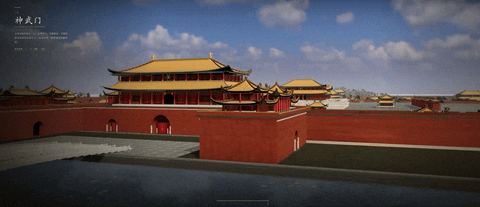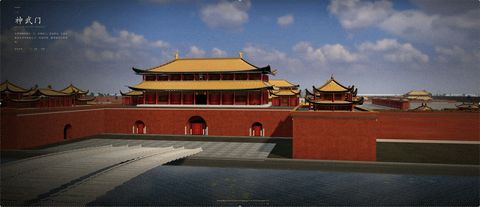
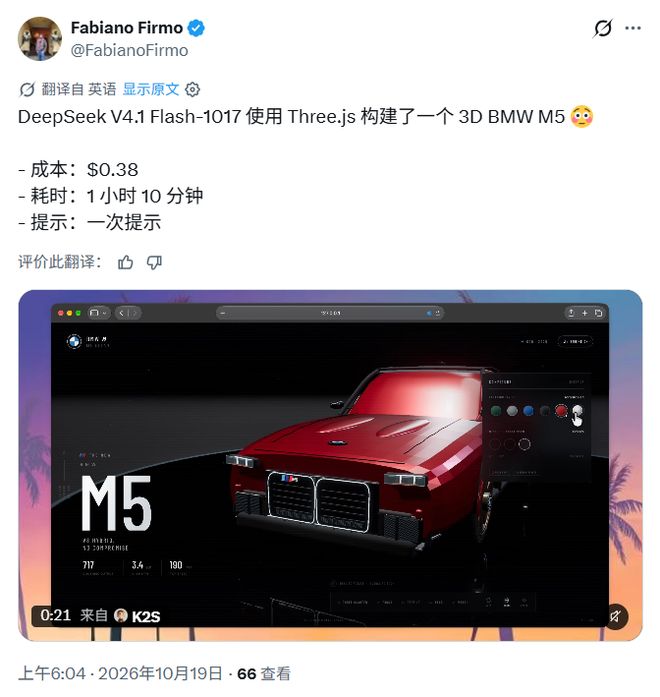
Lo sviluppatore Fabiano Firmo gli ha chiesto di utilizzare Three.js per creare un modello 3D della BMW M5. Nella foto che ha pubblicato, nella pagina del display appare un'auto rossa, con accanto le opzioni di colore.
Secondo lui, questa volta ha inviato un solo promemoria, che è costato $ 0,38 e ha richiesto 1 ora e 10 minuti.
Alcuni utenti hanno anche mostrato un gioco simile a "Rocket League", in cui le auto giocano a calcio sul campo. L'utente di X, Markets & Mayhem, ha commentato che gli effetti fisici funzionano normalmente ed è giocabile, ma ha ancora bisogno di essere rifinito. Per chi vuole prima prototipare una pagina web o un gioco, è più facile vederne l'uso in queste demo rispetto ai punteggi degli esami modello.
Tuttavia, essere disposti ad aspettare più di un'ora per vedere un'auto in 3D non significa che sei disposto ad aspettare così a lungo per creare una normale pagina web.
Lo sviluppatore Alex Carter ha affermato di aver chiesto a DeepSeek Harness di creare una normale pagina di destinazione, la cui esecuzione ha richiesto 41 minuti; le successive due attività della pagina Web hanno richiesto rispettivamente altri 43 minuti e 40 minuti. Pensava che il modello fosse intelligente, economico e presentato bene, ma le pagine richiedevano anni di lavoro e di solito potevano essere completate in dieci minuti.
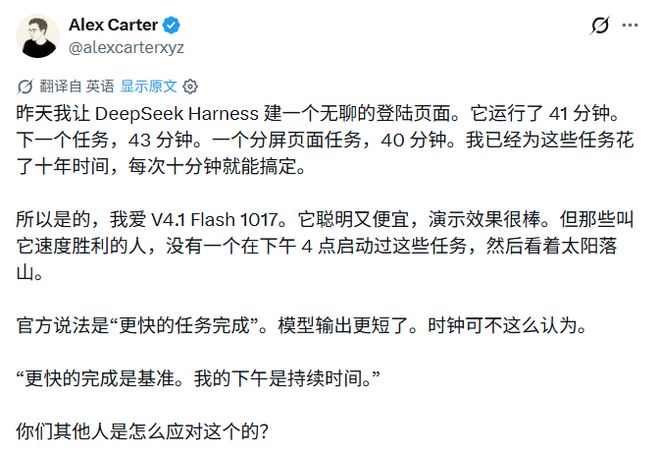
Anche l'unbug degli sviluppatori ha una sensazione simile: il modello è diventato più intelligente, ma è facile pensare troppo a lungo e ritardare l'azione. Un altro utente, Elshayib, ha sottolineato che la sua lamentela non riguardava il numero di parole emesse al secondo, ma che il modello impiegava troppo tempo a pensare prima di agire.
Un test della piattaforma API OmniaKey ha registrato questo lungo risultato di ragionamento. It requires the new version of Flash to write a program that calculates expressions according to Python operation rules, and cannot call ready-made parsing tools. Il modello ha impiegato circa 88 secondi per superare tutti i 30 casi d'uso di ispezione; dei circa 20.700 token in uscita, circa 19.700 sono stati considerati contenuto.
Ma Flash non è lento per tutte le attività. In another test of OmniaKey, it extracted 10 fields from an invoice email that was mixed in German and English, and answered all of them correctly in 5.2 seconds; la chiamata dello strumento per interrogare il tempo e l'ora in due città è stata completata in 2,6 secondi. OmniaKey stessa vende l'API del modello e ciascuno di questi set di test verrà eseguito una sola volta.
Questi esempi di modelli e pagine di destinazione BMW non sono confronti tra i tre modelli sullo stesso argomento. Quanto sarà il prodotto finito di deepSeek e quante volte verrà rivisto in seguito, deve ancora essere confrontato con GPT e Claude con gli stessi requisiti.
03 Dopo aver abbassato la marcia, è stato un minuto più veloce e si sono verificati altri tre guasti
Poiché l'impostazione di inferenza alta richiede molto tempo, cosa accadrà se viene abbassata? Anche Ibragim lo ha testato.
In Pi, dopo che la nuova versione di DeepSeek è stata regolata sull'impostazione bassa, il tempo medio per elemento viene ridotto da 2 minuti e 38 secondi a 1 minuto e 31 secondi e il costo viene ridotto da 0,045 USD a 0,0257 USD. Tuttavia, 3 corse su 30 sono fallite.
Tutti i passaggi ottenuti ad alti livelli non possono essere mantenuti intatti.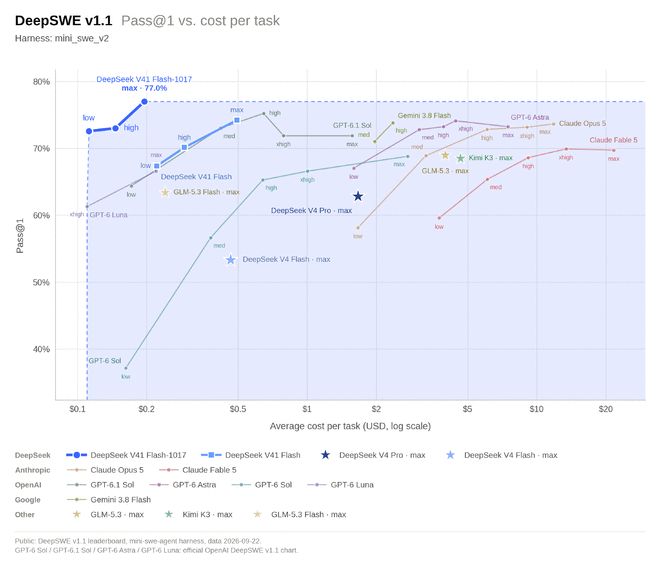
A questo livello basso, sono passato a Harness di DeepSeek e i risultati sono cambiati di nuovo: è passato 29 volte in 30 esecuzioni, due in più di Pi. Secondo i registri di Ibragim, l'ambiente dello strumento ufficiale ha aiutato il modello a gestire una condizione al contorno che non era stata rispettata in Pi.
I due set di strumenti funzionano in modo diverso con i modelli. DeepSeek Harness directly provides tools for reading and editing files, while Pi mainly allows the model to be operated through the command line; anche le parole del prompt del sistema del primo sono più lunghe. After changing tools this time, token usage increased by about 75%, and the average time spent increased from 1 minute and 31 seconds to 1 minute and 53 seconds. In entrambi i set di strumenti, è possibile eseguire solo 9 attività tre volte di seguito.
Per lo stesso modello, se si modificano gli strumenti di inferenza e il set di strumenti, la velocità, i costi e il successo cambieranno.
Vedi solo i risultati pubblicati da altri, ma devi anche sapere quali impostazioni hanno utilizzato.DeepSeek also clearly mentioned when it was released that it had optimized tools such as DeepSeek Harness, Tencent CodeBuddy and WorkBuddy, and recommended Harness users to upgrade to v0.2.1-rc.1 or higher.
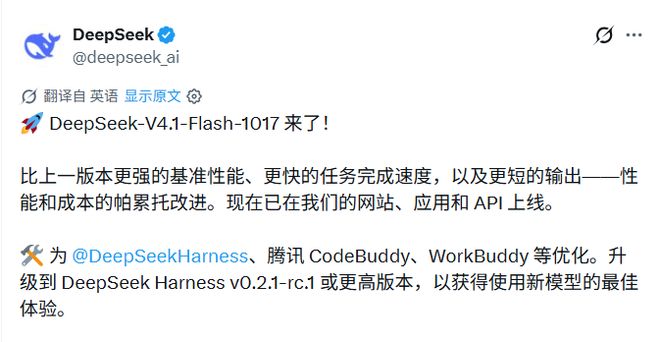
Questo aggiornamento è stato lanciato su pagine web, app e API. Le chiamate API utilizzano ancora deepseek-flash e il prezzo rimane invariato; anche i nuovi pesi del modello sono stati resi pubblici secondo il protocollo del MIT.
Tuttavia, il precedente test di programmazione è stato completato collegando il modello a uno strumento in grado di leggere file, modificare codice ed eseguire controlli. Chiedergli di scrivere un pezzo di codice nella finestra di chat è diverso dal chiedergli di farsi carico di un progetto. L'ambiente di utilizzo è diverso.
04Per la stessa serie di domande, GPT e Claude possono essere più economici
Opus e Astra sono i fiori all'occhiello delle due società, ma anche OpenAI e Anthropic hanno modelli più economici.
Nella stessa serie di test Ibragim, la marcia xhigh di GPT-6 Luna e la marcia alta di Haiku 5.5 hanno superato tutte 30 volte. Il costo medio di ciascun articolo era rispettivamente di soli 0,0145 USD e 0,0208 USD, un valore inferiore a quello di DeepSeek.
Il consumo medio di tempo dei due è rispettivamente di 2 minuti e 46 secondi e 2 minuti e 08 secondi.In questo modo la scelta non è più solo "GPT costoso, Claude" o "DeepSeek economico". Le persone che già utilizzano Luna o Haiku per gestire piccoli compiti potrebbero non essere in grado di risparmiare ulteriore denaro passando a Flash.
I compiti più difficili cambiano la questione: da quanto tempo aspettare a se ci si può fidare dei risultati. L'utente X Yum ha detto che dopo aver provato la nuova versione, è ancora molto preoccupato per le allucinazioni, in particolare la ricostruzione e la modifica dell'architettura su più file. Avrebbe chiesto a un altro modello di controllare le modifiche piuttosto che lasciare che DeepSeek approvasse la propria soluzione. Questa è la sua scelta di utilizzo, non un test sulla stessa domanda per dimostrare che GPT o Claude sono più affidabili.
Pertanto, il progresso più concreto al momento è che la nuova versione di DeepSeek ha fornito gli stessi risultati di ispezione del modello di punta in una serie di piccole attività di programmazione.
Quante correzioni manuali sono necessarie in progetti di grandi dimensioni e se i problemi possono essere riparati determineranno fino a che punto potrà arrivare questa sostituzione.
C’è ancora molto lavoro tra la costruzione di un’auto 3D e il mantenimento di un progetto a lungo termine.Anche Ibragim si prepara a rendere questa prova più difficile. Alla fine del post ha detto che il passo successivo sarebbe quello di selezionare un gruppo di compiti molto più difficili e confrontare diversi strumenti e modelli.
Commenti