
Riassunto:
Anche DeepSeek ha aderito al concorso sui parametri. Secondo The Information, DeepSeek sta attualmente addestrando un nuovo modello con circa 2 trilioni di parametri; Liang Wenfeng ha anche dichiarato in una recente riunione degli investitori che il prossimo passo della società sarà continuare a spingere il modello fino a 8 trilioni di parametri. Un anno fa 8mila miliardi erano ancora una cifra inimmaginabile.
Ma ora Kimi K3 ha raggiunto i 2,8 trilioni di parametri; Byte sta pre-addestrando un nuovo modello che potrebbe raggiungere fino a 10 trilioni di parametri; Alibaba ha anche dichiarato pubblicamente che il modello di prossima generazione spingerà tra i 5 e i 10 trilioni di parametri. Anthropic non rivela i parametri del modello, ma FT ha precedentemente citato stime del settore secondo cui la sua ultima ammiraglia, Mythos 5, ha circa 8 trilioni di parametri.
La grande modella girò in cerchio e ricominciò a gareggiare per vedere chi era più grande.
Solo che questa volta i parametri che tutti implementano non sono più gli stessi parametri del precedente ciclo di Scaling.
Quando DeepSeek ha rilasciato V4-Pro nell'aprile di quest'anno, la scala ufficialmente divulgata era di 1,6 trilioni di parametri totali e 49 miliardi di parametri di attivazione.
Il piano di follow-up è di 8 trilioni di RMB, che equivale a 5 volte quello di V4-Pro.
Questo è in realtà abbastanza insolito quando si tratta di DeepSeek. Dopotutto, DeepSeek ha lasciato l’impressione più profonda nell’intero settore dell’intelligenza artificiale lo scorso anno, non in termini di parametri.
Una volta ciò ha portato l'industria dell'intelligenza artificiale a ridiscutere che forse i modelli all'avanguardia non hanno bisogno di bruciare la GPU all'infinito.
Quando la V3 verrà rilasciata alla fine del 2024, DeepSeek mette deliberatamente sul tavolo il conto della formazione: 671 miliardi di parametri totali, 37 miliardi di parametri attivati per token e la formazione completa consuma 2.788 milioni di ore di GPU H800. Calcolato a 2 dollari per ora GPU, il costo ufficiale della formazione è di soli 5,576 milioni di dollari.
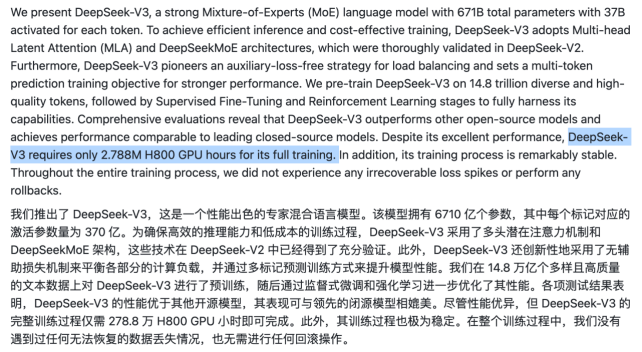
Questo numero, e l'efficienza che ne deriva, è diventato in seguito una delle etichette più importanti per DeepSeek.
DeepSeek non dispone di un'abbondante offerta di GPU avanzate come OpenAI e Anthropic; l’azienda fa affidamento da tempo sulla Huanfang di Liang Wenfeng per quantificare la propria autotrasfusione e non accetta finanziamenti esterni. Le sue condizioni determinano il suo percorso: poiché il denaro e la potenza di calcolo sono limitati, le prestazioni dovrebbero essere massimizzate dall'architettura, dalla formazione e dall'efficienza dell'inferenza.
Ma ora le condizioni sono cambiate.
DeepSeek ha appena completato il suo primo round di finanziamenti esterni dalla sua fondazione nel giugno di quest'anno, raccogliendo circa 7,4 miliardi di dollari. Attualmente è entrato nella fase di finalizzazione il secondo round di finanziamento di circa 50 miliardi di RMB (circa 7,5 miliardi di dollari USA), corrispondente ad una valutazione di circa 500 miliardi di RMB. Se questo finanziamento verrà completato con successo, il finanziamento esterno cumulativo di DeepSeek si avvicinerà ai 15 miliardi di dollari USA e ai circa 100 miliardi di yuan entro pochi mesi.
Allo stesso tempo, DeepSeek ha assunto CITIC Securities per preparare l'IPO del Science and Technology Innovation Board e il nuovo capitale sarà chiaramente utilizzato per infrastrutture informatiche, sviluppo di modelli e investimenti in talenti; il 21 settembre, Yan Wentao, ex partner di Hillhouse Venture Partners, è entrato ufficialmente a far parte di DeepSeek e ha ricoperto il ruolo di CFO, ponendo fine al posto vacante di CFO nei tre anni successivi alla fondazione della società.
In passato, DeepSeek utilizzava denaro e potenza di calcolo limitati per rendere il modello il migliore possibile; ora il finanziamento e la quotazione vengono portati avanti. Con più soldi a disposizione, anche la potenza di calcolo può essere aumentata.
Una volta soddisfatte le condizioni, DeepSeek inizia anche a implementare coraggiosamente i parametri.
Ciò non è in conflitto con la ricerca dell'efficienza. Quando l’efficienza è elevata, la scala può essere ampliata con gli stessi soldi.
Negli ultimi due mesi, la scala dei parametri totali dei modelli all'avanguardia è aumentata in modo significativo.
A riportare questa competizione sotto i riflettori è The Dark Side of the Moon. Nel luglio di quest'anno, Kimi K3 ha raggiunto 2,8 trilioni di parametri totali e 104 miliardi di parametri di attivazione. K3 è ancora il modello a peso aperto con la scala di parametri più grande che sia stato ufficialmente rilasciato.
Non è solo grande. Nella valutazione ufficiale, il GPQA Diamond di K3 ha raggiunto 93,5 e Terminal-Bench 2.1 ha raggiunto 88,3, che è molto vicino a GPT-5.6 Sol e Claude Fable 5 nello stesso periodo. La scala ha raggiunto trilioni e la performance ha raggiunto il primo livello.
Ad agosto, è stato rivelato che Byte stava pianificando di diventare più grande.
Il 6 agosto, "LatePost" ha rivelato per la prima volta che Byte stava discutendo di addestrare un nuovo modello con più di 5 trilioni di parametri, guidato da Xiang Liang, capo della Seed Foundation. Secondo i rapporti, Byte sembra credere internamente che invece di continuare a recuperare il ritardo rispetto alle dimensioni esistenti, sia meglio spingere la scala dei parametri più volte più in alto di quella dei suoi pari.
Il giorno dopo, il 7 agosto, il FT ha riferito, citando persone a conoscenza della questione, che la scala del nuovo modello pre-addestrato da Byte potrebbe raggiungere fino a 10 trilioni di parametri; quando Reuters ha fatto seguito, lo ha anche confrontato con il Mythos all'avanguardia di Anthropic: sebbene quest'ultimo non abbia mai rivelato la scala dei parametri, le stime del settore hanno raggiunto circa 8 trilioni. Se il nuovo modello di Byte raggiungerà le 10T, supererà la scala attualmente diffusa da Mythos.
Ora, quantità di parametri estremamente grandi, superiori a 5T, hanno cominciato ad apparire ripetutamente nelle discussioni sui modelli all'avanguardia.
Oggi, il CEO di Alibaba Wu Yongming ha annunciato pubblicamente che il modello di prossima generazione prevede di raggiungere tra 5 e 10 trilioni di parametri; DeepSeek sta addestrando un modello 2T impostando l'obiettivo di follow-up su 8T. Si può comprendere che il laboratorio principale abbia ancora una volta considerato una scala parametrica totale più ampia come un percorso importante per raggiungere il limite superiore delle capacità.
Anche i modelli closed-source americani che non rivelano i parametri non possono sfuggire a un esame esterno. Gli estranei stimano che Mythos di Anthropic sia 8T; OpenAI non ha più rivelato la scala del modello dall'era GPT-4, ma nella comunità si vocifera che Astra abbia raggiunto un MoE di 10T.
Il numero di parametri non ha mai perso il suo fascino, proprio come il valore del potere di combattimento sul pannello di gioco: le persone sanno che non può rappresentare tutto, ma sarà sempre il numero più intuitivo e opprimente.
In effetti, già da tempo l'industria della modellistica di grandi dimensioni non ama più parlare di parametri.
Negli ultimi due anni si sono alternati la distillazione, i piccoli modelli, il MoE, l'apprendimento per rinforzo e i calcoli del tempo di inferenza. Invece di ostentare di possedere centinaia di miliardi o trilioni di parametri, i produttori di modelli sono più disposti a parlare di prestazioni, costi ed efficienza. Ingrandire semplicemente il modello farà sembrare facilmente che tu abbia soldi ma non hai un posto dove spenderli.
Oggi, le quantità dei parametri sono state nuovamente aumentate e sono diventate ancora una volta la "fronte" dei modelli all'avanguardia.
Tuttavia, i valori 5T, 8T e 10T di oggi non sono più la stessa cosa del "più parametri, più grande è il modello" del precedente ciclo di Scaling.
La ragione più diretta per cui le quantità dei parametri possono essere rimesse sul tavolo è che l'architettura tradizionale dei modelli ultra-grandi è cambiata.
In passato, la corrente principale dei modelli di grandi dimensioni era l'architettura densa, in cui la scala dei parametri e la quantità di calcolo erano sostanzialmente legate insieme. In poche parole, significa quanti parametri sono presenti nel modello e sostanzialmente devono essere inseriti insieme in ogni calcolo. Più parametri ci sono, più alto tende ad essere il limite superiore delle capacità, ma aumenta anche il costo della formazione e dell'inferenza.
Oggigiorno, sempre più modelli di grandi dimensioni utilizzano MoE, Mixture of Experts e l'architettura di esperti misti.
È più come un'azienda con molti esperti. Il modello può avere centinaia o migliaia di esperti, ma solo una piccola parte di essi viene selezionata per lavorare su ciascun compito. Ad esempio, Kimi K3 ha 2,8T parametri totali, ma ogni Token ne attiva solo 104B, circa il 3,7%; DeepSeek V4-Pro ha 1,6 T di parametri totali e ciascun token ne attiva solo 49 B, circa il 3%.
Quindi oggi, se un modello ha parametri 5T, 8T o anche 10T, ciò non significa che deve eseguire questi parametri 10T ogni volta che genera un token.
Quanto può contenere il modello e quanto deve essere calcolato ogni volta sono diventati due numeri diversi.
I parametri possono essere intesi come lo spazio utilizzato dal modello per trasportare conoscenze, modelli e capacità. Maggiori sono i parametri totali, maggiore è lo spazio teoricamente a disposizione del modello per apprendere distribuzioni sempre più complesse; MoE gli consente di chiamarne solo alcuni quando necessario.
Di conseguenza, il modello può continuare ad aumentare la capacità totale dei parametri senza rendere ogni calcolo più pesante di anno in anno.
Prendendo sempre K3 come esempio, ha un parametro totale di 2.8T, che è circa tre volte la scala di K2.5, ma su 896 esperti, solo 16 di ciascun Token sono attivati. Dark Side of the Moon ha affermato che grazie a un MoE più rado e a una serie di ottimizzazioni architetturali, l'efficienza di scaling complessiva di K3 è stata migliorata di circa 2,5 volte rispetto a K2.
L'era degli agenti ha semplicemente riportato questa "capacità" al centro della competizione.
In passato, l'abilità di un Chatbot veniva spesso misurata una per una. La matematica guarda alla matematica, il codice guarda al codice e le domande e risposte guardano alla conoscenza. Se il modello raggiunge picchi più alti su diversi benchmark chiave, è sufficiente dimostrare che è molto forte.
Ma l'Agente unisce queste funzionalità nella stessa catena di attività. Un compito davvero lungo può iniziare con la ricerca di informazioni, quindi leggere pagine web, guardare immagini, scrivere codice, chiamare il terminale e poi riscontrare errori, modificare il piano, chiamare altri strumenti e persino assegnare attività secondarie ad altri agenti.
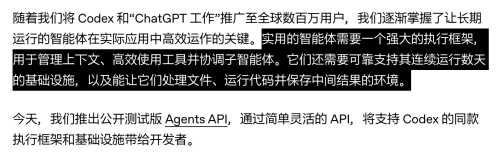
Quando OpenAI ha rilasciato l'API Agents nel settembre di quest'anno, ha elencato direttamente l'esecuzione a lungo termine, la gestione del contesto, l'utilizzo degli strumenti e il coordinamento dei sub-agenti come l'infrastruttura principale dell'agente e ha sottolineato che l'agente deve funzionare in modo affidabile per ore o addirittura giorni.
In una sessione di domande e risposte, se una certa abilità fallisce occasionalmente, solo una domanda potrebbe andare persa; in un'attività dell'agente che prevede dozzine o centinaia di passaggi, qualsiasi collegamento debole può interrompere l'intero collegamento. Più lungo è il compito, maggiori saranno i requisiti di copertura di capacità e stabilità. Di conseguenza, la concorrenza di frontiera ha cominciato ad avere un evidente “effetto barile”.
METR ora utilizza anche direttamente l'"intervallo di tempo dell'attività" per misurare le capacità dell'agente, perché più lunga è l'attività, maggiore è il requisito per il modello di completare continuamente una serie di operazioni diverse.
Nell'era dei Chatbot è più facile vedere il picco delle capacità, mentre nell'era degli agenti la copertura delle capacità è sempre più importante.
Al momento, la capacità dei parametri maggiore ha un nuovo valore. Quanto più lungo è il compito, tanto meno distorto deve essere il modello; più cose può fare l'Agente, più ampie sono le capacità che la base deve coprire.
MoE apre la strada a una continua espansione della capacità e Agent ne amplifica ulteriormente il valore. Pertanto, i produttori di modelli stanno facendo del loro meglio per migliorare l’efficienza spingendo nuovamente i parametri a 5T, 8T e 10T.
La potenza di calcolo risparmiata non ha fatto scomparire lo Scaling, ma ha invece creato nuovo spazio per lo Scaling.
Commenti