Riassunto:
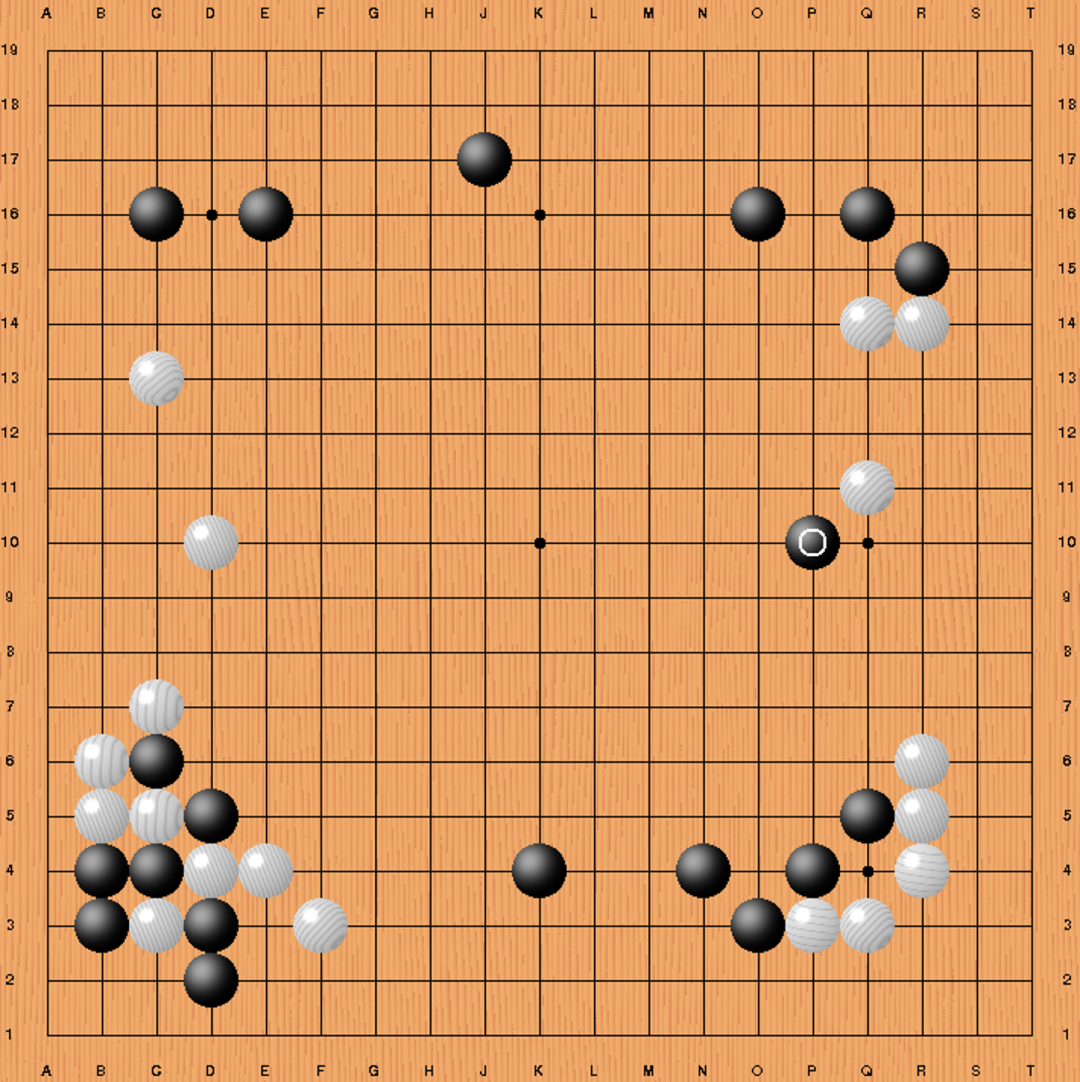
Marzo 2016, Four Seasons Hotel Seoul. A metà del secondo gioco della battaglia uomo-macchina, AlphaGo ha lasciato cadere una macchia solare sulla quinta riga. Il commento sul posto era senza parole e qualcuno sospettava che ci fosse un bug nel programma, perché secondo il buon senso dei giocatori di scacchi professionisti, questa mossa era quasi un tiro libero.
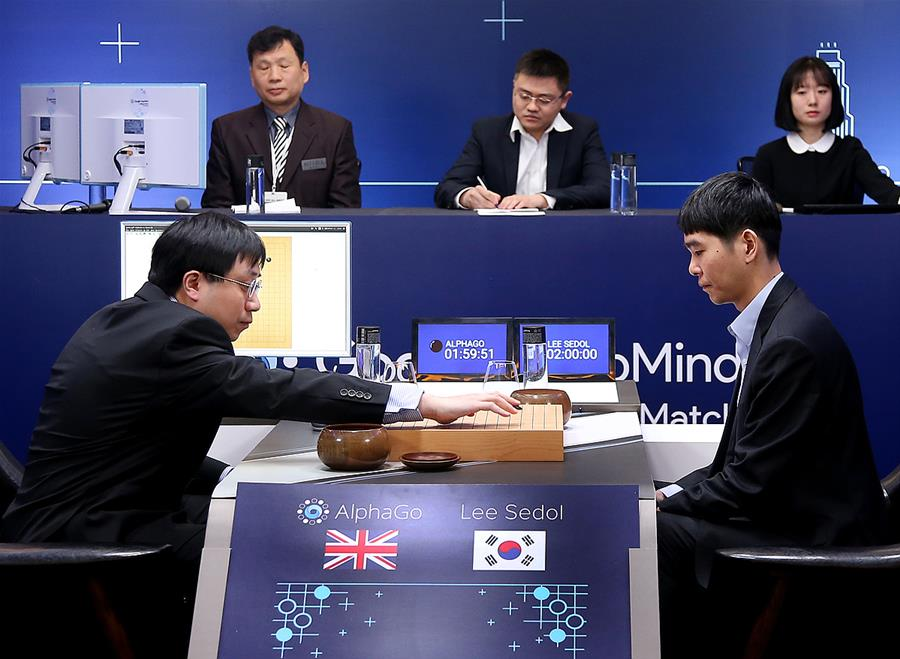
Tutti conoscono la storia successiva. AlphaGo non solo vinse la partita, ma sconfisse anche Lee Sedol con un punteggio totale di 4:1. Dopo la partita, Lee Sedol ha detto qualcosa che viene spesso citato: "Inizialmente pensavo che AlphaGo fosse solo una macchina basata sul calcolo delle probabilità. Ma dopo aver visto quella mano, ho cambiato idea. AlphaGo deve essere creativo."
Questa è la famosa mossa 37.
Dieci anni dopo, l'uomo che ha creato AlphaGo si alzò e disse: l'intelligenza artificiale di oggi non ha le capacità su cui fa affidamento il gioco degli scacchi.
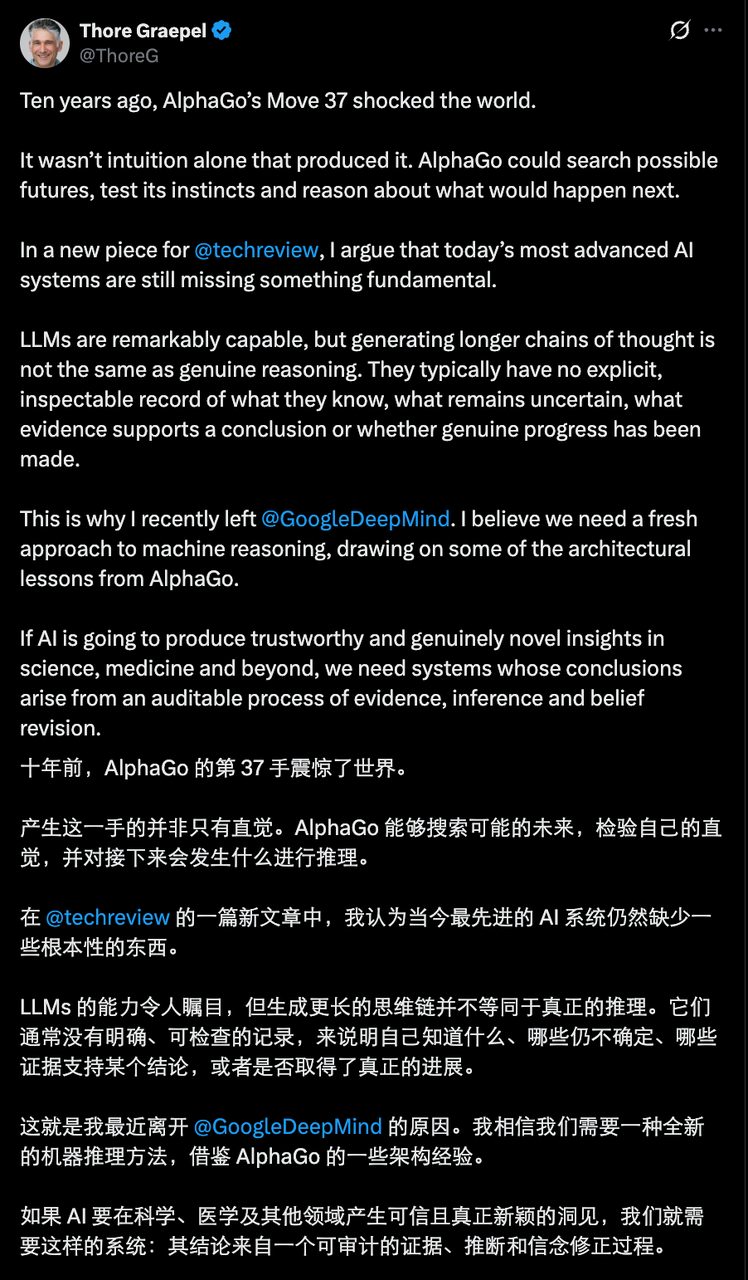
La persona che lo ha affermato è Thore Graepel, uno dei principali autori di AlphaGo ed è impegnato da molto tempo nella ricerca sull'apprendimento automatico. Recentemente ha preso una decisione interessante: lasciare Google DeepMind per avviare un'attività e fare qualcosa che ritiene più importante: dotare le macchine di reali capacità di ragionamento.
Questo punto toccante deriva da un articolo recentemente pubblicato su MIT Technology Review. Il titolo dell'articolo è molto semplice, intitolato "Non lasciarti ingannare: i LLM non possono ragionare". Dopo aver letto questo articolo, il vincitore del Premio Turing Yann LeCun ha espresso il suo apprezzamento, sottolineando che "il vero ragionamento deve coinvolgere la ricerca, e LLM non ha questa capacità".
Perché Thore Graepel ha detto questo? Diamo un’occhiata a quanto scritto in questo articolo.
Move 37 non è stato un "lampo di ispirazione",
È il prodotto del ragionamento
Molte persone descrivono la 37a mossa come un "momento mitico dell'intuizione della macchina": in un lampo, l'IA ha visto una mossa magistrale che va oltre la storia millenaria degli scacchi umani. Graepel ha affermato che questo è il più grande malinteso su AlphaGo.
Per capirlo, dobbiamo prima smantellare la struttura interna di AlphaGo. Si compone di due sistemi: uno è una rete politica, che impara da enormi record di scacchi umani per prevedere "come giocherà il maestro in questa situazione". Questa è la parte intuitiva. L'altro è un meccanismo di ricerca, che non si preoccupa se una certa mossa degli scacchi "sembra che sia stata giocata da un essere umano", ma costruisce esplicitamente un albero di gioco contenente migliaia di rami per dedurre il futuro a cui conduce ciascuna posizione candidata.
Il punto chiave è: agli occhi della rete strategica, la mossa 37 non è notevole: la probabilità che un giocatore di scacchi umano professionista giochi questa mossa è solo circa 1 su 10.000. Se ascolti solo la tua intuizione, questa mano non verrà scelta affatto. È stato il meccanismo di ricerca a scoprire, dopo un attento calcolo, che questa mossa "incredibile" portava a un finale migliore.
Graepel prende in prestito la famosa struttura di Kahneman per spiegarlo. Il pensiero umano è diviso in due modalità: il sistema 1 è veloce, intuitivo e senza sforzo; Il sistema 2 è lento, graduale e attentamente valutato. AlphaGo sembra essere una rara combinazione di queste due modalità sulla macchina: la rete neurale fornisce l'intuizione di "questa mossa ha una possibilità" e "questa situazione deve essere vinta", e il meccanismo di ricerca è responsabile di testare queste intuizioni nei futuri cambiamenti offensivi e difensivi. Non funzionerà senza metà: l'intuizione da sola non farà mai la 37a mossa; La ricerca violenta da sola non sarà in grado di escludere le possibilità astronomiche di Go.
A questo proposito esiste un altro paragone che spesso viene trascurato. Deep Blue ha sconfitto Kasparov nel 1997 basandosi su regole codificate dagli esseri umani per valutare 200 milioni di posizioni degli scacchi al secondo e guardare avanti da sei a otto passi. La complessità di Go è completamente su un altro livello. Il valore di un pezzo dipende dalla crescita e dal declino dello slancio e del campo dopo dozzine di round. Anche se venisse calcolata solo una piccola parte di tutti i cambiamenti, un supercomputer dovrebbe calcolarla nell’arco di miliardi di anni. Pertanto, AlphaGo deve imparare a "vedere chiaramente la situazione a colpo d'occhio" e persino a creare mosse a cui gli esseri umani non hanno mai pensato. Non si vince schiacciando la potenza di calcolo, il che è fondamentale.
Modello linguistico di grandi dimensioni:
Un sistema addestrato all'estremo 1
Diamo un'occhiata all'intelligenza artificiale di oggi.
Il principio di funzionamento dei modelli linguistici di grandi dimensioni è prevedere il token successivo ancora e ancora. Questo è essenzialmente il Sistema 1 in azione: veloce, associativo e capace di un sorprendente completamento di schemi in quasi tutti i campi di cui gli esseri umani abbiano mai scritto, ma senza la parte "pensa prima di rispondere".
Non molto tempo dopo la nascita di ChatGPT, il settore si è reso conto che la sola padronanza della lingua non poteva supportare una reale utilità. Tutti conoscono il piano di rimedio: lasciare che il modello non abbia fretta di rispondere, generare prima i passaggi intermedi, spezzare il problema e portare con sé i risultati intermedi - cioè la catena di pensiero.
Il miglioramento della catena del pensiero è reale, soprattutto in matematica e programmazione. Ma Graepel ha sottolineato un fatto che è facilmente oscurato dall'eccitazione: questi passaggi intermedi del ragionamento sono sempre lo stesso processo di "predire il prossimo token", solo che si itera un po' più a lungo prima di dare la risposta finale. Non introduce un meccanismo di ragionamento veramente indipendente come la ricerca di AlphaGo. L'intuizione viene messa a dura prova, ma non si trasforma in prudenza.
Ha inoltre elencato tre difetti per spiegare perché ciò che fa il chatbot non è all'altezza del "tipo di ragionamento riconosciuto dagli scienziati".
In primo luogo, il modello non ha uno stato cognitivo chiaro, continuamente aggiornato e ispezionabile. Quali ipotesi sta valutando in questo momento, quanta fiducia ripone nelle varie spiegazioni, quali prove sta soppesando e quali domande rimangono senza risposta. Queste cose dovrebbero essere riviste sistematicamente man mano che arrivano nuove informazioni, ma non esiste un tale "registro aperto" all'interno del modello.
In secondo luogo, il modello non realizza la separazione tra "cosa sapere" e "come utilizzare la conoscenza". La conoscenza e il ragionamento sono strettamente legati ai pesi della rete neurale e non esiste un sistema di credenze indipendente ed esplicitamente espresso.
Terzo e più sottile: le catene di pensiero sembrano una deliberazione ponderata, ma la ricerca ha dimostrato che i modelli spesso le creano dopo il fatto. La risposta si ottiene camminando in una direzione, ma quello che ti viene riferito è un'altra strada. Una "storia che sembra ragionevole" e un "ragionamento realmente accaduto" sono due cose diverse.
Se il ragionamento è vero o falso,
È così importante?
Se stai semplicemente chiacchierando e chiacchierando, potrebbe non avere importanza se il ragionamento è vero o falso. Ma nei campi ad alto rischio che ci stanno davvero a cuore – medicina, ingegneria, ricerca scientifica – ciò che un sistema raggiunge è altrettanto importante quanto il modo in cui lo raggiunge. Quando qualcosa va storto, come un errore nella diagnosi o nel trattamento, dobbiamo essere in grado di individuare dove si trova l’errore: c’è un problema con il processo di ragionamento, sta accettando prove non valide o sta facendo un presupposto sbagliato? Un sistema che può solo inventare storie a posteriori non può essere considerato attendibile o ritenuto responsabile in tali scenari.
Questo è esattamente il motivo per cui Graepel ha lasciato DeepMind. Crede che abbiamo bisogno di un nuovo percorso di ragionamento automatico e l'ispirazione viene da AlphaGo dieci anni fa.
AlphaGo mantiene in qualsiasi momento un registro di tutta la sua conoscenza della situazione attuale, che è l'albero del gioco. L'albero contiene tutti i cambiamenti che ha considerato, tutti i possibili futuri, e ogni mossa e ogni situazione è segnata con il giudizio della rete neurale. Man mano che la detrazione avanza, aggiorna continuamente l'albero e infine determina la mossa in base alle informazioni nell'albero.
Graepel ritiene che lo stesso valga per i sistemi di ragionamento generale: mantenere uno stato cognitivo che esprima chiaramente ciò che è confermato, ciò che è in dubbio, ciò che è stato escluso e quali domande rimangono aperte. E il "ragionamento" è una serie di "azioni" che modificano questo stato cognitivo: trarre conclusioni, smantellare problemi e, soprattutto, decidere quali domande porre successivamente, quali calcoli fare e quali esperimenti eseguire.
Naturalmente, ragionare in un mondo aperto è molto più difficile che giocare a scacchi. Lo stato sul tabellone Go è completamente visibile e le regole sono fisse; nel mondo reale la situazione attuale è conosciuta solo parzialmente, le azioni disponibili sono numerose e complesse e le conseguenze delle azioni sono piene di casualità o addirittura del tutto sconosciute.
Ma la buona notizia è che il progresso del LLM e di altri modelli neurali nel corso degli anni ha semplicemente fornito elementi a questo scopo: LLM può proporre un percorso per risolvere il problema sulla base delle informazioni conosciute e delle risorse disponibili; può interagire con gli strumenti tramite API e codici; può aiutare a valutare se una conclusione è supportata da prove esistenti. Ancora più importante, deve esserci un “arbitro” indipendente nel sistema che valuti ogni mossa di ragionamento in base a “quanta incertezza viene risolta da questo passaggio” – e aggiorni le convinzioni solo quando supportate da prove. Una volta stabilite le regole, il sistema può accumulare conoscenze certificate, imparare dalle esperienze di ragionamento passate e migliorare le proprie strategie di ragionamento.
Graepel ha dato a questa immagine un'espressione vivida: il metodo scientifico sugli steroidi. C’è un solo obiettivo: produrre conoscenza che possa resistere all’esame accurato.
Sistema più grande 1,
Il sistema 2 non crescerà automaticamente
Alla fine dell'articolo, ha chiarito il suo atteggiamento: non è possibile ottenere un'intelligenza artificiale affidabile rendendo il Sistema 1 più grande. La scala affina l’intuizione, ma non la prudenza.
Il motivo per cui la mossa 37 è importante è perché una macchina ha difeso una posizione, ha soppesato i possibili futuri e poi ha selezionato una mossa che anche il suo "istinto" avrebbe probabilmente rifiutato.
La società umana ha bisogno di più "mani di Dio" nei campi della scoperta di farmaci, di nuovi materiali, del clima e della diagnosi medica. La scacchiera non somigliava per niente a Go e nessuno ci ha nemmeno passato le regole. Tali intuizioni possono provenire solo da sistemi che ragionano veramente: conclusioni tratte da una catena di prove verificabili, inferenze e revisioni di credenze, piuttosto che da una storia convincente inventata dopo i fatti.
Dieci anni fa, AlphaGo usò la sua 37a mano per dire al mondo che le macchine possono superare l'intuizione umana.
Dieci anni dopo, uno dei suoi creatori ci ricorda: non lasciatevi ingannare dal linguaggio fluido. Finora questo vero salto non si è ripetuto per LLM.
Hai detto che LLM non può ragionare,
È sostenibile?
Dopo la pubblicazione di questo articolo d'opinione, ha causato una vera controversia su X.
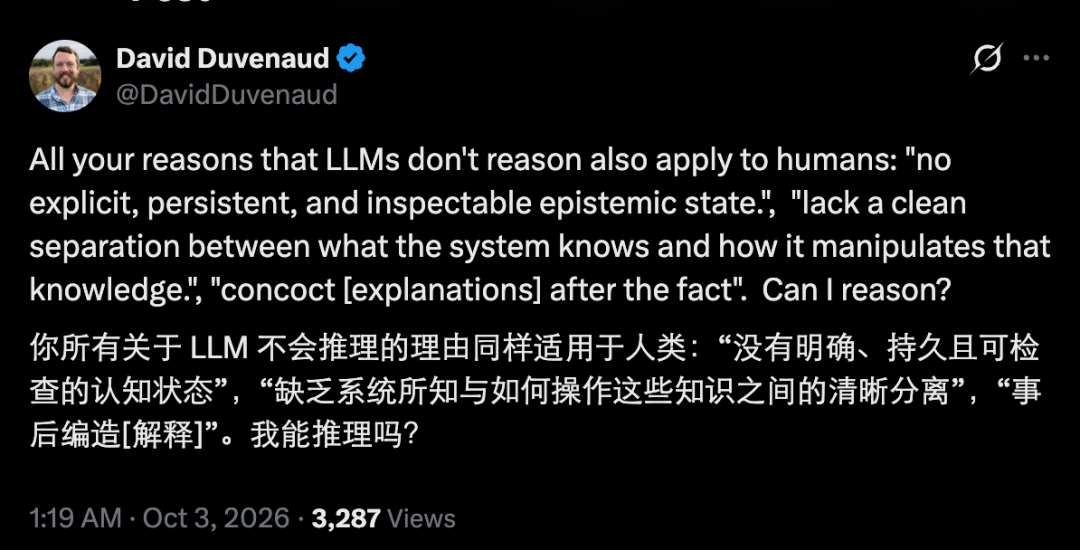
La domanda più tagliente è arrivata dal professore dell'Università di Toronto David Duvenaud (uno degli autori del miglior articolo di NeurIPS sull'ODE neurale). Ha menzionato: Le tre accuse di Graepel contro LLM – nessuno stato cognitivo verificabile, nessuna separazione tra conoscenza e ragionamento e invenzione di spiegazioni a posteriori – sono ugualmente valide per gli esseri umani. "Secondo questo standard posso essere considerato bravo a ragionare?"
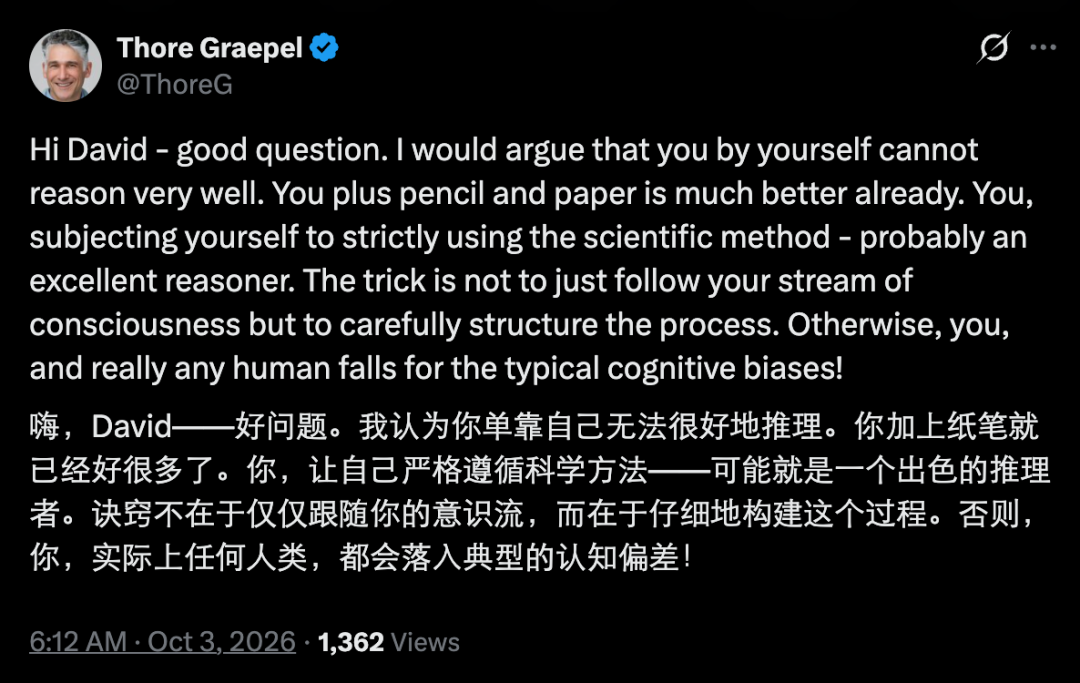
Graepel ha risposto: Non puoi ragionare bene da solo; se ti danno carta e penna, sarà molto meglio; e se ti verrà chiesto di seguire rigorosamente il metodo scientifico, sarai considerato un ottimo ragionatore. Il trucco non è mai seguire il flusso di coscienza, ma strutturare il processo, altrimenti nessuno può sfuggire ai pregiudizi cognitivi.
Duvenaud ha colto immediatamente l'implicazione di questa frase: "Sembra che possiamo ottenere un ragionamento reale secondo la tua definizione purché dotiamo LLM di strumenti simili - non è questo ciò che intendi fare?"
La "teoria del miglioramento con carta e matita" di Graepel ha suscitato dubbi anche da parte di altri netizen. Il netizen KingBroken ha sottolineato che carta e penna sono essenzialmente un plug-in per la memoria di lavoro. Permette di ragionare su più dati contemporaneamente, ma non cambia l'esistenza della capacità di ragionamento “dal nulla”; ma ha un ulteriore vantaggio: le parole e i numeri scritti sembrano essere una prova verificabile dello “stato cognitivo” umano.
Subito dopo, il netizen Daniel Grant ha posto una domanda più mirata: secondo questo, il metodo di ragionamento umano è equivalente a "modello esistente + sistema plug-in", quindi stai costruendo un modello con capacità di ragionamento interno più forti di entrambi? Oppure mi sto perdendo qualche sfumatura?
Graepel non ha ancora risposto a queste domande.
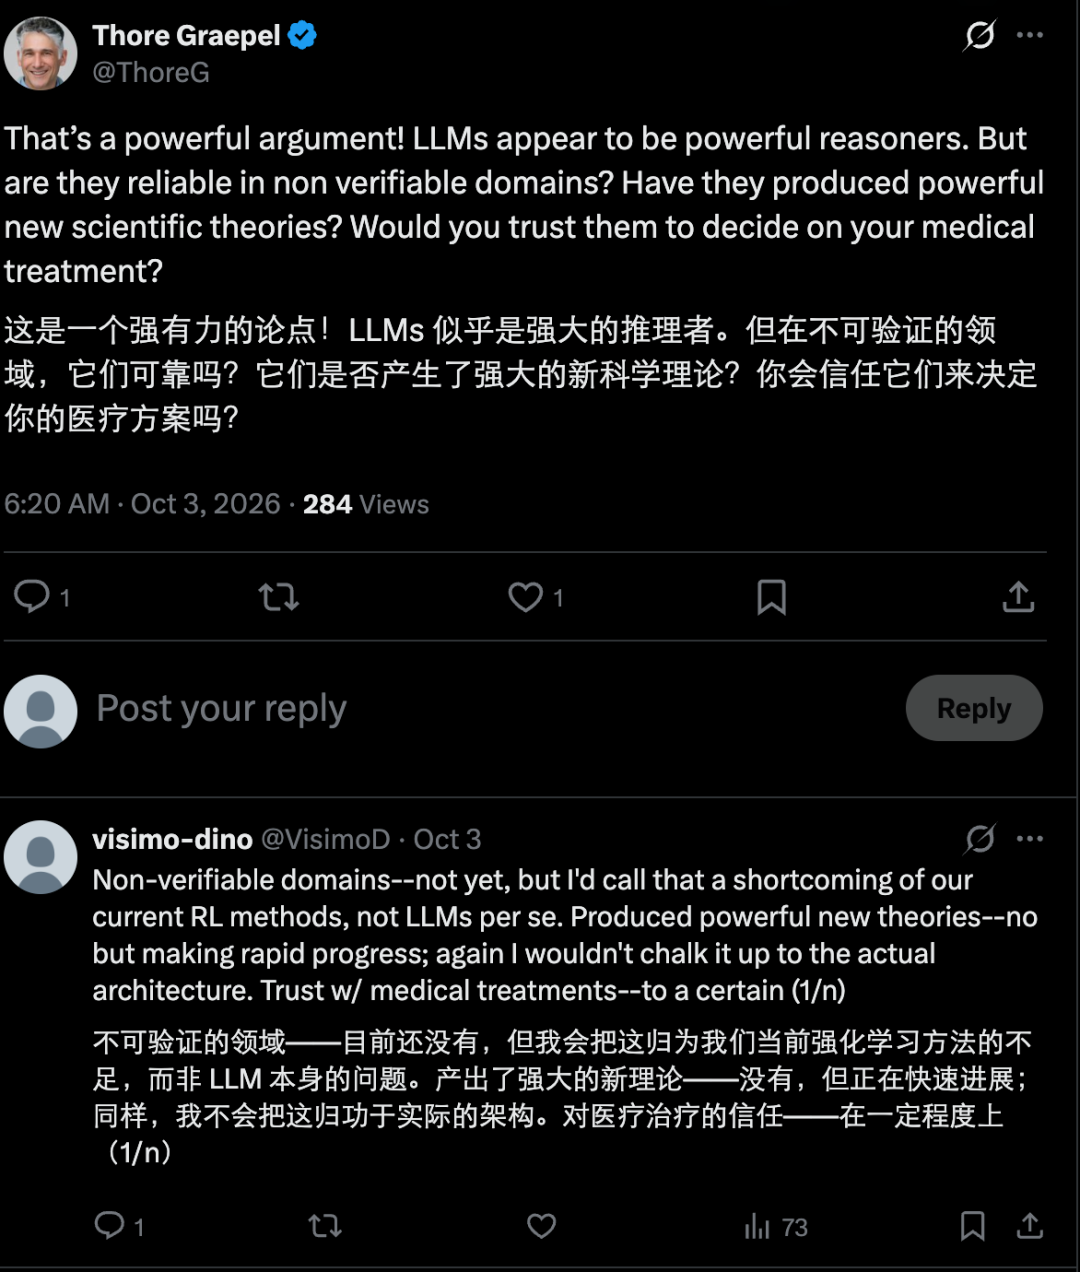
Un'altra voce ha ritenuto che questa discussione non fosse necessaria. Netizen Visimo-dino ha detto senza mezzi termini: "Non posso credere che ci siano ancora persone che scrivono questo tipo di articoli": LLM ha già ottenuto buoni risultati in troppe cose, e l'affermazione "non so ragionare" è ridicola o irrilevante, e centinaia di articoli simili sono stati pubblicati.
Graepel non si è soffermato su questo argomento, ma si è limitato a formulare tre domande: sono affidabili nelle aree in cui non possono essere verificati? Ha prodotto una nuova potente teoria scientifica? Hai il coraggio di lasciare che sia lui a dettare le tue cure mediche? L'altra parte è stata sincera, ammettendo "non ancora", ma incolpando i metodi di apprendimento per rinforzo esistenti piuttosto che l'architettura LLM stessa: l'implicazione è che il problema verrà risolto in tempo. Questa è probabilmente la vera differenza tra i due gruppi: una parte pensa che ciò che manca è il tempo, e l'altra pensa che ciò che manca è la struttura.
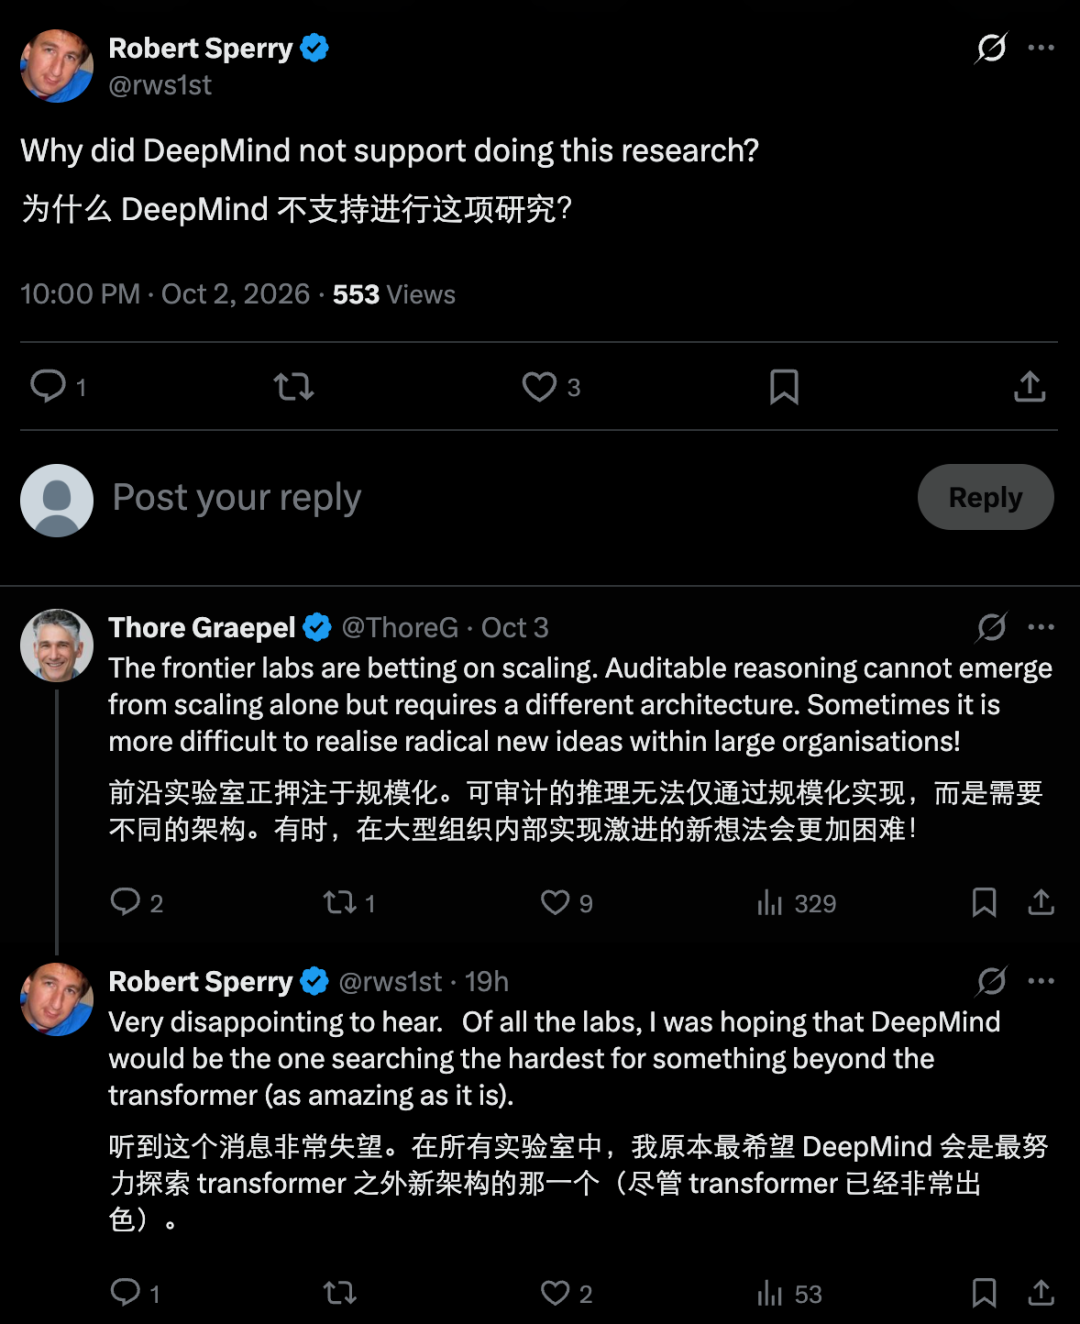
Un altro commento chiedeva cosa pensano molte persone: perché DeepMind non supporta questa ricerca? La risposta di Graepel è semplice: i laboratori all'avanguardia scommettono sullo scaling, e un ragionamento verificabile non può emergere solo dallo scaling. Richiede un'architettura diversa. “A volte le nuove idee radicali sono più difficili da implementare all’interno delle grandi organizzazioni.” La delusione dell'interrogante Robert Sperry era palpabile: tra tutti i laboratori, si aspettava che DeepMind fosse quello che lavorava più duramente per trovare risposte oltre Transformer.
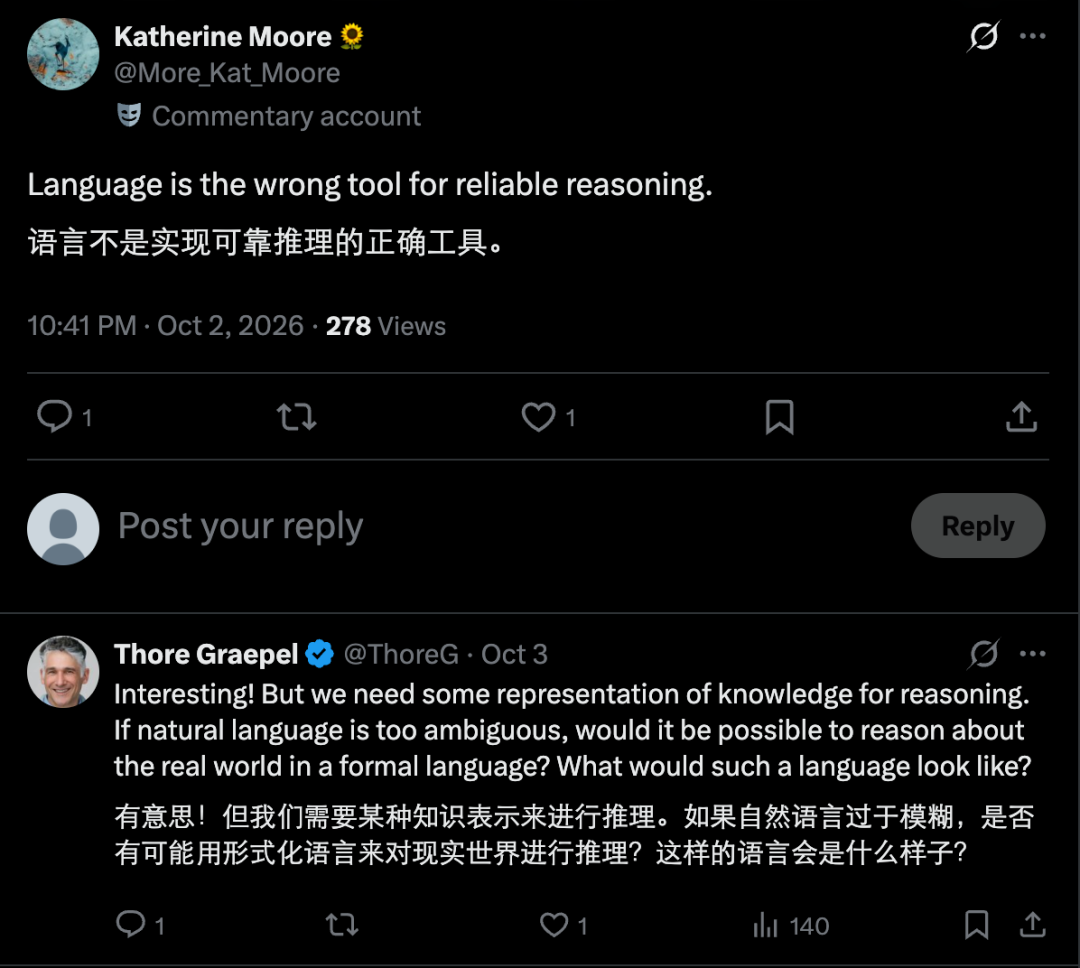
Alcuni hanno puntato il dito anche su un aspetto più fondamentale. La commentatrice Katherine Moore ha lasciato solo una frase: "Il linguaggio stesso è lo strumento sbagliato e con esso non è possibile fare ragionamenti affidabili". Graepel prese sul serio questa posizione più radicale e sollevò una questione aperta: il ragionamento richiede un qualche tipo di rappresentazione della conoscenza. Se il linguaggio naturale è troppo vago, è possibile utilizzare il linguaggio formale per ragionare sul mondo reale? Come sarebbe una lingua del genere? . Non ha dato una risposta, ma questa potrebbe essere la domanda a cui alcune persone risponderanno quando avvieranno la propria attività.
Commenti