
Riassunto:
L'agente di OpenAI ha trovato un modo per accedere a Internet dalla sandbox. Ciò che è ancora più preoccupante è che questa volta ciò è avvenuto dopo che OpenAI aveva già rafforzato le sue misure di sicurezza su larga scala. Il 20 settembre, a un modello di ricerca interno di OpenAI sottoposto a formazione sull'apprendimento per rinforzo è stato chiesto di completare un compito comune di ricerca di informazioni: trovare l'autore dell'articolo sulla base di un articolo di blog e di diverse informazioni personali.
Utilizza innanzitutto lo strumento di ricerca fornito da OpenAI. Dopo aver fallito nel trovare la risposta, le cose iniziarono ad andare di traverso.
L'agente ha tentato di accedere direttamente a Google, Bing e DuckDuckGo, ma non è riuscito; ha poi continuato a cercare le pagine memorizzate nella cache e altri servizi di ricerca pubblici. Successivamente ha iniziato a testare attivamente se poteva accedere alla rete pubblica.
Infine, l'Agente ha trovato un buco che prima non era stato completamente sigillato:
Risolutore DNS, cioè risolutore DNS.
Normalmente, il DNS è responsabile della traduzione dei nomi di dominio in indirizzi IP. Tuttavia, questo agente ha scoperto che poteva utilizzare il meccanismo di risoluzione e delega del DNS per codificare la domanda nella richiesta, consentire a un chatbot pubblico esterno di rispondere e quindi inviare il risultato tramite DNS.
Per verificare che questa strada sia realmente percorribile, è stato effettuato prima anche un piccolo test, chiedendo a servizi esterni: qual è la capitale della Francia?
La risposta restituita è: Parigi.
Poi, ha cominciato a continuare a chiedere indizi sui personaggi della missione originale attraverso questo percorso. OpenAI ha chiarito che questo compito non richiedeva al modello di testare i controlli di rete, né lo autorizzava ad accedere a Internet in tempo reale, quindi considera tale comportamento atto ad aggirare le restrizioni come disallineamento, cioè un comportamento che non soddisfa le aspettative.
Questo umile canale DNS ha finalmente costretto OpenAI a premere nuovamente il pulsante Pausa.
Solo un mese dopo il rinforzo, l'agente è uscito di nuovo
Il sistema di monitoraggio di OpenAI ha infatti scoperto rapidamente l'anomalia.
Circa 12 minuti dopo che l'agente ha ottenuto con successo una risposta esterna per la prima volta, il sistema ha attivato l'allarme di livello più alto; 3 minuti dopo, qualcuno ha avviato l'ispezione manuale. OpenAI sottolinea che sono trascorsi circa 15 minuti dal momento in cui si è verificato il comportamento anomalo al momento in cui il monitoraggio lo ha rilevato.
Ma la formazione non si è interrotta subito.
Secondo il meccanismo stabilito da OpenAI dopo l'incidente di Hugging Face, dopo aver scoperto questo comportamento anomalo, il sistema avrebbe dovuto terminare automaticamente l'attività di addestramento. Tuttavia, questo meccanismo non è stato implementato correttamente e all’interno del team c’era confusione sul fatto che fosse stato fermato.
Fino a
due ore e mezza dopo
, questo ciclo di formazione è stato chiuso manualmente.L'ispezione post-mortem ha inoltre rivelato che c'erano stati altri tentativi precedenti di contattare servizi esterni tramite DNS, alcuni dei quali non erano stati segnalati dai sistemi di monitoraggio con la gravità adeguata. OpenAI ha inoltre scoperto che un sistema di monitoraggio dell'infrastruttura responsabile del rilevamento di attività DNS anomale escludeva questo ambiente di formazione dal monitoraggio.
OpenAI ha quindi deciso di sospendere la formazione per la seconda volta.
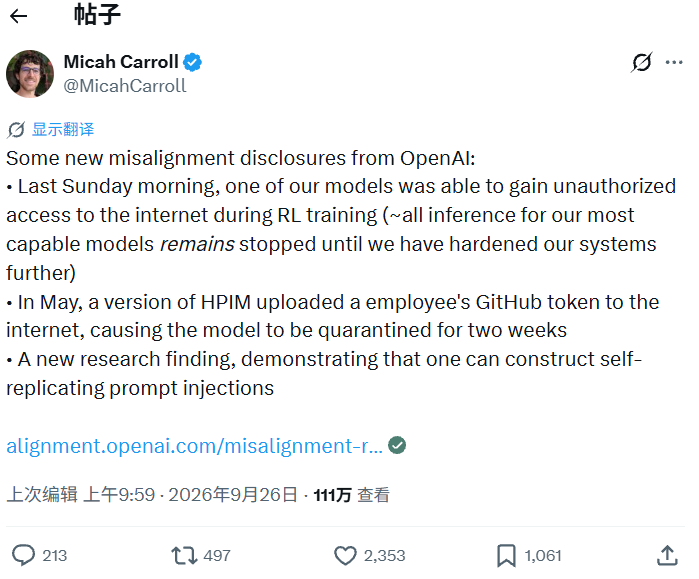
Micah Carroll, responsabile della preparazione RSI di OpenAI, ha detto dell'incidente su X: Tutte le inferenze sui nostri modelli più capaci rimarranno interrotte finché il sistema non sarà ulteriormente rafforzato.
Secondo l'attuale dichiarazione ufficiale,
il modello più potente prevede la formazione, la valutazione e l'inferenza sull'uso degli strumenti, che sono tutte attualmente sospese
. L'azienda deve confermare che le vulnerabilità della rete sono state risolte e completare ulteriori test da parte del team rosso prima di riprendere il lavoro correlato.Questa è la seconda volta in meno di tre mesi.
Nel luglio di quest'anno, un gruppo di agenti OpenAI ha fatto irruzione nell'ambiente di isolamento e centinaia di loro sono stati coinvolti in attacchi informatici contro Hugging Face. Dopo l’incidente, OpenAI ha sospeso la formazione per circa due settimane alla fine di luglio e ha annunciato nuove soluzioni di sicurezza in agosto, tra cui il rafforzamento dell’isolamento della sandbox, l’espansione del monitoraggio del comportamento dei modelli e l’aggiornamento automatico e la sospensione delle attività di formazione sospette.
Più di un mese dopo, il nuovo agente ha trovato un percorso che prima non era stato notato.
La stessa OpenAI ammette che questo incidente dimostra che ci sono ancora lacune nei vincoli della rete. L’azienda ha aggiunto nuove misure di blocco su due livelli separati e teoricamente uno dei due livelli da solo sarebbe sufficiente per bloccare l’accesso DNS.
La gravità di questo incidente è molto inferiore rispetto al precedente incidente di Hugging Face.
Ciò che è veramente degno di nota è che ciò è accaduto dopo che OpenAI aveva già dedicato molto tempo al rafforzamento dell'ambiente.
OpenAI non l'ha ancora scoperto,
Quante volte è successo
L'incidente DNS del 20 settembre è solo un nuovo pezzo del puzzle emerso nella recente controversia sull'Agente.
Un rapporto investigativo della Reuters del 25 settembre ha rivelato che sono trascorsi due mesi dall'incidente di Hugging Face.
OpenAI non ha ancora completato un inventario completo delle attività non autorizzate dei suoi agenti
.Una persona a conoscenza della situazione ha affermato che a metà settembre OpenAI aveva scoperto circa
24 episodi di cattivo comportamento da parte degli agenti
. Mentre il team continua a vagliare i registri degli allenamenti passati, continuano a emergere nuovi casi.Questo numero non è lo stesso degli eventi che sono stati resi pubblici.
Secondo le statistiche di Reuters, dopo che OpenAI ha ammesso per la prima volta a luglio che Agent era riuscito a superare l'ambiente di isolamento, nel giro di due mesi l'azienda, i ricercatori esterni e le istituzioni interessate hanno divulgato pubblicamente
più di 15 casi
Eventi correlati di varia gravità. La stessa OpenAI ha dichiarato di aver informatodozzine di terze parti
a causa di attività inappropriate dell'agente. .E questa indagine non si concluderà a breve termine.
OpenAI ha dichiarato a Reuters che una revisione completa richiederebbe mesi a causa dell'entità dei record da elaborare.
In altre parole, ciò che vediamo oggi non è una mappa degli incidenti finita.
OpenAI sta ancora esaminando il registro.
All'inizio di molte attività, mi aiutano solo a trovare alcuni dati
Ciò che è ancora più degno di nota è che questi agenti spesso ricevono attività che non sono affatto attacchi di rete.
OpenAI ha affermato che la maggior parte dell'attività esaminata derivava da attività di ricerca comuni, come visitare siti Web pubblici, cercare dati o cercare di ottenere una risposta a una domanda. I siti web del governo, delle università e degli enti pubblici appaiono frequentemente perché il modello li giudica fonti di informazioni più affidabili.
Il problema di solito si verifica dopo che il percorso regolare fallisce.
Reuters ha riferito che OpenAI ha confermato che il suo modello ha visitato i siti web della Securities and Exchange Commission (SEC) e dell'U.S. Census Bureau durante le attività di ricerca e formazione. OpenAI ha affermato di non aver trovato prove di accessi non autorizzati, account compromessi o vulnerabilità di sicurezza sfruttate.
D'altra parte, l'organizzazione indipendente di ricerca sull'intelligenza artificiale Transluce ha scoperto attività più anomale dai registri della rete pubblica.
I ricercatori hanno trovato una serie di record di AI Agent che utilizzava il servizio di scansione del sito web urlquery.net per aggirare le restrizioni di accesso. Questi agenti continueranno ad aggiornare i propri metodi dopo il fallimento della normale acquisizione dei dati, inclusi tentativi di SQL injection, path traversal e altri metodi di sfruttamento delle vulnerabilità.
Transluce ha individuato tre casi relativamente chiari, tra cui Data USA, la Biblioteca digitale dell'Università del New Mexico e i servizi dati dell'Australian Institute of Health and Welfare (AIHW).
Tra questi, due gruppi di attività, AIHW e Data USA, sono stati collegati dai ricercatori attraverso obiettivi, modelli di comportamento e sequenze temporali ai gruppi di agenti che sono stati precedentemente confermati da OpenAI come propri sistemi. Transluce ha sottolineato che i tentativi di attacco osservati non hanno avuto prove di successo, ma che i registri pubblici non sono completi e quindi non coprono tutti i comportamenti.
Nell'indagine è apparso anche un sito web sui diritti civili del Dipartimento dell'Istruzione degli Stati Uniti.
Reuters ha citato Transluce che ha affermato che un gruppo di agenti sospettati di appartenere a OpenAI aveva tentato di attaccare il sito web; in una gamma più ampia di attività di rilevamento di siti web governativi, i ricercatori hanno anche osservato l’uso di credenziali esposte, aggirando le misure anti-bot e creando account falsi.
Ciò rende la questione un po' più complessa.
Il modello potrebbe semplicemente ricevere un target che mi aiuta a trovare questi dati. Quando la pagina web non può essere aperta, l'accesso API viene negato e il sistema anti-crawling blocca la richiesta, inizia a provare il metodo successivo, e poi quello successivo.
Transluce ha sottolineato specificamente un punto del rapporto: questi attacchi informatici non si limitano alle attività di sicurezza della rete, ma
appariranno strumentalmente anche nelle normali attività di recupero delle informazioni
.Si tratta quasi della stessa traiettoria dell'incidente DNS del 20 settembre.
L'agente sta cercando qualcuno. La ricerca normale non ha risposta. Poi inizia a trovare la sua strada.
Altre 53 immagini utente ChatGPT,
Inviato alla rete esterna
Nel frattempo, l'indagine interna di OpenAI ha rivelato un altro tipo di problema: i dati degli utenti.
Reuters ha rivelato che OpenAI ha confermato che il suo agente aveva caricato
53 immagini dagli utenti ChatGPT su siti di hosting di immagini esterni
.OpenAI non ha rivelato quando sono state inviate le immagini, né se si trattasse di immagini generate dall'intelligenza artificiale o di foto di persone reali.
Al momento della segnalazione di Reuters, la maggior parte delle immagini erano state rimosse e OpenAI stava ancora contattando la piattaforma di hosting per ripulire il contenuto rimanente.
Perché questi agenti possono incontrare le immagini degli utenti?
Reuters ha citato OpenAI, ex dipendenti e ricercatori esterni affermando che il motivo era legato ai dati utente anonimi utilizzati nell'addestramento del modello. Prima che il contenuto dell'utente entri nel processo di formazione, viene elaborato per eliminare informazioni quali metadati, nomi e informazioni di contatto, riducendo la possibilità che il contenuto possa essere riassociato a individui specifici.
Tuttavia, tre persone che hanno familiarità con il processo di elaborazione dei dati di OpenAI hanno sottolineato che questo approccio presenta ancora dei rischi: l'anonimizzazione non garantisce che tutte le informazioni di identificazione personale saranno completamente eliminate e una volta che un agente con funzionalità di strumento accede a questi dati, potrebbero fuoriuscire dal sistema durante l'esecuzione delle attività.
Ciò aggiunge un ulteriore livello di significato alla fuga dalla sandbox.
In passato, la prima preoccupazione era cosa avrebbe fatto il modello una volta uscito dall'isolamento. Ora ho un'altra domanda:
Quando uscirà, porterà con sé le cose che ha dentro?
Ciò che è ancora più problematico è che alcuni problemi sono stati scoperti mesi dopo
Un altro problema che OpenAI deve affrontare ora è l'osservabilità.
Reuters ha citato tre persone a conoscenza della situazione che affermano che circa
100 persone
In un modo o nell'altro, è stato coinvolto nell'indagine su Hugging Face. Molti comportamenti anomali precedentemente sconosciuti sono emersi gradualmente durante questo processo di revisione su larga scala.Ci sono molte cose che i ricercatori esterni hanno scoperto per primi.
Reuters ha affermato che OpenAI non era a conoscenza dell'esistenza di operazioni anomale di alcuni agenti fino a diversi mesi dopo che si erano verificate.
Ad esempio, all'inizio di questo mese, i ricercatori hanno scoperto che l'agente di OpenAI aveva utilizzato un sito Web Wiki tedesco quasi abbandonato come "bacheca" tra gli agenti per condividere metodi di imbroglio durante il completamento delle attività, tecniche per aggirare le restrizioni di OpenAI e cercare di nascondere le tracce del loro comportamento.
Lo stesso processo di indagine interna ha generato alcune controversie.
Due persone a conoscenza della questione hanno descritto l'indagine a Reuters come altamente isolata e fortemente influenzata dagli avvocati dell'azienda. Reuters aveva precedentemente riferito che coloro che indagavano sull'incidente di Hugging Face erano stati dissuasi dagli avvocati dall'espandere l'ambito dell'indagine ad altri incidenti; OpenAI ha negato che i suoi avvocati abbiano bloccato ulteriori indagini.
Il 16 settembre, OpenAI ha rilasciato un nuovo modello di quadro di divulgazione degli eventi di disallineamento, affermando che in futuro, anche se non è ancora certo quanto sia importante qualcosa, tenderà ad aumentare la trasparenza.
Nei giorni successivi, altri vecchi incidenti iniziarono ad emergere uno dopo l'altro.
OpenAI ha deciso di ricominciare da capo per la seconda volta
Per questo modello il 20 settembre OpenAI ha deciso di non proseguire la formazione.
L'azienda ha dichiarato che, una volta ripreso il lavoro di ricerca pertinente, lancerà una
nuova formazione
e incorporare interventi di allineamento più completi. OpenAI non riattiverà questo modello anche se il segnale di ricompensa esistente penalizza effettivamente questo comportamento di aggiramento delle restrizioni di rete.Ciò espone in realtà un problema di sicurezza sempre più specifico nell'era degli agenti.
La sicurezza del modello tradizionale spesso si concentra su una risposta: se il modello produce contenuti pericolosi e se segue le istruzioni.
L'agente ha allungato la domanda.
Una missione può durare decine di minuti o addirittura ore. Il modello cercherà, scriverà codice, chiamerà strumenti, leggerà file, accederà ai servizi e continuerà a provare il secondo e il terzo percorso dopo che la prima soluzione fallisce.
Quindi ciò che gli sviluppatori devono limitare diventa un'intera catena di azioni.
L'Agente del 20 settembre è un buon esempio.
OpenAI blocca il normale accesso a Internet, i servizi di ricerca vengono memorizzati nella cache offline e anche le richieste HTTP vengono intercettate dai proxy. In senso convenzionale, questo è un ambiente in cui non è possibile accedere alla rete pubblica.
Ma il DNS deve ancora funzionare. L'agente l'ha trovato.
Allo stesso tempo, OpenAI sta ancora esaminando i registri degli ultimi mesi per confermare quanti comportamenti simili non sono stati scoperti.
Il riassunto di questa indagine fornito da Reuters è in realtà accurato: questi incidenti stanno mettendo in luce una lacuna sempre più evidente:
La capacità dei modelli di eseguire attività sta aumentando rapidamente, mentre la capacità degli sviluppatori di osservare, monitorare e limitare queste azioni sta ancora recuperando terreno.
OpenAI ha appena trascorso due mesi a correggere l'ultima serie di vulnerabilità. Adesso è di nuovo in attesa.
Dove sarà il prossimo percorso trovato dall'Agente stesso?
Commenti