
Riassunto:
DeepSeek rilascia il modello grande V4.1 Flash-1017. In un momento in cui il mercato attende con impazienza l’aggiornamento dei grandi modelli di intelligenza artificiale domestica, DeepSeek è il primo a lanciare una nuova versione. Questo aggiornamento apporta miglioramenti significativi delle prestazioni.
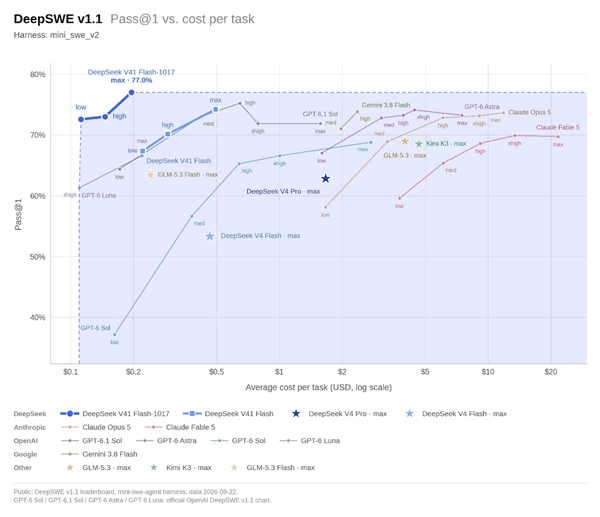
I livelli di prestazione specifici e le modifiche sono stati segnalati in precedenza. Dovresti notare che DeepSeek questa volta ha pubblicato anche una curva di Pareto, che viene spesso chiamata linea di morte dell'IA. V4.1 Flash-1017 questa volta è a un livello divino. Il costo per operazione è solo tra 1/50-1/100 dei modelli grandi come Fable e Astra, e il rapporto prezzo/prestazioni è almeno quaranta o cinquanta volte superiore.
Come ha fatto DeepSeek a raggiungere una simile kill line? Tutti sanno di possedere forti capacità di ottimizzazione dell’intelligenza artificiale e di poter fare del proprio meglio per ridurre i costi. La seguente immagine rilasciata da vllm_project può mostrare chiaramente quanto sia forte DeepSeek nell'ottimizzazione dell'hardware AI.
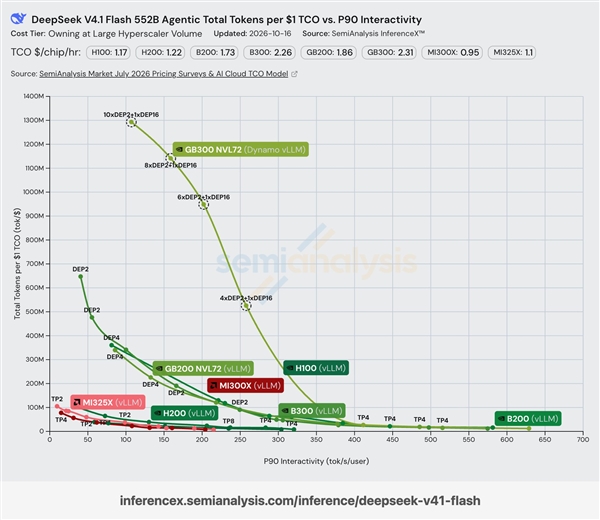
Questa immagine mette a confronto il test benchmark SemiAnalysis AgentX. Sulle piattaforme GB300 NVL72 e Dynamo vLLM, V4.1 Flash ha eseguito un punteggio di 1,3 miliardi di token per 1 dollaro USA e la velocità di interazione P90 ha superato 100 tok/s/utente.
1 dollaro USA equivale a 1,3 miliardi di token, quindi 1 milione di token costa solo 0,00077 USD, che è molto più economico del prezzo di input di V4.1 Flash di 0,15 USD.
Naturalmente questi due prezzi non possono essere convertiti in modo così semplice. Il costo Tco di 1 USD e 1,3 miliardi di token riguarda la potenza di calcolo e i prezzi delle API devono tenere conto di situazioni più complesse. Tuttavia, il costo estremamente basso di DeepSeek offre loro un vantaggio senza rivali in questo senso.
Poiché DeepSeek V4.1 Flash presenta un incredibile vantaggio in termini di costi, le principali piattaforme osano offrire tariffe estremamente basse. L’utilizzo del pacchetto da 10 dollari di OpenCode e CommandCode ha recentemente raggiunto gli 80-120 dollari. OpenCode è stato gratuito e aperto negli ultimi due giorni. Ora l'utilizzo di Flash V4.1 sulla piattaforma di routing aggregata è al livello di 100 miliardi di token e un'azienda può eguagliare l'utilizzo di sei o sette amici.
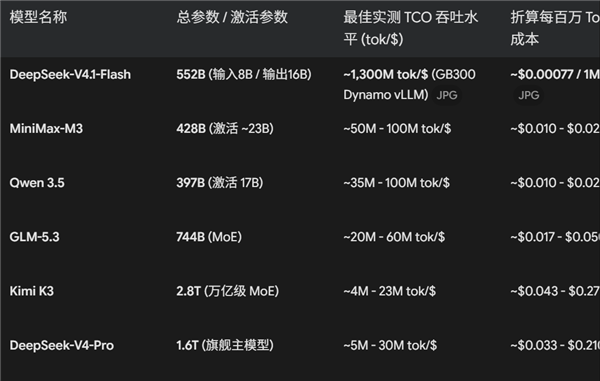
Lascia che l'intelligenza artificiale confronti i costi TCO di più modelli open source di grandi dimensioni. L'output di altri modelli di grandi dimensioni con un trilione di parametri è al massimo 1/10 di V4.1 Flash. Se si tratta di un modello di grandi dimensioni con 1,5-3 trilioni di parametri, la differenza di costo può raggiungere più di 40-50 volte, il che è del tutto incomparabile.
Va inoltre notato che il costo TCO è ancora quello della versione V4.1 Flash-0910, non della versione 1017 rilasciata oggi. Sebbene il prezzo API di quest'ultimo non sia cambiato, ha notevolmente ottimizzato l'efficienza dei token e ridotto il consumo di token. Il grado varia a seconda dei compiti. In termini somatosensoriali, il consumo è stato ridotto almeno della metà, il che significa che il costo TCO può essere nuovamente notevolmente ridotto.
Commenti