
Riassunto:
Questa mattina è arrivato il modello più potente di SpaceXAI, Grok 4.7. C'è solo una posizione molto "offensiva" all'inizio della pagina di rilascio: il modello più potente per la programmazione e il lavoro di conoscenza, due volte più veloce dei modelli comparabili e solo la metà del prezzo.
Questo aggiornamento non si ferma ai benchmark. Grok 4.7 passa a un modello base più ampio, rafforza le attività a lungo termine, le capacità di autoesame e di gestione del contesto lungo e include documenti, presentazioni, lavoro legale, medico e ingegneristico e altro lavoro professionale nei test chiave. Lo scenario a cui si rivolge è molto chiaro: consentire al modello di evitare deviazioni in attività che durano diverse ore e fornire risultati che possono essere utilizzati direttamente.
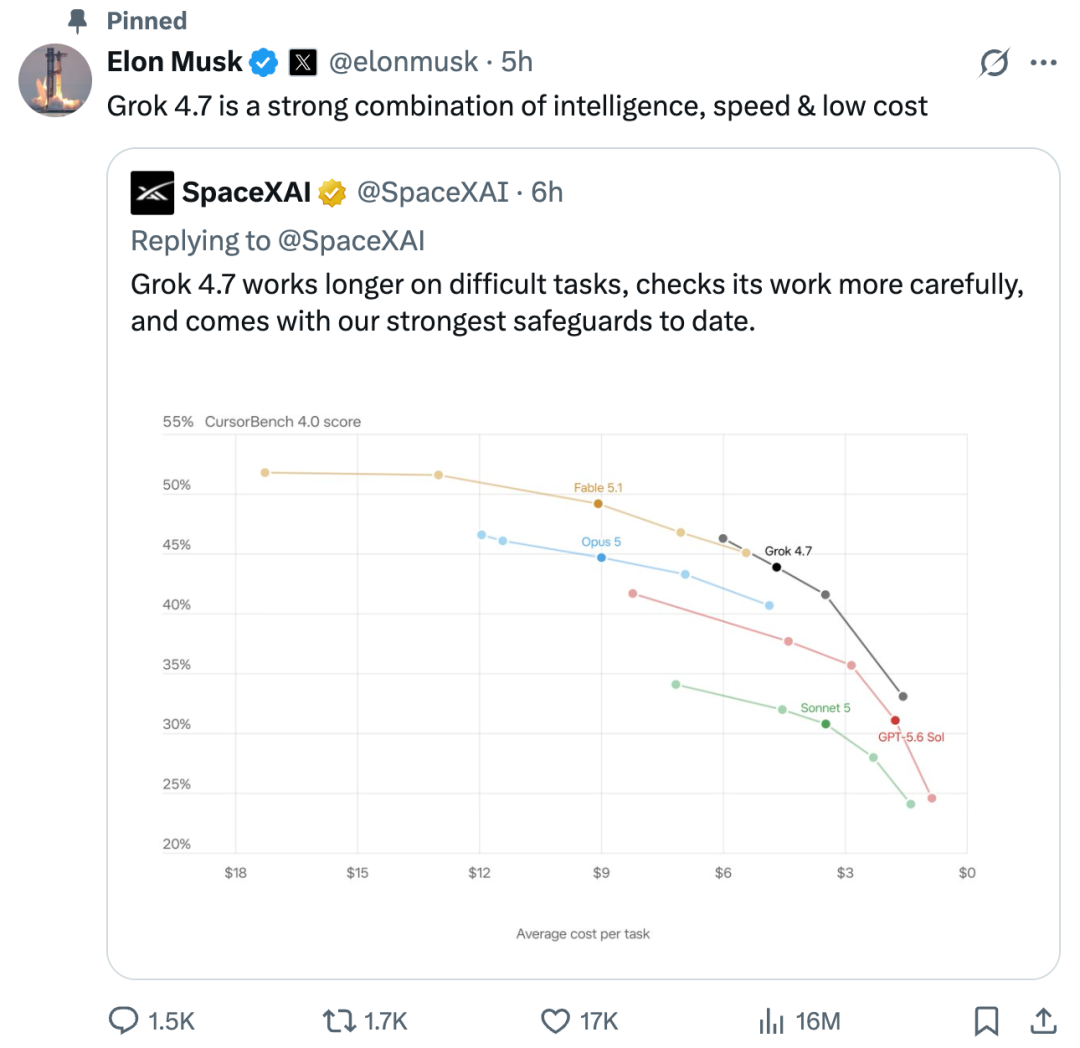
Musk ha twittato: "Grok 4.7 raggiunge un equilibrio molto competitivo tra livello di intelligenza, velocità operativa e costi."
Le missioni lunghe sono diventate il campo di battaglia principale di questa generazione di modelli
Grok 4.7 utilizza un modello base più grande rispetto a Grok 4.6. La fase di addestramento estende il periodo di apprendimento per rinforzo e le combinazioni di attività diventano più difficili, con più campioni che richiedono ore per essere completati. SpaceXAI ha affermato che il nuovo modello ha migliorato la sua capacità di ispezionare il proprio lavoro e gestire contesti lunghi.
Questo tipo di miglioramento corrisponde direttamente ai problemi più difficili dell'attuale programmazione di agenti intelligenti. La generazione di codici brevi spesso richiede solo un giudizio parziale, ma attività software veramente complesse includono la lettura del magazzino, lo smantellamento dei requisiti, la modifica di più file, l'esecuzione di test e la correzione di errori ripetuti. La capacità del modello di mantenere gli obiettivi e di rilevare gli errori in una lunga catena di esecuzione è spesso più importante che scrivere un bel codice in una volta sola.
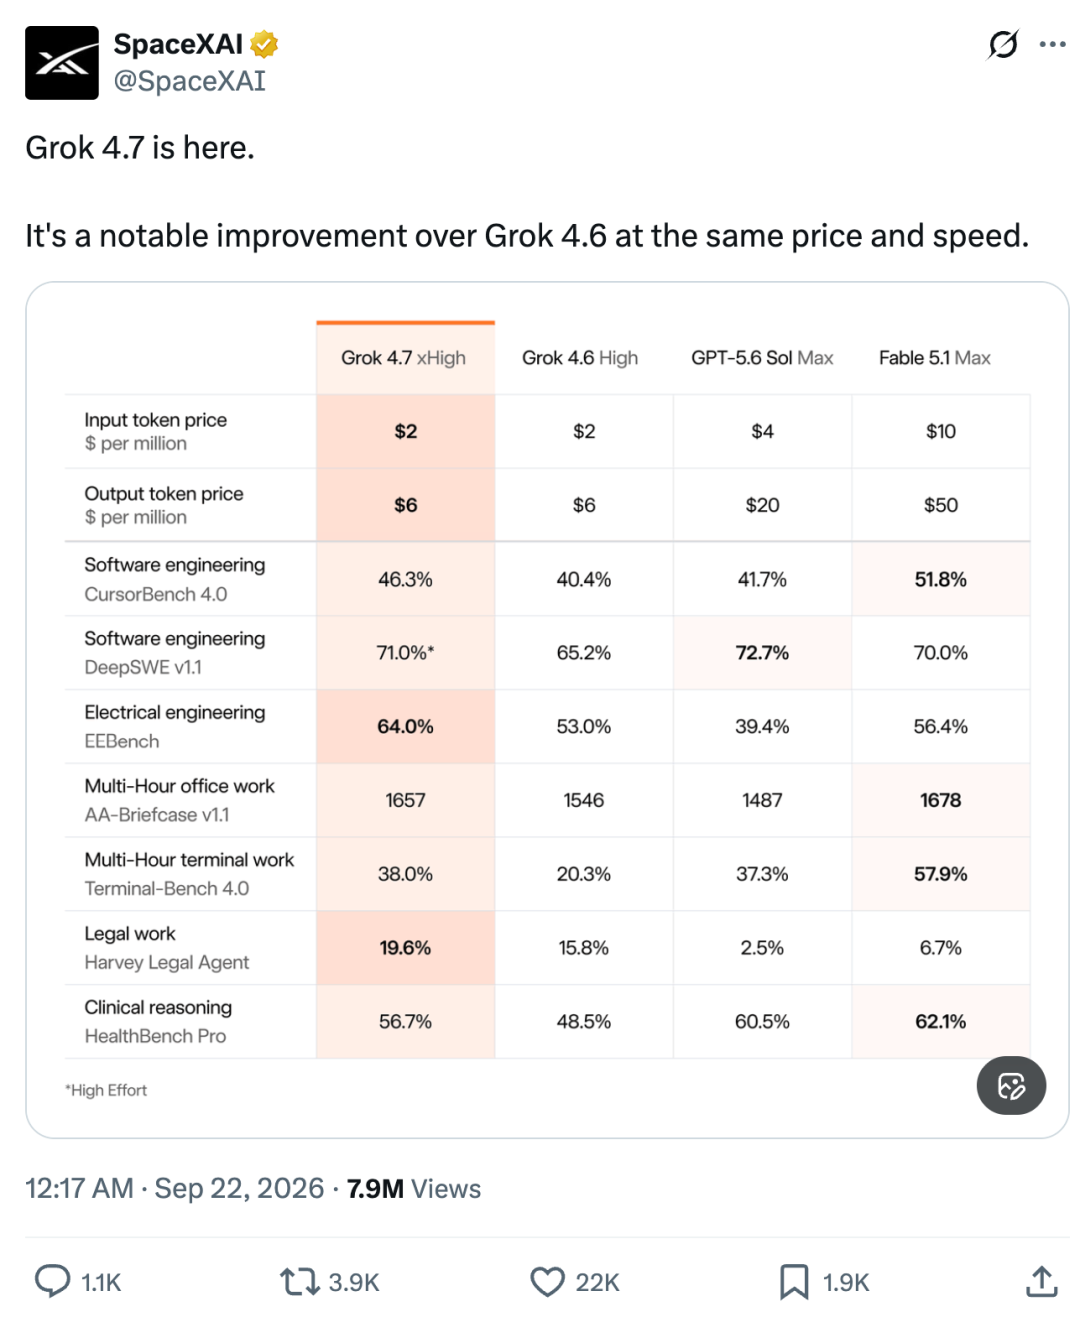
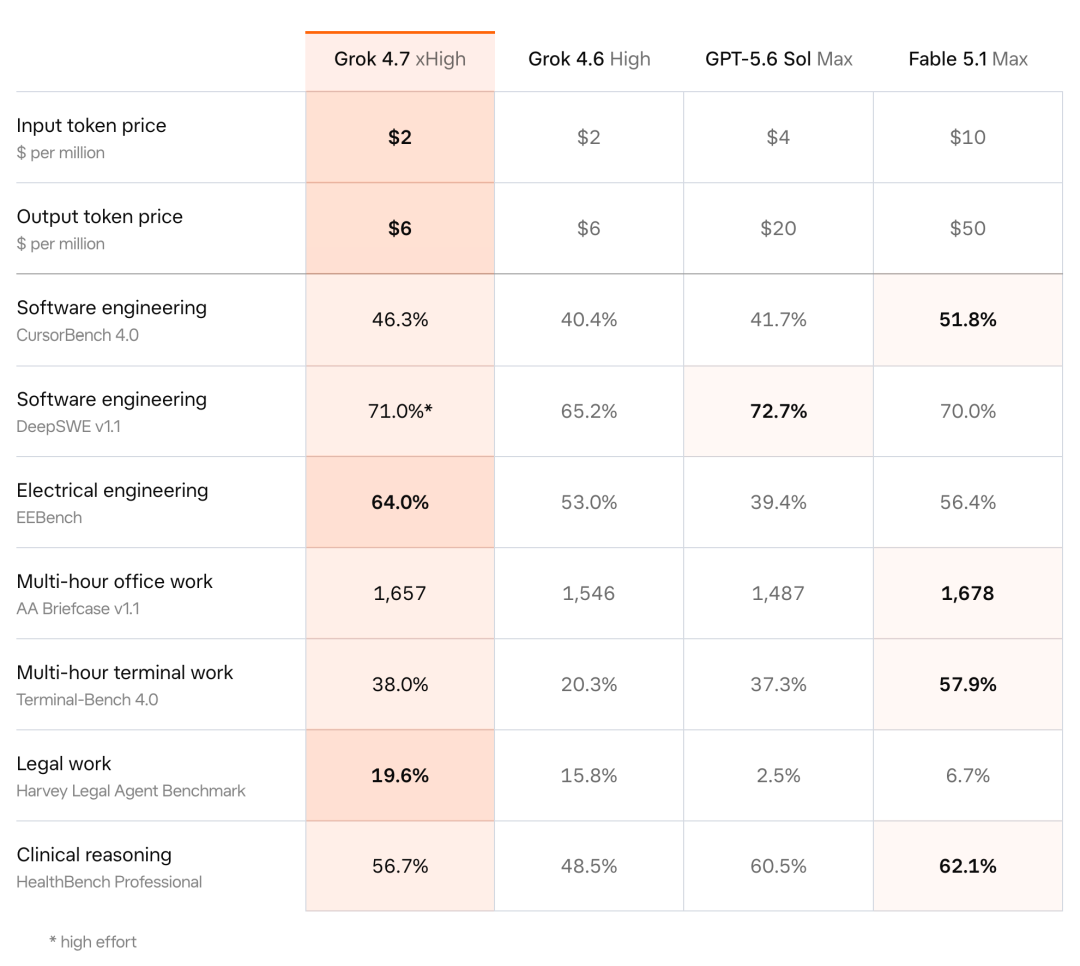
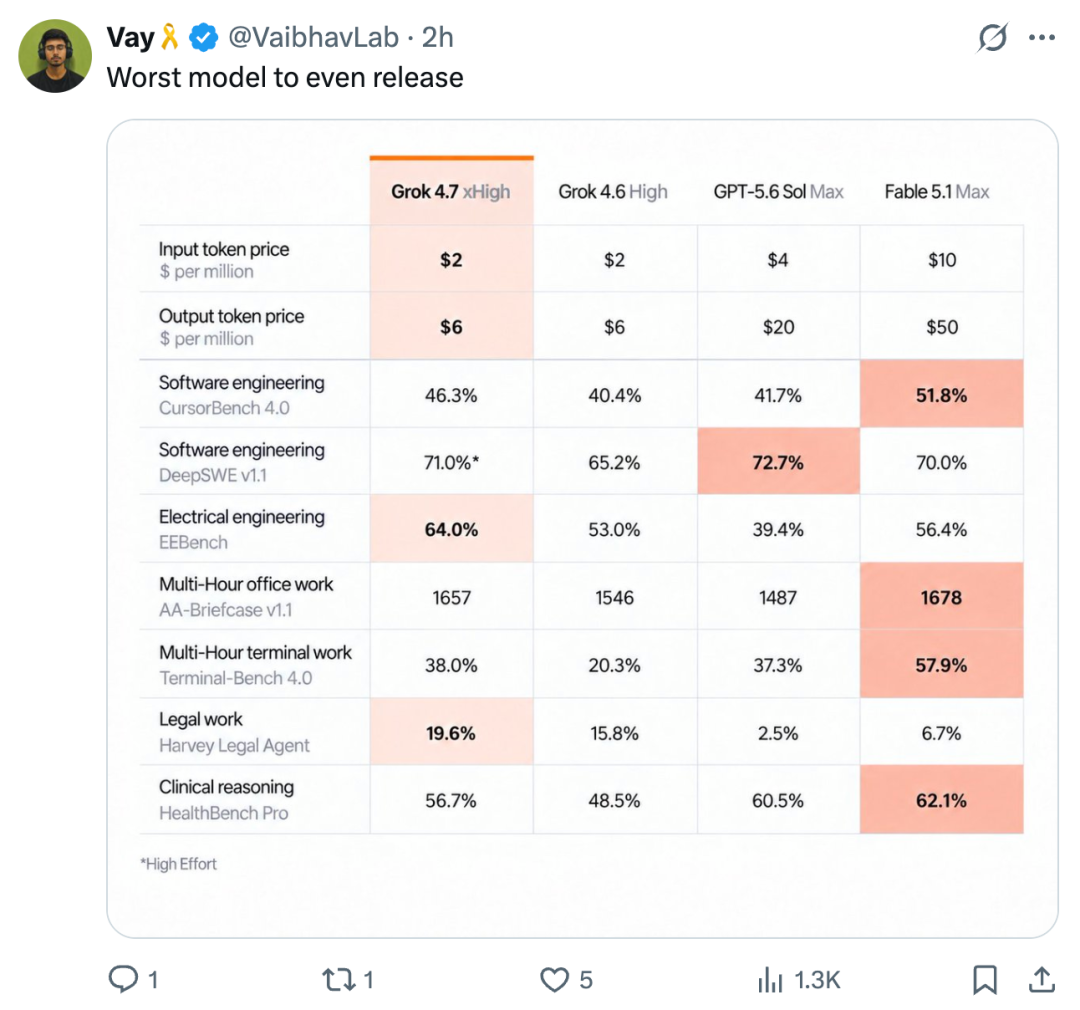
CursorBench 4.0 esamina in modo specifico le attività di codifica a lungo termine. Nei dati ufficiali Grok 4.7 ha ottenuto il 46,3% e Grok 4.6 il 40,4%, con un aumento di 5,9 punti percentuali. Su DeepSWE v1.1, il punteggio di intensità ad alta inferenza di Grok 4.7 era del 71,0%; Terminal-Bench 4.0 è aumentato dal 20,3% della generazione precedente al 38,0%.
Di conseguenza, Grok 4.7 è definito il modello all'avanguardia in termini di prezzo e prestazioni su CursorBench 4.0.
Il modello è inoltre addestrato per comprendere in modo nativo il framework all'interno del quale viene eseguito Grok Bot. Ufficialmente, questo aggiustamento migliora le prestazioni nei compiti di dialogo e nei compiti di conoscenza generale. In altre parole, l'obiettivo dell'aggiornamento di Grok 4.7 si è esteso da un singolo ciclo di risposte alla collaborazione continua tra modelli, strumenti e ambienti di esecuzione.
Dalla scrittura del codice al completamento del lavoro di conoscenza
La programmazione è ancora l'etichetta più accattivante di Grok 4.7, ma l'ambito della valutazione fornita da SpaceXAI è significativamente più ampio. AA Briefcase e GDPval si concentrano sul lavoro in più fasi che i professionisti completano ogni giorno, coprendo compiti comuni in posizioni come avvocati, infermieri e analisti finanziari, nonché la produzione di documenti e presentazioni.
Su AA Briefcase v1.1, Grok 4.7 ha ottenuto 1657 punti, più dei 1546 punti di Grok 4.6; il punteggio GDPval Elo è aumentato da 1605 a 1695. Nel grafico ufficiale, è vicino ai 1735 punti di Fable 5.1 su GDPval e superiore ai 1542 punti di GPT-6 Astra. SpaceXAI ha concluso che Grok 4.7 ha sovraperformato la generazione precedente in entrambi i test e nel complesso si è comportato alla pari con altri modelli all'avanguardia.
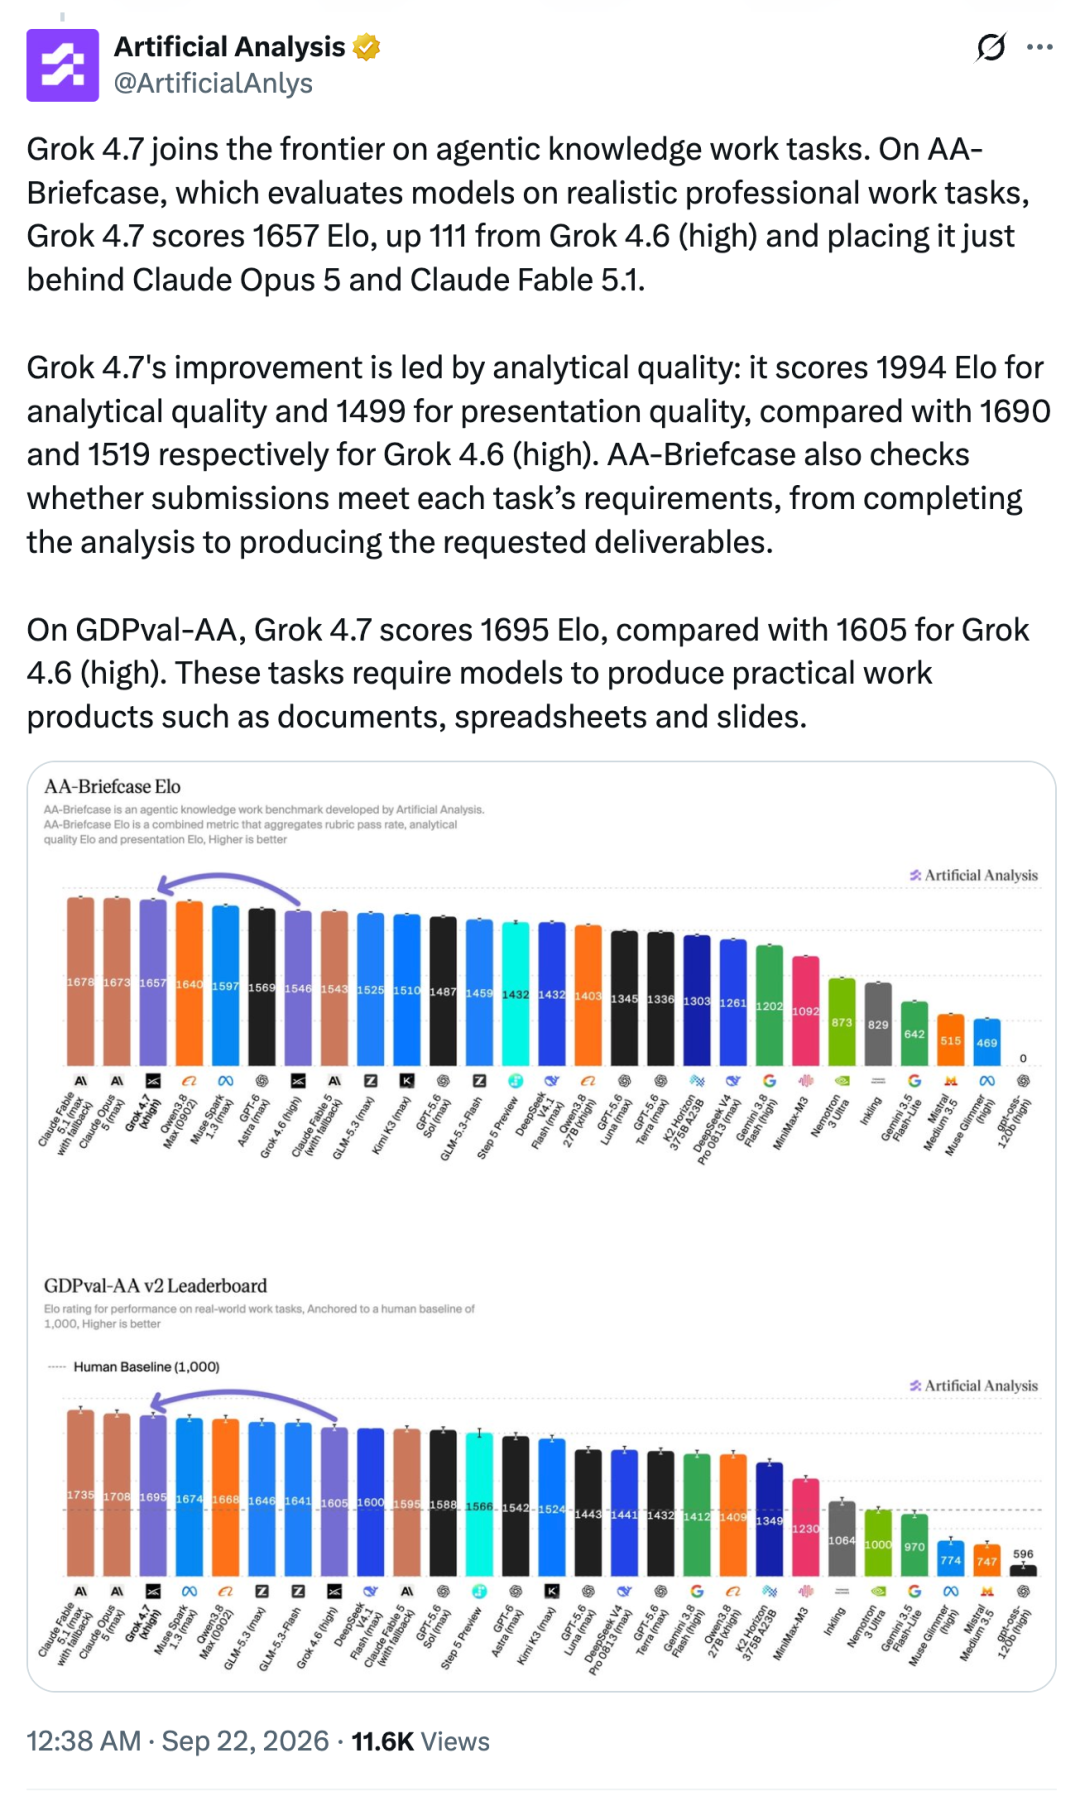
Anche le promozioni in campo professionale avvengono in molte direzioni. Il punteggio EEBench è aumentato dal 53,0% al 64,0%, l'Harvey Legal Agent Benchmark è aumentato dal 15,8% al 19,6% e l'HealthBench Professional è aumentato dal 48,5% al 56,7%. Questi risultati provengono da una tabella comparativa interna pubblicata da SpaceXAI, che può illustrare i cambiamenti tra la vecchia e la nuova generazione di modelli; i confronti tra modelli saranno comunque influenzati dall'intensità dell'inferenza, dalla configurazione dello strumento e dall'ambiente di test.
Questi risultati rivelano una tendenza chiara: la competizione per i modelli all'avanguardia sta entrando nella fase del "completare l'intero lavoro".
Il modello deve comprendere l'attività, richiamare strumenti, produrre file e rivedere se stesso. La capacità di domanda e risposta singola è solo una parte di esso. Grok 4.7 estende la durata dell'attività di formazione e rafforza l'autoverifica, che è esattamente ciò che compensa questo tipo di flusso di lavoro.
Sicurezza e prezzo
Oltre alle funzionalità migliorate, Grok 4.7 ha abilitato un nuovo sistema di protezione della sicurezza. SpaceXAI ha affermato che questo è il modello che ha testato con le prestazioni più elevate in termini di negazione della risposta e resistenza al jailbreak.
In termini di test di biosicurezza, Grok 4.7 ha superato il benchmark LatchBio con un punteggio del 62,4%. I test di sicurezza informatica HackerBench v0.3 coprono principalmente attività ad alto rischio e dannose. Secondo i dati ufficiali, il modello rilascia solo il 3,3% dei suggerimenti a duplice uso ad alto rischio e raramente blocca per errore le normali richieste di ricerca sulla sicurezza.
SpaceXAI ha anche iniziato ad aprire le funzionalità della squadra rossa solo su invito a un numero limitato di partner di sicurezza informatica per la ricerca difensiva. Attualmente, questa funzionalità del team rosso è inizialmente disponibile come collaborazione controllata.
La versione standard continua al prezzo originale e la velocità della versione veloce è raddoppiata
Grok 4.7 è stato lanciato su Cursor e Grok Build e viene fornito tramite Grok API, framework di programmazione di terze parti, servizi di model routing e piattaforme cloud. La versione standard parte da 2 dollari per milione di token di input e 6 dollari per milione di token di output, in linea con Grok 4.6.
La strategia dei prezzi rende questo aggiornamento più efficace. Gli sviluppatori non devono pagare costi aggiuntivi per i token della versione standard per l'aggiornamento, ma possono ottenere prestazioni di attività a lungo termine più efficaci, capacità di autoesame e risultati di lavoro professionali.
Per gli agenti di programmazione e i prodotti del lavoro basato sulla conoscenza, il prezzo unitario di ciascuna chiamata di modello è ovviamente importante. Il numero di tentativi e rielaborazioni necessarie per completare un'attività determina in definitiva il costo reale.
Riassumi infine questo aggiornamento:
Dai metodi di allenamento alle combinazioni di valutazione, Grok 4.7 rafforza la stessa cosa: rimanere a lungo nelle attività e completare attività complesse. La programmazione è solo il primo punto di ingresso maturo. La documentazione, la presentazione, l'analisi legale, il ragionamento clinico e le attività di ingegneria sono state inserite nello stesso insieme di capacità.
Ma i netizen non sembrano crederci. "Questo modello osa davvero essere rilasciato. È così brutto che non dovrebbe essere rilasciato." Posso solo dire rispettosamente che il punto di forza di Grok 4.7 questa volta non è quello di schiacciare completamente i prodotti concorrenti. Utilizza un costo API di gran lunga inferiore rispetto ad alcuni modelli di punta in cambio di prestazioni abbastanza vicine e leader nelle singole attività professionali.
Link di riferimento:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
Commenti