
Riassunto:
I ricercatori della Maynooth University in Irlanda hanno sviluppato un nuovo tipo di computer a DNA che non si basa sui tradizionali chip di silicio e sull'immissione continua di energia elettrica, ma utilizza l'interazione tra le molecole di DNA per completare operazioni matematiche. Il sistema è in grado di eseguire operazioni come addizione, sottrazione, moltiplicazione e divisione e negli esperimenti ha elaborato con successo calcoli complessi che coinvolgono dati a 100 bit.
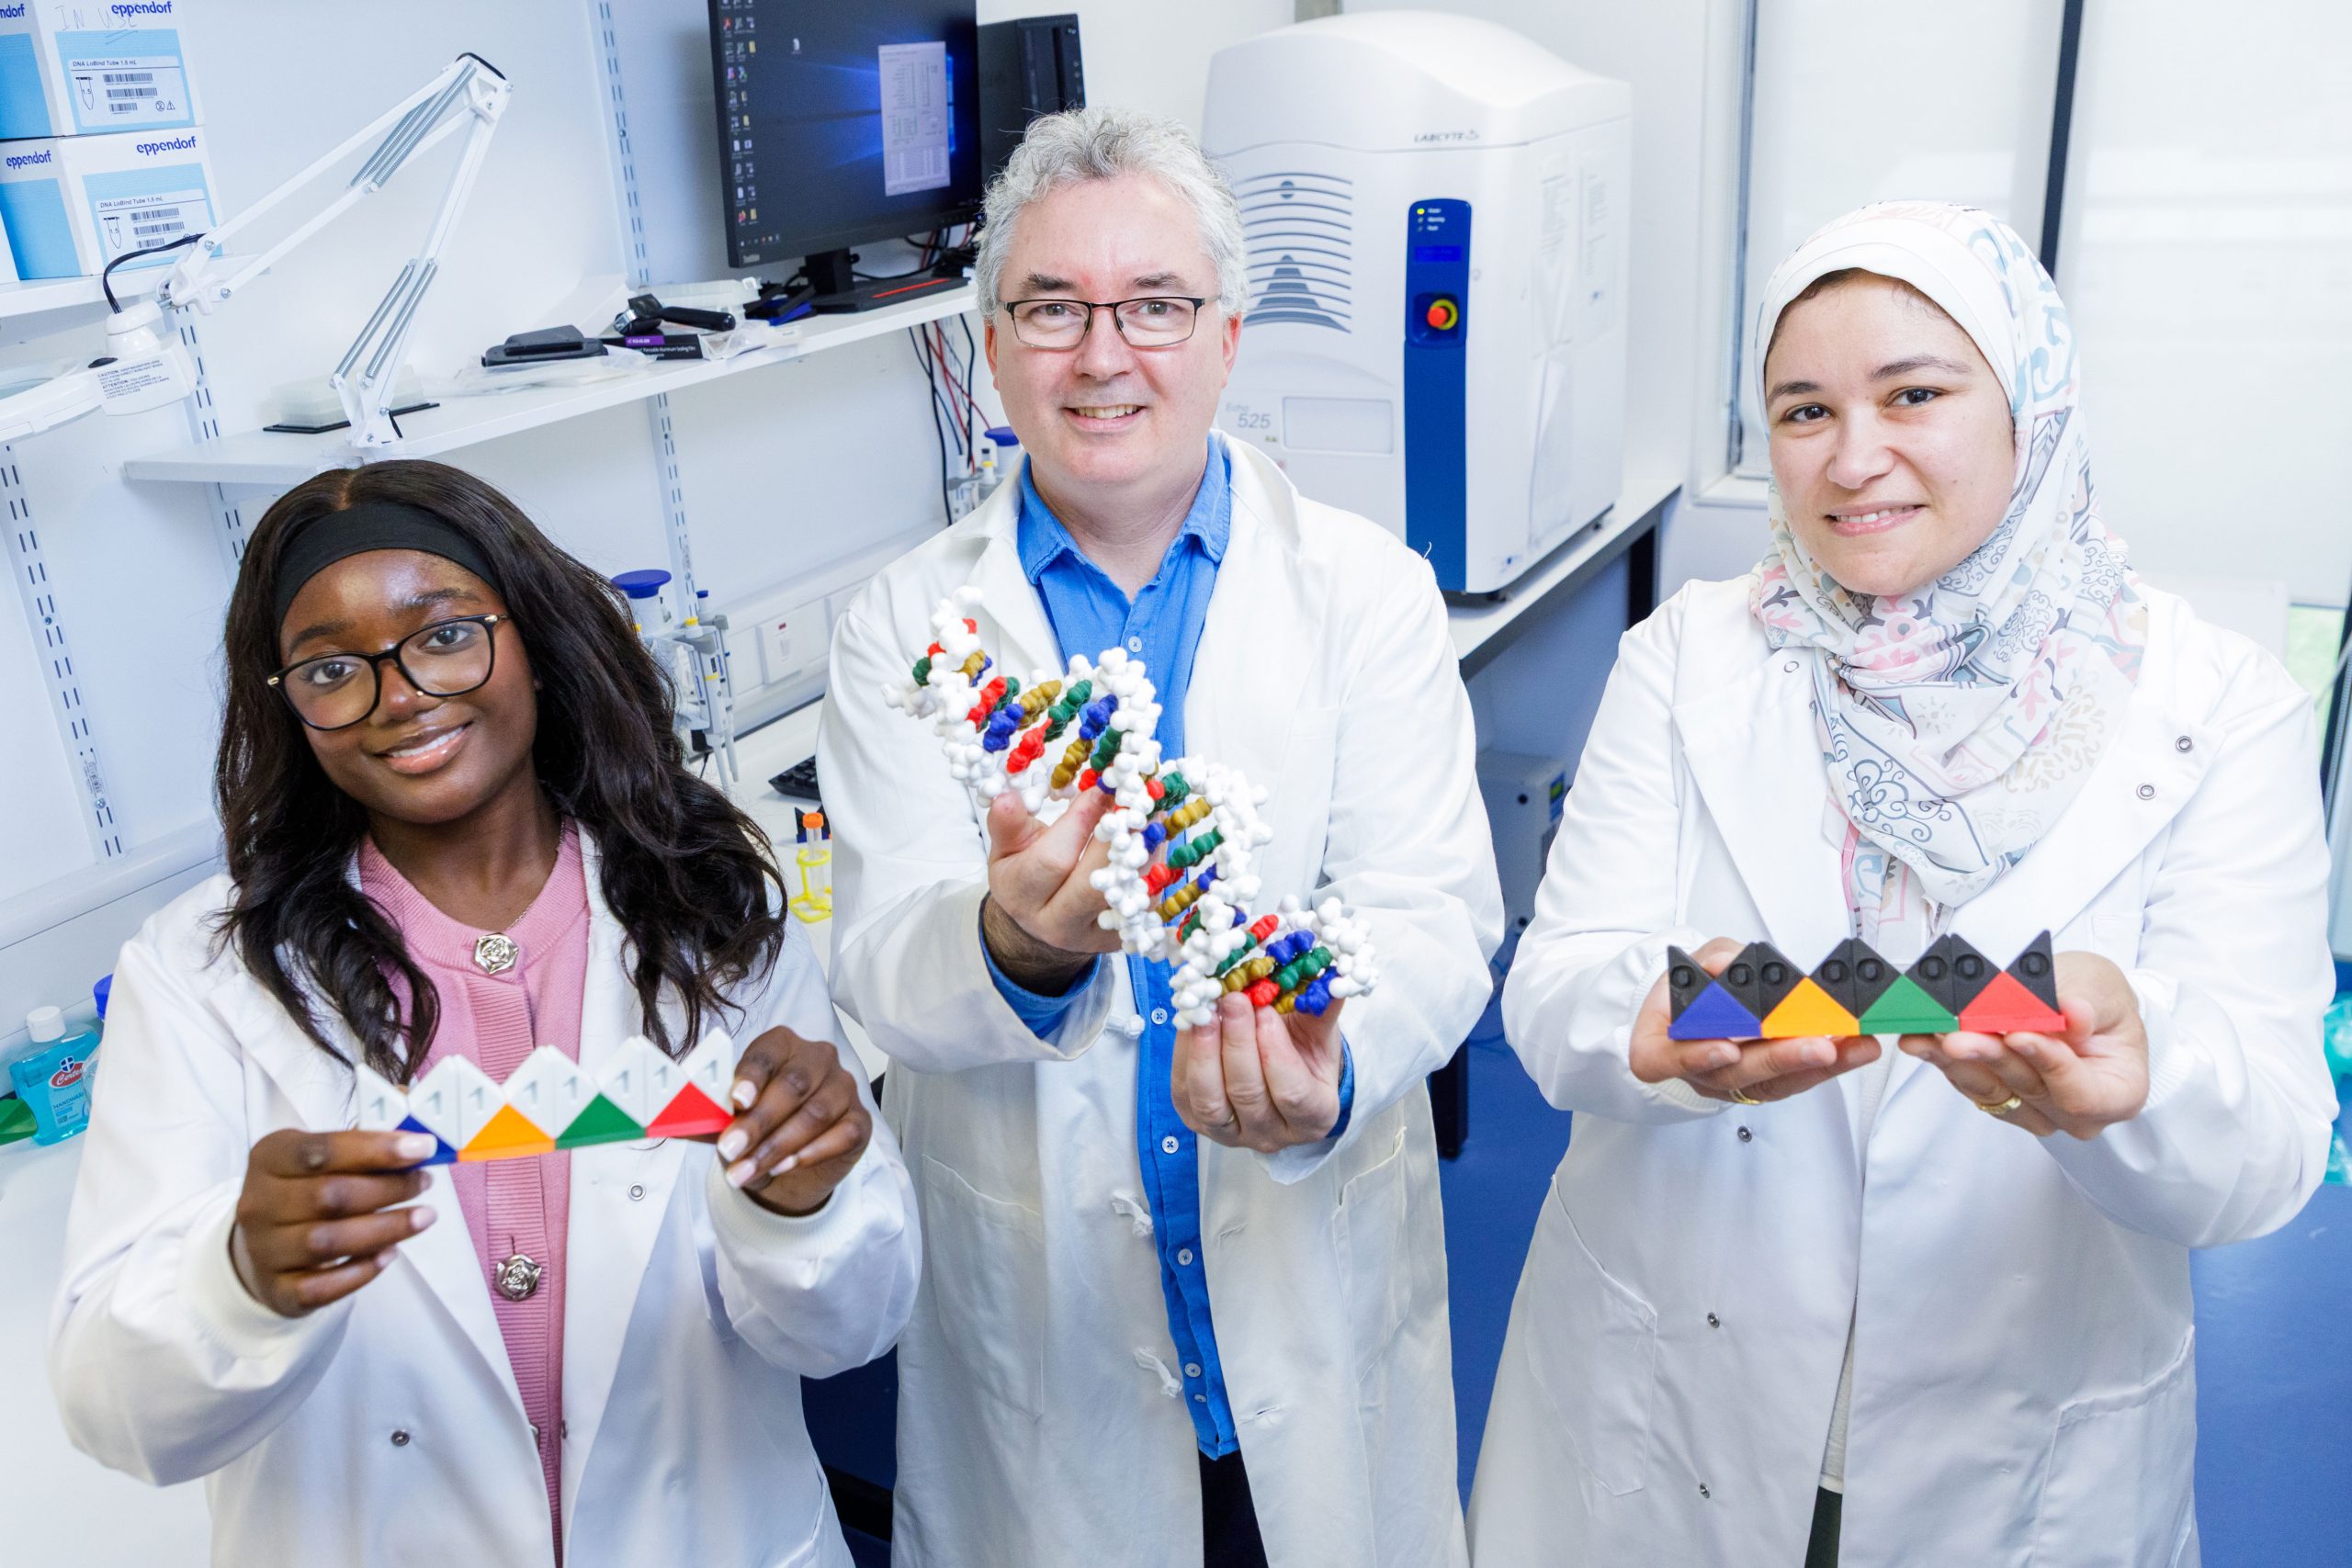
I ricercatori hanno affermato che il sistema non solo ha la capacità di essere riutilizzato, ma può anche fare affidamento sull'interazione delle molecole stesse per completare i calcoli dopo l'avvio, fornendo nuove direzioni di ricerca per il futuro calcolo a basso consumo energetico, l'archiviazione di dati a lungo termine e le applicazioni biomediche.
Il risultato di questa ricerca è stato pubblicato sulla rivista accademica internazionale Nature. Il gruppo di ricerca chiama questo sistema Scaffolded DNA Computer (SDC) e lo descrive come uno dei sistemi di calcolo molecolare più complessi e veloci finora descritti.
A differenza dei computer tradizionali che elaborano informazioni binarie attraverso gli stati di commutazione dei transistor, i computer a DNA utilizzano le proprietà chimiche delle molecole di acido nucleico per elaborare le informazioni. I ricercatori preprogettano le sequenze di diversi frammenti di DNA, consentendo a queste molecole di combinarsi tra loro secondo regole specifiche e, infine, formare una struttura molecolare che possa rappresentare i risultati del calcolo.
L'intero sistema non assomiglia a un computer nel senso tradizionale. Non richiede scheda madre, processore o scheda grafica, né il gran numero di transistor di commutazione ad alta velocità presenti nei tradizionali computer elettronici. Durante l'esperimento, i ricercatori devono solo mescolare acqua, sale, brevi frammenti di DNA e un'impalcatura di DNA più lunga in una provetta e, attraverso un piccolo riscaldamento e successivo raffreddamento, è possibile avviare il processo di calcolo.
Tra questi, i filamenti di DNA più lunghi fungono da impalcature e i frammenti di DNA corti vengono combinati con essi secondo regole predefinite. Al variare della temperatura, le molecole continuano a combinarsi e riorganizzarsi, formando gradualmente una struttura più stabile. La disposizione molecolare finale corrisponde alla risposta al problema di calcolo.
Il professor Damian Woods dell'Hamilton Institute della Maynooth University ha affermato che un'innovazione chiave di questa tecnologia è che il sistema può trovare naturalmente la risposta corrispondente senza la necessità di un apporto continuo di energia per guidare ogni fase del calcolo.
Questo metodo di calcolo si avvale dei principi della termodinamica. Quando le molecole di DNA interagiscono, diversi metodi di legame hanno diversi stati energetici. Progettando razionalmente sequenze di DNA e strutture di scaffold, i ricercatori possono far corrispondere la disposizione molecolare che rappresenta la risposta corretta a uno stato energetico più favorevole, in modo che l'intero sistema tenda gradualmente a questo stato durante il processo di autoassemblaggio.
In altre parole, invece di chiedere al processore di eseguire calcoli passo dopo passo secondo una serie di istruzioni elettroniche come i programmi tradizionali, i ricercatori codificano in anticipo le regole di calcolo nelle molecole di DNA e poi lasciano che le molecole facciano affidamento sulle proprie interazioni chimiche per trovare risultati conformi alle regole.
Questo metodo è particolarmente adatto per lo studio dei calcoli a livello molecolare. Un gran numero di molecole di DNA possono interagire simultaneamente nella stessa soluzione, quindi il sistema ha potenziali capacità di elaborazione parallela. Tuttavia, l’elevato numero di molecole non significa che tutti i calcoli possano essere completati immediatamente. La velocità finale dipende ancora da molteplici collegamenti come reazioni molecolari, assemblaggio della struttura e lettura dei risultati.
Per verificare le effettive capacità del sistema, il team di ricerca ha progettato e testato 10 diversi programmi di calcolo che coinvolgono una varietà di operazioni matematiche, comprese attività di calcolo con una scala di dati fino a 100 bit.
In un semplice esperimento, il computer del DNA ha completato con successo l'operazione di 10 più 3, che ha richiesto circa 30 secondi. Per un computer convenzionale, questo calcolo verrebbe completato quasi istantaneamente, ma per un sistema che si basa sull’autoassemblaggio delle molecole per completare il calcolo, questo risultato dimostra la sua capacità di gestire compiti di calcolo semplici.
In un altro esperimento più complesso, i ricercatori hanno chiesto al sistema di sommare numeri compresi tra circa 11 milioni e 34 milioni. A causa della scala più ampia dei calcoli, il sistema impiega fino a circa 14 ore per ottenere i risultati.
Questi esperimenti mostrano che i computer a DNA possono gestire problemi molto più complessi della semplice addizione di una cifra, ma esiste ancora un enorme divario tra la velocità di calcolo e i tradizionali chip di silicio. I ricercatori non stanno cercando di costruirlo come sostituto diretto dei normali computer, ma sperano di esplorare un altro modo per utilizzare la materia stessa per l'elaborazione delle informazioni.
Il professore assistente Abir Eshra, che ha partecipato alla ricerca, ha affermato che la velocità di risposta di questo sistema non è veloce come quella dei chip di silicio, ma le sue prestazioni presentano vantaggi rispetto ad altri computer a DNA sviluppati in precedenza. Lei ha sottolineato che l'obiettivo della ricerca non è quello di far sì che i computer a DNA superino i tradizionali computer elettronici in tutti i compiti, ma di sfruttare i potenziali vantaggi del calcolo molecolare in termini di consumo energetico ed elaborazione parallela.
Oltre alla potenza di calcolo, anche le prestazioni di riusabilità del sistema sono uno dei risultati importanti di questa ricerca. Gli esperimenti hanno dimostrato che lo stesso sistema di calcolo del DNA può eseguire continuamente fino a 25 diverse attività di calcolo senza dover ricostruire completamente il sistema ogni volta.
Per l'informatica molecolare, la riusabilità è importante. Alcuni dei primi metodi di calcolo del DNA consumavano una grande quantità di materiali molecolari, rendendo difficile continuare a utilizzare il sistema originale dopo aver completato un calcolo. Se per ogni operazione è necessario preparare nuovamente un gran numero di molecole di DNA, i costi e le difficoltà di applicazione pratica della relativa tecnologia aumenteranno in modo significativo.
Il sistema sviluppato dal team della Maynooth University può essere riutilizzato in calcoli continui, offrendo la possibilità di creare in futuro una piattaforma di calcolo molecolare più pratica. Tuttavia, la ricerca è ancora in fase di laboratorio e la stabilità del sistema in compiti più complessi, cicli più lunghi e implementazioni su larga scala necessita di ulteriori verifiche.
Lo sfondo di questa ricerca è la pressione energetica determinata dalla continua crescita delle esigenze globali di elaborazione e archiviazione dei dati.
I modelli di intelligenza artificiale, i servizi di cloud computing e i data center di grandi dimensioni richiedono un gran numero di processori per funzionare ininterrottamente. Poiché la portata dei compiti informatici continua ad espandersi, il consumo energetico dei tradizionali sistemi informatici elettronici è diventato una questione sempre più importante nello sviluppo industriale.
Woods ha sottolineato che l'informatica e l'archiviazione dei dati rappresentano una percentuale significativa del consumo di elettricità dell'Irlanda. Egli ritiene che per molto tempo le persone abbiano avuto la tendenza ad equiparare i computer ai chip di silicio e ai circuiti elettronici, ignorando però che in natura esistono altri sistemi in grado di elaborare le informazioni.
Il cervello è un esempio. Il cervello umano è in grado di completare compiti complessi di elaborazione delle informazioni con un consumo energetico molto inferiore rispetto a molti sistemi informatici moderni. Sebbene il calcolo del DNA non funzioni allo stesso modo del cervello, i ricercatori sperano di trovare nuove architetture informatiche esplorando processi fisici e chimici diversi dal tradizionale calcolo elettronico.
Il DNA stesso ha anche una densità di informazioni estremamente elevata. È composto da quattro nucleotidi base, che codificano le informazioni in diverse disposizioni. In teoria, il DNA può memorizzare grandi quantità di dati in un volume estremamente piccolo, quindi è stato a lungo considerato un potenziale mezzo per la futura archiviazione di dati ad alta densità.
Tuttavia, l'archiviazione del DNA e l'elaborazione del DNA sono due direzioni di ricerca correlate ma diverse. La conservazione del DNA si concentra principalmente su come codificare le informazioni digitali in sequenze di acidi nucleici e leggerle in modo affidabile quando necessario; Il calcolo del DNA tenta di utilizzare le interazioni tra le molecole per completare direttamente operazioni logiche o matematiche. Il focus di questa ricerca è su quest'ultimo e fornisce anche una base per la futura esplorazione di sistemi che combinano elaborazione e archiviazione.
I ricercatori ritengono che questa tecnologia potrebbe essere utilizzata in futuro per scenari specifici in cui è richiesta la conservazione delle informazioni a lungo termine, la fornitura di energia è limitata o le capacità di elaborazione parallela delle molecole possono essere pienamente utilizzate. Ad esempio, in alcuni sistemi di archiviazione dati a lungo termine, se la conservazione delle informazioni può essere integrata con parte dell’attività informatica, esiste l’opportunità di ridurre la dipendenza dalle apparecchiature elettroniche tradizionali.
In un prossimo futuro, l'informatica molecolare potrebbe anche essere combinata con la ricerca biomedica. Poiché il DNA stesso è una molecola informativa negli organismi viventi, i ricercatori sperano di esplorare se sistemi molecolari simili possano essere utilizzati per svolgere compiti specifici all’interno delle cellule o in ambienti biologici, come identificare alcuni segnali molecolari legati alla malattia.
Se realizzati in futuro, tali sistemi dovrebbero aiutare i ricercatori a sviluppare nuovi sensori molecolari o consentire a biomolecole specifiche di rispondere all'ambiente circostante. Tuttavia, l’attuale computer del DNA è ancora un sistema sperimentale che funziona in una provetta, il che non significa che gli scienziati siano stati in grado di impiantare un computer del DNA completo nelle cellule umane.
Dal punto di vista ingegneristico, ci sono ancora molti problemi da risolvere con questa tecnologia. Innanzitutto, il processo di assemblaggio delle molecole di DNA richiede temperature, condizioni di soluzione e concentrazioni di molecole adeguate, e i ricercatori devono garantire che diversi lotti di esperimenti possano produrre risultati coerenti. In secondo luogo, una volta completato il calcolo, il sistema deve anche leggere la struttura molecolare attraverso metodi appropriati e convertire i risultati in informazioni utilizzabili dagli esseri umani o da altri dispositivi informatici.
Per le applicazioni su larga scala, è anche importante migliorare la velocità dei calcoli complessi, ridurre gli errori, ridurre il costo dei materiali del DNA e stabilire processi di preparazione ripetibili. Anche se le molecole possono eseguire operazioni senza bisogno di energia costante, il processo di riscaldamento, preparazione e lettura dell’attrezzatura sperimentale può comunque consumare energia. Pertanto, il significato più accurato di questa ricerca è quello di dimostrare un meccanismo di calcolo molecolare che non richiede elettricità continua per guidare il processo di calcolo, piuttosto che dimostrare che l’intero processo sperimentale non richiede alcuna energia.
Il progetto DISCO a cui ha partecipato il gruppo di ricerca, il DNA Basic Storage and Computing Infrastructure Project, spera di sviluppare ulteriormente metodi di utilizzo del DNA per l'archiviazione e l'elaborazione delle informazioni. Il progetto ha ricevuto circa 4 milioni di euro in finanziamenti dal Consiglio europeo per l'innovazione ed è stato guidato da Woods.
I ricercatori hanno affermato che il lavoro attuale è una ricerca di base esplorativa e che vi è ancora grande incertezza nella direzione futura dell'applicazione. I computer DNA non sostituiranno i processori tradizionali nei PC, negli smartphone o nei data center di intelligenza artificiale nel breve termine, ma potrebbero fornire un modo diverso per implementare determinate attività informatiche specializzate.
L'aspetto veramente importante di questa ricerca è che dimostra che l'informatica non deve basarsi esclusivamente su transistor e circuiti elettronici alimentati continuamente. Progettando attentamente la struttura molecolare, i ricercatori sono stati in grado di consentire al DNA di completare le operazioni matematiche durante il suo processo di autoassemblaggio e di conservare una struttura che rappresentasse i risultati dopo il completamento dei calcoli.
Poiché le esigenze informatiche e il consumo energetico continuano a crescere, la ricerca di metodi informatici diversi dai tradizionali chip di silicio è diventata un'importante direzione di ricerca nella comunità scientifica. I computer a DNA sono ancora lontani dalle applicazioni pratiche, ma forniscono una direzione che vale la pena continuare a esplorare per l’informatica a basso consumo energetico, l’elaborazione delle informazioni molecolari e le nuove tecnologie di archiviazione dei dati.
Commenti