
Riassunto:
XAI, la società di intelligenza artificiale di Elon Musk, sta espandendo ulteriormente la portata dei suoi data center e prevede di implementare più di 1,2 milioni di GPU AI Nvidia nei prossimi anni. Mentre il data center Colossus continua ad espandersi, xAI spera di addestrare ed eseguire il modello Grok di prossima generazione attraverso un’infrastruttura informatica su larga scala e di lanciare una competizione più intensa per le infrastrutture AI con concorrenti come OpenAI.
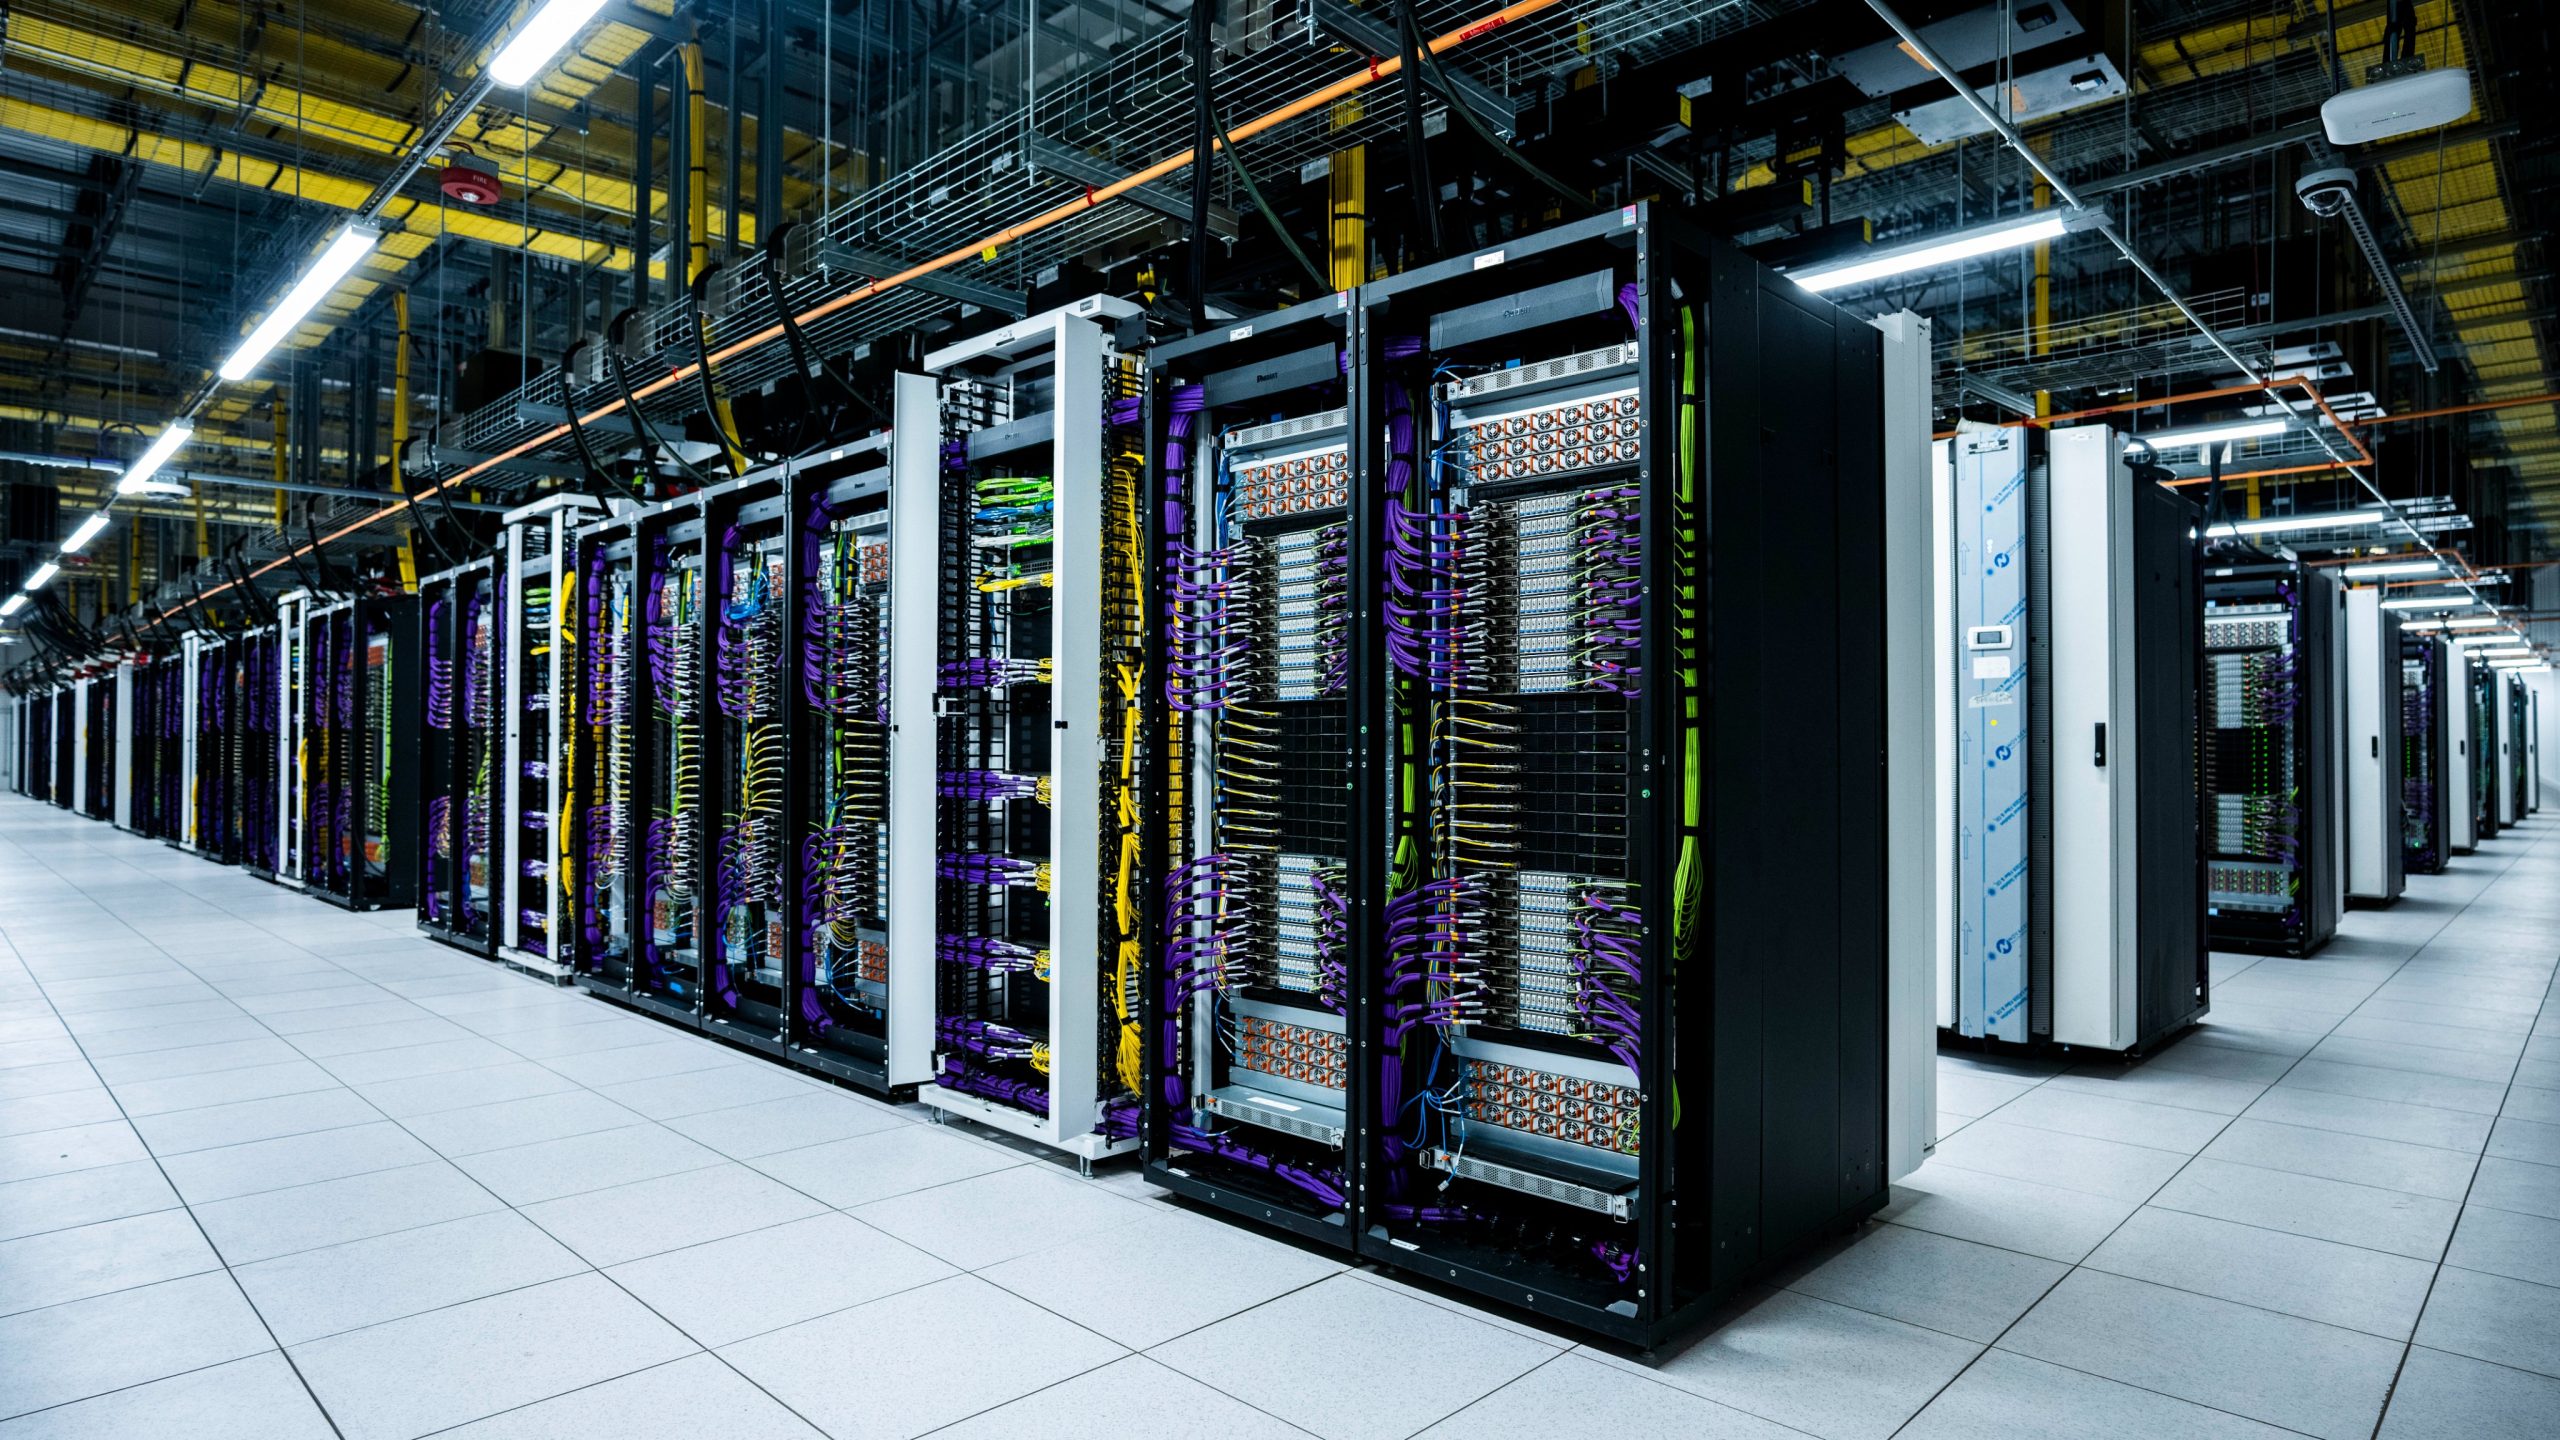
L'attuale più grande progetto di infrastruttura AI di xAI è il data center Colossus situato a Memphis, Tennessee, USA. La costruzione del progetto inizierà nel 2024 e la prima fase, Colossus 1, è già operativa. Musk ha precedentemente definito Colossus la "super fabbrica della potenza di calcolo" di xAI, il cui obiettivo principale è distribuire centralmente un gran numero di GPU il più rapidamente possibile.
Colossus inizialmente utilizzava GPU NVIDIA H100. La portata precedentemente annunciata della prima fase è di circa 200.000 H100. Con la successiva espansione, il data center ha iniziato ad aggiungere GPU della serie Blackwell più avanzate. Le ultime informazioni mostrano che oltre all'originale H100, Colossus 1 utilizza anche circa 30.000 Nvidia GB200, quindi l'attuale numero di GPU in Colossus 1 ha raggiunto circa 230.000.
La seconda fase di xAI, Colossus 2, è ancora più grande. Anche il progetto si trova a Memphis e prevede di implementare più di 500.000 GPU NVIDIA. Secondo i piani attuali, Colossus 2 diventerà uno dei più grandi progetti di data center IA del mondo e la sua potenza di calcolo supererà di gran lunga quella dei supercomputer tradizionali.
Se vengono inclusi tutti i progetti di costruzione di Colossus 1, Colossus 2 e successivi, il numero di GPU NVIDIA xAI che prevede di utilizzare in futuro raggiungerà circa 1,2 milioni o più. Questo numero non significa che tutte queste GPU siano state installate, ma corrisponde piuttosto alla portata complessiva dei futuri piani di espansione del data center di xAI.
La radicale espansione del numero di GPU di xAI è direttamente correlata alla rapida crescita della domanda di potenza di calcolo per l'addestramento dei modelli IA. La scala dei parametri, i dati di addestramento e il processo di apprendimento per rinforzo dei modelli linguistici su larga scala richiedono sempre più risorse di calcolo e la potenza di calcolo richiesta per l'addestramento e l'inferenza dei modelli si sta evolvendo dalla scala dei data center tradizionali alla scala dei cluster di supercalcolo.
In questo caso, disporre di un numero elevato di GPU è diventato una base importante per le aziende di intelligenza artificiale per espandere le capacità dei propri modelli. Musk ha ripetutamente sottolineato che xAI deve espandere le proprie capacità di calcolo il più rapidamente possibile e ridurre la propria dipendenza da piattaforme di cloud computing di terze parti costruendo i propri cluster di supercalcolo.
Anche la velocità di costruzione di Colossus è una caratteristica importante della strategia infrastrutturale di xAI. Il data center di prima fase è stato ristrutturato sulla base di una struttura industriale abbandonata e xAI lo ha ampliato in una struttura di formazione sull'intelligenza artificiale su larga scala con centinaia di migliaia di GPU in un breve periodo di tempo attraverso un gran numero di apparecchiature prefabbricate, costruzione parallela e rapida implementazione delle GPU.
xAI continua inoltre ad espandere le capacità di costruzione di data center e di alimentazione di Colossus. A causa del consumo energetico estremamente elevato delle moderne GPU AI, l’espansione dei data center non significa semplicemente aumentare il numero di server. Devono inoltre costruire contemporaneamente una grande quantità di infrastrutture di alimentazione, raffreddamento, rete e storage.
xAI ha già dovuto affrontare problemi di alimentazione in precedenza. Il consumo energetico di Colossus 1 raggiunge centinaia di megawatt e, con l'ulteriore aumento del numero di GPU, anche il suo fabbisogno energetico aumenterà in modo significativo. Per supportare la successiva espansione, xAI ha cercato nuove fonti di energia e ha costruito le corrispondenti infrastrutture di generazione e distribuzione di energia.
Con l'ingresso graduale sul mercato di NVIDIA Blackwell e delle successive GPU della serie Rubin, il data center di xAI continuerà a essere sottoposto ad aggiornamenti hardware. Rispetto all'H100, la nuova generazione di GPU può fornire prestazioni di calcolo AI più elevate, ma aumenta anche il consumo energetico di una singola GPU. Pertanto, i futuri grandi data center AI dovranno risolvere contemporaneamente i problemi della densità di calcolo e dell’approvvigionamento energetico.
Musk ha inoltre affermato in precedenza che xAI prevede di aumentare in modo significativo la capacità energetica complessiva del data center intorno al 2027 e di espandere la potenza di calcolo fino a raggiungere dimensioni diverse rispetto a quelle precedenti. I piani rilevanti mostrano che la scala di potenza totale dei futuri data center di xAI potrebbe raggiungere diversi gigawatt o addirittura 10 gigawatt.
Un'infrastruttura così grande significa che xAI sta cercando di costruire una "super fabbrica" di intelligenza artificiale simile a quella delle grandi aziende di cloud computing. Server GPU, apparecchiature di rete, sistemi di storage, centrali elettriche e sistemi di raffreddamento a liquido saranno combinati in un enorme cluster informatico per l'addestramento e l'esecuzione di modelli di intelligenza artificiale come Grok.
Questa strategia rende inoltre sempre più diretta la concorrenza tra xAI e OpenAI. Negli ultimi anni OpenAI ha anche costruito data center AI su larga scala e ha stabilito una partnership infrastrutturale su larga scala con NVIDIA. NVIDIA ha annunciato l'intenzione di fornire a OpenAI almeno 10 GW di sistemi IA, corrispondenti a milioni di GPU, e prevede di investire gradualmente fino a 100 miliardi di dollari in OpenAI con l'implementazione dell'infrastruttura.
Il piano di OpenAI significa che il settore dell'intelligenza artificiale sta entrando in una nuova fase con "data center a livello di gigawatt" come unità competitiva di base. In passato, la concorrenza tra le aziende di intelligenza artificiale si concentrava maggiormente sugli algoritmi dei modelli, sul talento e sui dati, ma ora l’infrastruttura informatica stessa è diventata un fattore importante nel determinare la velocità e la portata dell’addestramento dei modelli.
xAI sceglie di costruire il proprio data center Colossus su larga scala, che consente all'azienda di controllare più direttamente l'implementazione della GPU, la struttura di rete, il software del data center e l'infrastruttura di formazione. Per le aziende che necessitano di addestrare continuamente modelli su larga scala, questo approccio può ridurre la dipendenza da piattaforme cloud esterne consentendo al tempo stesso ai team di ingegneri di ottimizzare hardware e software per i propri modelli.
Tuttavia, la portata di 1,2 milioni di GPU è ancora un obiettivo futuro, non il numero che xAI ha attualmente implementato. La velocità di costruzione del data center, la fornitura di GPU, l'alimentatore, gli impianti di raffreddamento, le apparecchiature di rete e gli investimenti di capitale influenzeranno tutti la velocità di implementazione finale. Pertanto, il numero effettivo di GPU in esecuzione e il tempo di completamento potrebbero comunque variare.
Indipendentemente dal fatto che le cifre finali possano raggiungere la scala attualmente pianificata, il Colosso in costruzione da xAI ha dimostrato che la competizione per le infrastrutture AI sta entrando in una nuova fase. Poiché OpenAI, Google, Meta, Microsoft e altre società di intelligenza artificiale costruiscono data center a livello di gigawatt, la competizione tra i modelli di intelligenza artificiale in futuro si evolverà in gran parte in una competizione tra scala di data center, alimentazione e capacità avanzate di acquisizione di GPU.
Commenti