
Riassunto:
Microsoft ha annunciato ufficialmente il chip di intelligenza artificiale di terza generazione Maia 300 sviluppato internamente e prevede di implementarlo in un ambiente di produzione a partire dal 2027 per supportare le attività di ragionamento dell'intelligenza artificiale dietro prodotti e servizi come Copilot. Microsoft ha affermato che rispetto all'attuale sistema GPU leader, Maia 300 dovrebbe essere in grado di elaborare il 40% in più di token per megawatt di potenza; in una configurazione rack completa composta da 96 acceleratori, la velocità di trasmissione dei token a livello di rack può essere fino a 7 volte quella della generazione precedente Maia 200.
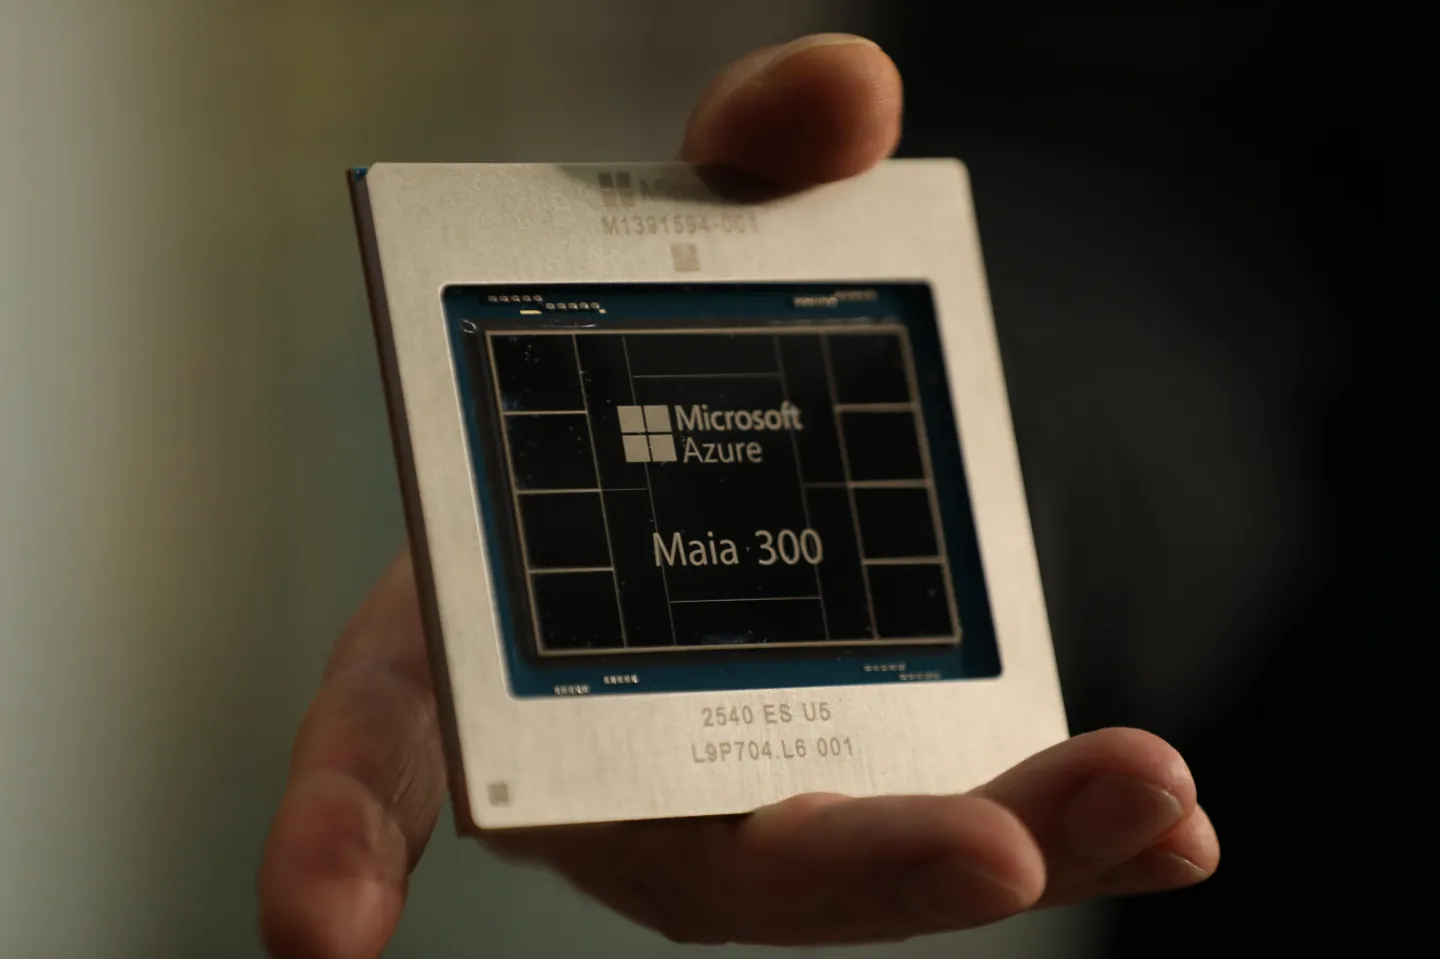
Questa versione segna l'ulteriore investimento di Microsoft nei chip AI sviluppati internamente. Poiché l’uso dei servizi di intelligenza artificiale continua a crescere, Microsoft spera di ridurre i costi operativi, migliorare l’efficienza energetica e ridurre la dipendenza dalle GPU di fornitori come Nvidia e AMD attraverso acceleratori auto-progettati.
Scott Guthrie, vicepresidente esecutivo del business del cloud computing di Microsoft, ha affermato che la società prevede di espandere la scala di implementazione dei chip della serie Azure Maia al livello multi-gigawatt a partire dal 2027 e di renderlo il principale sistema di inferenza AI per prodotti e servizi Microsoft.
Questo obiettivo significa che Microsoft spera di aggiornare gradualmente i chip sviluppati autonomamente da parte dell'infrastruttura esistente a una piattaforma informatica di base che supporti i propri servizi di intelligenza artificiale. Tuttavia, ciò non significa che Microsoft smetterà completamente di acquistare GPU da Nvidia o AMD. È probabile che Microsoft continui a utilizzare più piattaforme hardware per attività di training e inferenza che richiedono capacità di elaborazione diverse.
Maia 300 è il prodotto di terza generazione della serie Maia di Microsoft ed è anche il chip di prossima generazione lanciato dopo l'annuncio di Maia 200 nel gennaio di quest'anno. Maia 200 è attualmente utilizzato per carichi di lavoro AI in diversi ambienti di produzione Microsoft, tra cui Microsoft Copilot, GitHub Copilot, Microsoft Foundry e i modelli di intelligenza artificiale sviluppati internamente da Microsoft.
Guthrie ha affermato che, a giudicare dagli indicatori operativi dei servizi di intelligenza artificiale effettivi, Maia 200 è già una delle infrastrutture di intelligenza artificiale con le migliori prestazioni all'interno di Microsoft. La nuova generazione Maia 300 è progettata specificamente per carichi di lavoro IA in continua evoluzione, in particolare quelli che devono gestire ragionamenti a lungo contesto, conversazioni in tempo reale altamente sensibili alla latenza e attività degli agenti IA che eseguono continuamente più passaggi.
Queste applicazioni impongono requisiti hardware diversi rispetto alla tradizionale inferenza AI.
Poiché i modelli linguistici su larga scala vengono gradualmente utilizzati negli assistenti di programmazione, nell'automazione aziendale e nell'esecuzione di attività complesse, il contesto che i sistemi di intelligenza artificiale devono elaborare sta diventando sempre più lungo e una singola attività comporta sempre più chiamate a modelli e operazioni di strumenti. Per i fornitori di servizi cloud, oltre alle prestazioni del modello stesso, è necessario considerare anche la latenza di risposta, il numero di richieste simultanee, la capacità di memoria e il costo effettivo di ciascuna inferenza.
Pertanto, l'obiettivo progettuale di Maia 300 non è solo quello di aumentare la potenza di calcolo di picco, ma anche di migliorare l'efficienza complessiva in un ambiente aziendale reale che funziona continuamente. Microsoft spera di ottimizzare in modo specifico l'architettura del chip per renderlo più adatto a gestire il carico di calcolo generato dai modelli di inferenza e dagli agenti IA di nuova generazione.
In termini di produzione di chip, Maia 300 adotta il processo avanzato N2P di TSMC e introduce un'architettura di progettazione basata su core. Rispetto ai progetti tradizionali che integrano funzioni diverse su un unico chip di grandi dimensioni, l'architettura principale del chip può dividere funzioni come elaborazione, controller di memoria, input e output in diversi moduli, quindi progettarli in base alle rispettive caratteristiche.
Il team Hardware and Infrastructure di Microsoft Azure ha affermato che questo design consente di utilizzare più area di silicio nel chip per le prestazioni di elaborazione, consentendo al tempo stesso a diversi moduli funzionali di adottare tecnologie più adatte alle proprie esigenze.
Questa idea ha un significato pratico. Per gli acceleratori IA, l’unità di calcolo è importante, ma anche il modo in cui i dati vengono trasmessi tra l’unità di calcolo, la memoria e i dispositivi esterni influirà sulle prestazioni complessive. Se l'unità di calcolo deve attendere l'arrivo dei dati, anche se dispone di un'elevata potenza di calcolo teorica, non sarà in grado di sfruttare appieno le sue prestazioni.
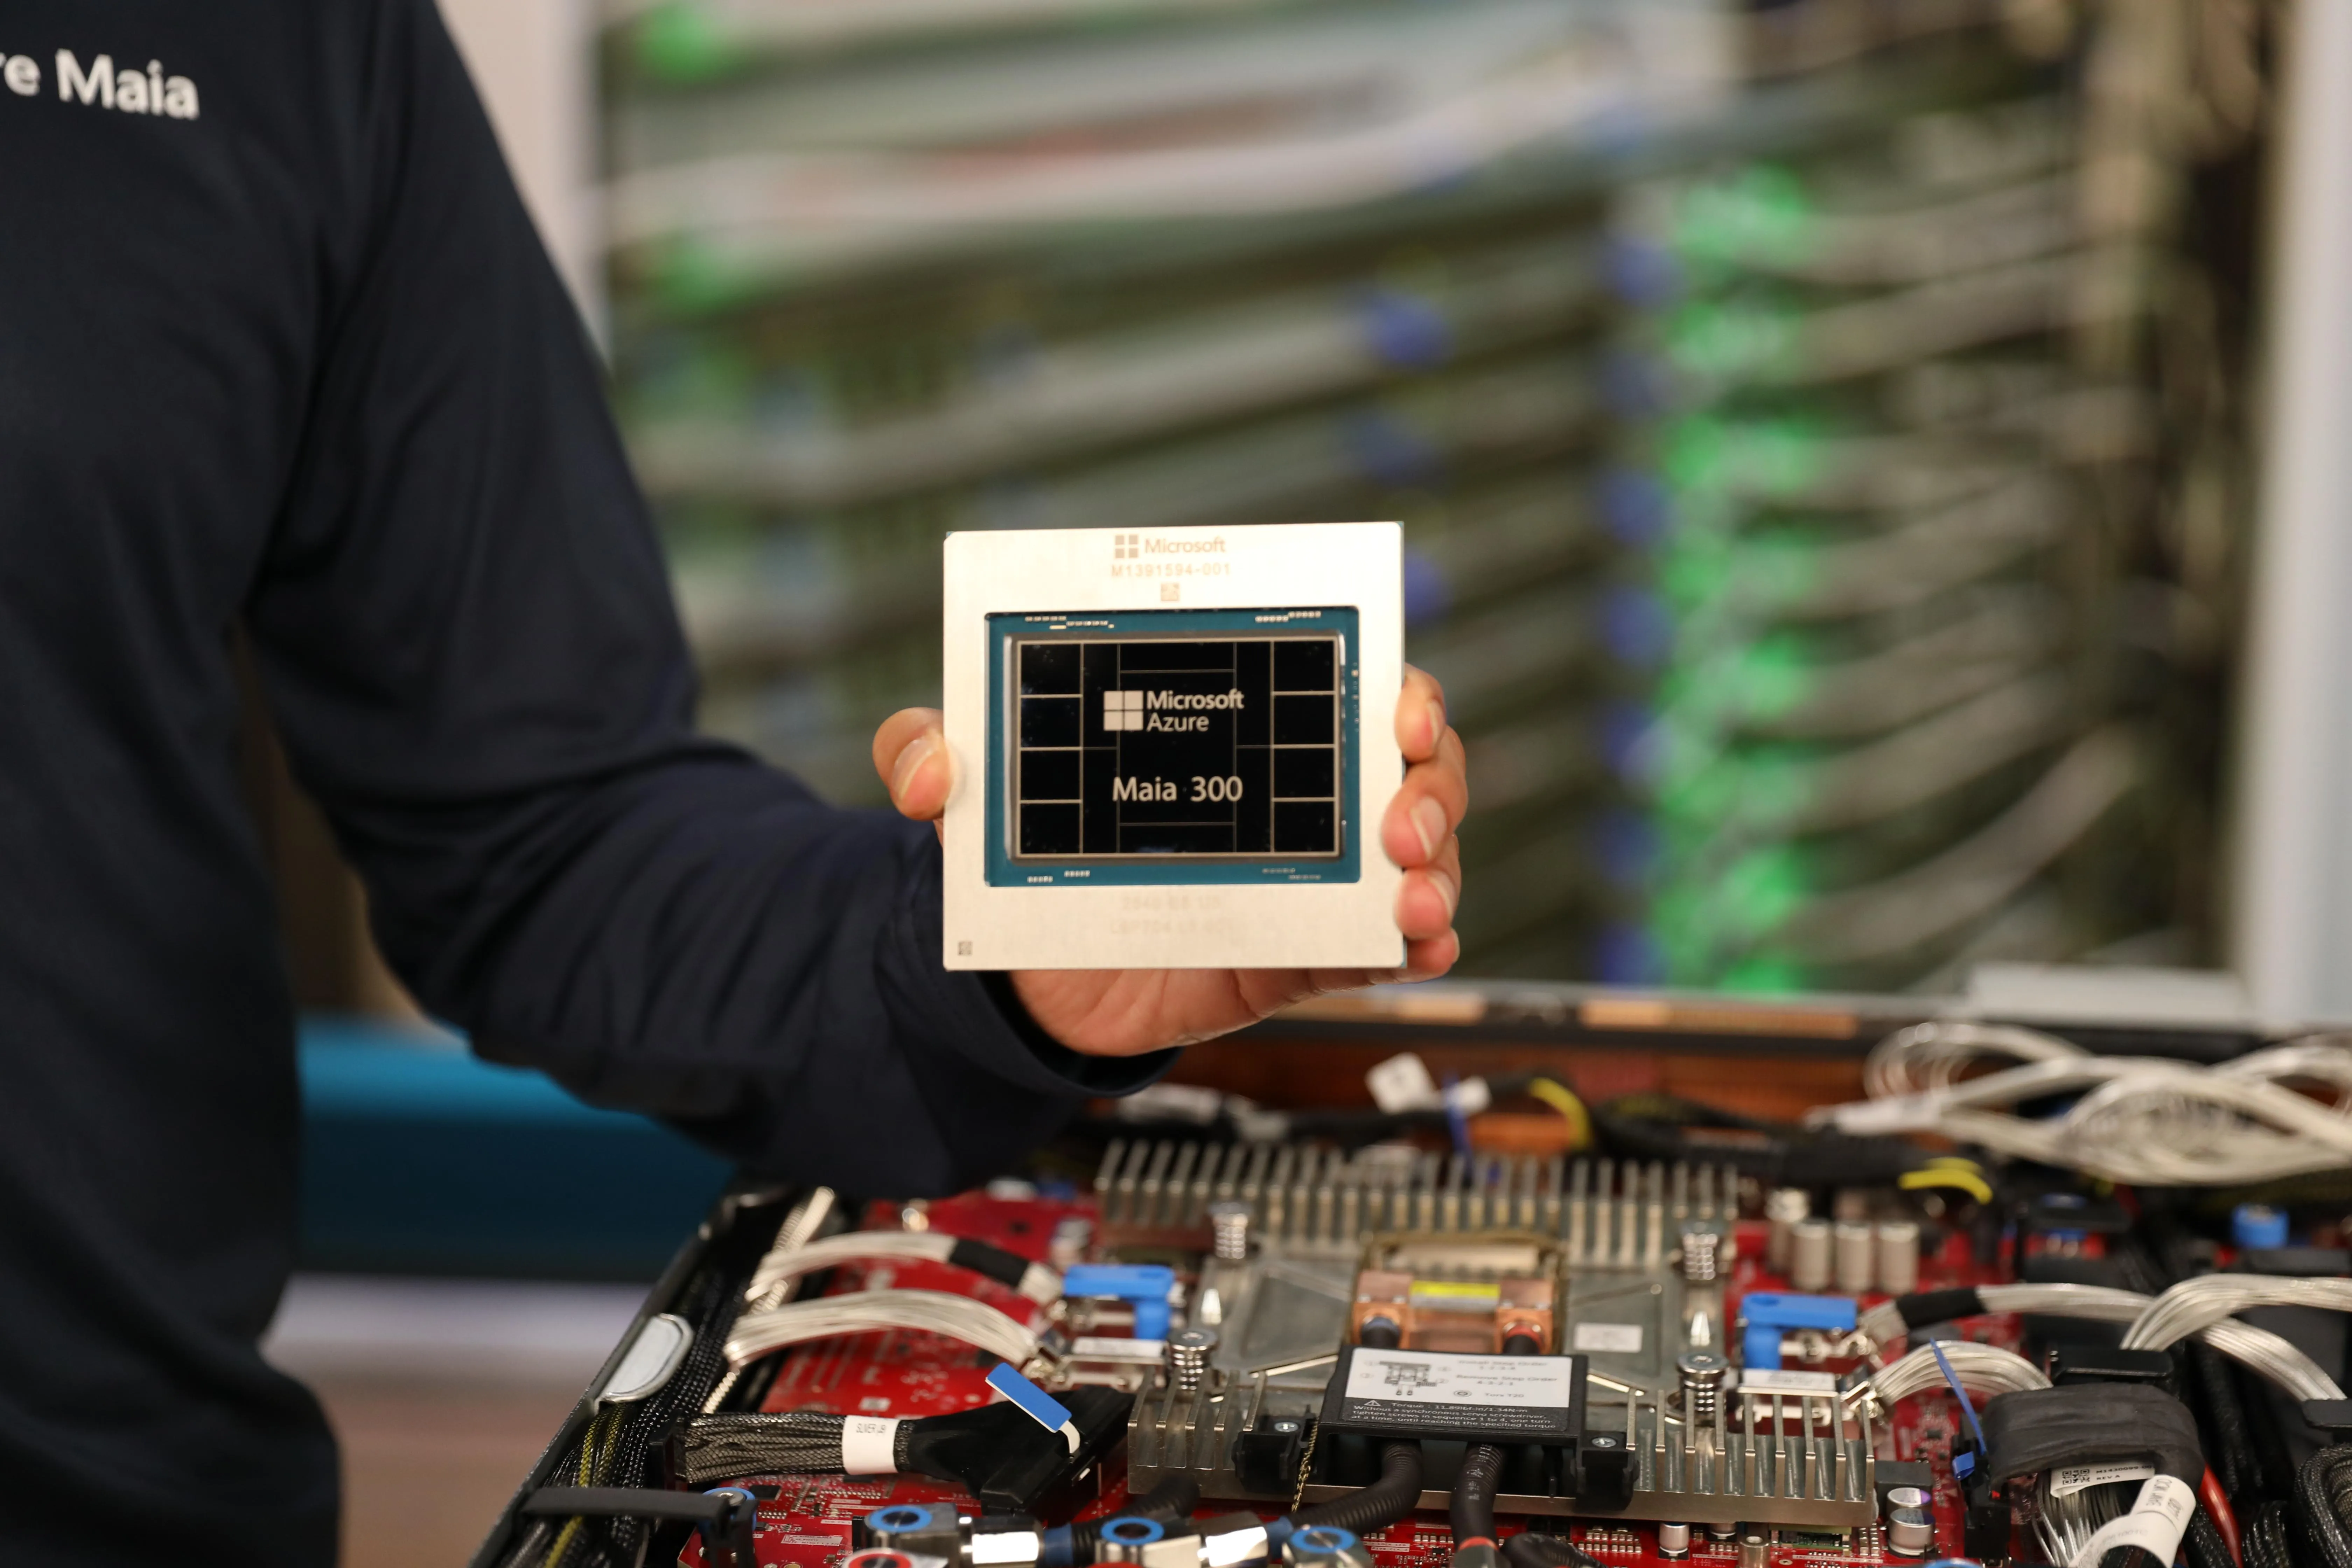
Ottimizzando separatamente elaborazione, controllo della memoria e funzioni di input e output, Microsoft spera di migliorare l'efficienza complessiva dell'utilizzo delle risorse del chip e raggiungere un migliore equilibrio tra prestazioni, consumo energetico e costi di produzione.
L'uso di processi avanzati contribuirà anche a migliorare la densità dei transistor e l'efficienza energetica, ma le prestazioni finali del chip dipendono ancora da molteplici fattori come la microarchitettura, il sottosistema di memoria, la progettazione dell'interconnessione e l'ottimizzazione del software. I dati sulle prestazioni rilasciati da Maia 300 attualmente provengono principalmente dall'introduzione di Microsoft e l'effetto reale deve ancora essere valutato in base a diversi modelli, carichi di lavoro e condizioni di implementazione.
Nel campo del ragionamento basato sull'intelligenza artificiale, il throughput dei token è uno degli indicatori importanti per misurare l'efficienza del sistema. Il token è l'unità di dati di base utilizzata dai modelli linguistici di grandi dimensioni durante l'elaborazione del testo, solitamente corrispondente a una parola, un frammento di parola o un'altra unità di testo. Il numero di token che il sistema può elaborare per unità di tempo influisce direttamente sul numero di utenti che serve contemporaneamente e sulle risorse di elaborazione necessarie per completare l'attività.
Microsoft prevede che Maia 300 gestirà il 40% di token per megawatt in più rispetto ai principali sistemi GPU. Ciò significa che con lo stesso budget energetico, Microsoft dovrebbe elaborare più richieste di intelligenza artificiale o ridurre il consumo energetico fornendo le stesse funzionalità di servizio.
Per i fornitori di servizi cloud con data center su larga scala, questo miglioramento dell'efficienza può comportare un notevole valore economico. I data center IA non solo devono acquistare costosi acceleratori, ma devono anche sostenere i costi di alimentazione, raffreddamento, apparecchiature di rete e costruzione di infrastrutture. Poiché l’utilizzo dei modelli continua a crescere, l’alimentazione e la capacità dei data center stanno diventando fattori importanti che limitano l’espansione dei servizi di intelligenza artificiale.
Tuttavia, l'efficienza dei token per megawatt non è l'unico indicatore per misurare i chip IA. La scala dei parametri, la lunghezza del contesto, le impostazioni di precisione e i metodi di inferenza dei diversi modelli influenzeranno tutti i risultati del test. Per confrontare in modo completo prodotti come Maia 300 e GPU NVIDIA, è necessario considerare anche la latenza, la compatibilità dei modelli, l'ecosistema software, i costi di implementazione e la stabilità nel business reale.
Microsoft ha anche annunciato un indicatore più interessante: in una configurazione rack completa composta da 96 acceleratori, la velocità effettiva dei token a livello di rack di Maia 300 può raggiungere fino a 7 volte quella di Maia 200.
Questa cifra mostra che Microsoft non spera solo di migliorare l'efficienza di un singolo chip, ma anche di ottimizzare la potenza di calcolo dell'intero rack. Ma descrive il throughput a livello di rack in una configurazione specifica. Ciò non significa che Maia 300 sia 7 volte più veloce di Maia 200 in tutte le attività, né si può dedurre direttamente che le prestazioni di ciascun chip siano migliorate nella stessa proporzione.
Per le piattaforme di cloud computing, le prestazioni a livello di rack sono particolarmente importanti. Le implementazioni nel mondo reale consistono in genere in un gran numero di acceleratori, con i chip che scambiano dati tramite interconnessioni ad alta velocità ed elaborano congiuntamente le richieste dei modelli. Anche se un singolo chip è potente, l’intero sistema può comunque essere limitato se la larghezza di banda di interconnessione, la capacità di memoria o l’efficienza di pianificazione sono insufficienti.
Pertanto, Microsoft sta cercando di condurre un'ottimizzazione complessiva dalla progettazione del chip, dalla configurazione del rack al software e all'ambiente operativo del modello, piuttosto che perseguire semplicemente la potenza di calcolo teorica del processore.
Il capo dell'intelligenza artificiale di Microsoft, Mustafa Suleyman, ha affermato che l'azienda deve iniziare a investire dal basso dell'intero stack tecnologico, compresa la progettazione dei chip. Ritiene che quando i servizi di intelligenza artificiale raggiungeranno una scala così vasta, Microsoft dovrà disporre di una propria piattaforma e consentire che chip e modelli sviluppati autonomamente siano co-progettati e ottimizzati.
Ha sottolineato in particolare che consentire ai modelli di intelligenza artificiale sviluppati internamente da Microsoft di funzionare sui chip Maia è un compito importante per il team AI di Microsoft.
Questa affermazione rivela un altro obiettivo dello sviluppo di chip sviluppati internamente da Microsoft: combinare hardware, modelli e servizi cloud per formare un rapporto di collaborazione più stretto.
I fornitori di servizi cloud tradizionali possono implementare modelli di intelligenza artificiale acquistando GPU generiche, ma se riescono a progettare i propri acceleratori, possono ottimizzare le caratteristiche di calcolo, i requisiti di memoria e i processi di inferenza dei propri modelli. A sua volta, il team del modello può adattare la struttura del modello e il metodo operativo in base all'architettura del chip, migliorando così l'efficienza complessiva.
Google e Amazon investono da molti anni in chip IA sviluppati internamente. Google ha una serie di acceleratori TPU e Amazon ha sviluppato chip come Trainium per supportare i propri servizi di cloud computing e intelligenza artificiale. Microsoft ha lanciato la serie Maia per rafforzare le proprie capacità infrastrutturali in questo contesto competitivo.
Per Microsoft, il valore strategico dei chip autosviluppati non è solo quello di ridurre i costi di approvvigionamento, ma anche di migliorare l'autonomia della catena di fornitura, ottimizzare l'utilizzo energetico del data center e avere un maggiore controllo sulla progettazione dell'hardware quando i modelli e i servizi di intelligenza artificiale vengono iterati rapidamente.
Al momento, Microsoft mantiene ancora una stretta collaborazione con NVIDIA e le GPU NVIDIA continuano a svolgere un ruolo importante nel campo della formazione e dell'inferenza dell'intelligenza artificiale. Lo sviluppo simultaneo della serie Maia da parte di Microsoft non significa che il rapporto tra le due parti cambierà inevitabilmente in modo sostanziale, ma riflette che i grandi fornitori di servizi cloud stanno riducendo la loro dipendenza da un'unica piattaforma hardware attraverso chip sviluppati internamente e strategie multivendor.
Microsoft spera inoltre di utilizzare chip sviluppati internamente per migliorare la competitività dei suoi modelli di intelligenza artificiale. Suleiman ha affermato che la piattaforma Maia è una parte importante del sistema tecnologico AI di Microsoft e può aiutare l'azienda a sviluppare ulteriormente i propri modelli e migliorare la propria competitività rispetto a concorrenti come Google DeepMind, OpenAI e Anthropic.
Mentre i modelli di intelligenza artificiale si evolvono gradualmente da semplici strumenti per la generazione di testo a sistemi di agenti in grado di richiamare strumenti ed eseguire operazioni complesse, aumenta anche l'importanza dell'infrastruttura hardware. Il ragionamento a contesto lungo e l’esecuzione di attività in più fasi spesso comportano processi computazionali più lunghi e un gran numero di chiamate a modelli. Solo raggiungendo un migliore equilibrio tra prestazioni, latenza e costi le aziende potranno scalare i propri servizi in modo sostenibile.
Maia 300 è progettata in risposta a questa tendenza. Microsoft spera di consentire l’esecuzione di più attività di intelligenza artificiale a costi inferiori attraverso una maggiore produttività ed efficienza energetica, fornendo al contempo supporto informatico per Copilot, GitHub Copilot e futuri servizi di agenti di intelligenza artificiale.
Tuttavia, affinché Maia 300 diventi davvero la forza principale dell'infrastruttura AI di Microsoft, deve ancora passare attraverso il processo che va dalla produzione di chip, all'integrazione di sistemi fino all'implementazione su larga scala. Microsoft prevede di iniziare a metterlo in produzione nel 2027 e di espandere gradualmente la portata della distribuzione. A quel punto, l'effettiva capacità produttiva del chip, la stabilità del sistema, l'adattamento del software e l'integrazione con i data center esistenti influenzeranno l'ambito di applicazione finale.
Nel complesso, il lancio di Maia 300 dimostra che Microsoft sta elevando i chip IA da progetti infrastrutturali ausiliari a componente fondamentale della propria strategia di intelligenza artificiale. Utilizzando i processi avanzati di TSMC, la progettazione granulare di base e l'ottimizzazione a livello di sistema per i carichi di lavoro di inferenza, Microsoft spera di migliorare le capacità del servizio AI che può fornire per unità di elettricità e ridurre la sua dipendenza dai fornitori di GPU esterni.
Se Microsoft riuscirà ad espandere l'implementazione della produzione di Maia 300 come previsto nel 2027 e a ottenere i miglioramenti attesi in termini di efficienza nel business reale, si prevede che questa serie di chip diventerà uno strumento importante per controllare i costi di elaborazione dell'IA ed espandere la scala dei servizi. Ma la sua competitività a lungo termine dipende in ultima analisi dalle prestazioni operative effettive e dalla capacità di Microsoft di stabilire un sistema di ottimizzazione collaborativa duraturo ed efficace tra hardware, modelli e software.
Commenti