
Riassunto:
Google ha annunciato oggi ufficialmente la sua ultima svolta nel campo dell'interazione vocale end-to-end nativa, lanciando una nuova generazione di modelli vocali in tempo reale di grandi dimensioni Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking personalizzati per compiti difficili.
Questi due modelli rappresentano un importante passo avanti nel sistema tecnologico audio-audio nativo di Google. Non solo spingono il ritardo e la naturalezza della conversazione in tempo reale a nuovi livelli, ma raggiungono per la prima volta profonde capacità di ragionamento multi-fase in flussi vocali a bassa latenza, cambiando completamente il paradigma applicativo dell’intelligenza artificiale vocale in scenari professionali complessi.
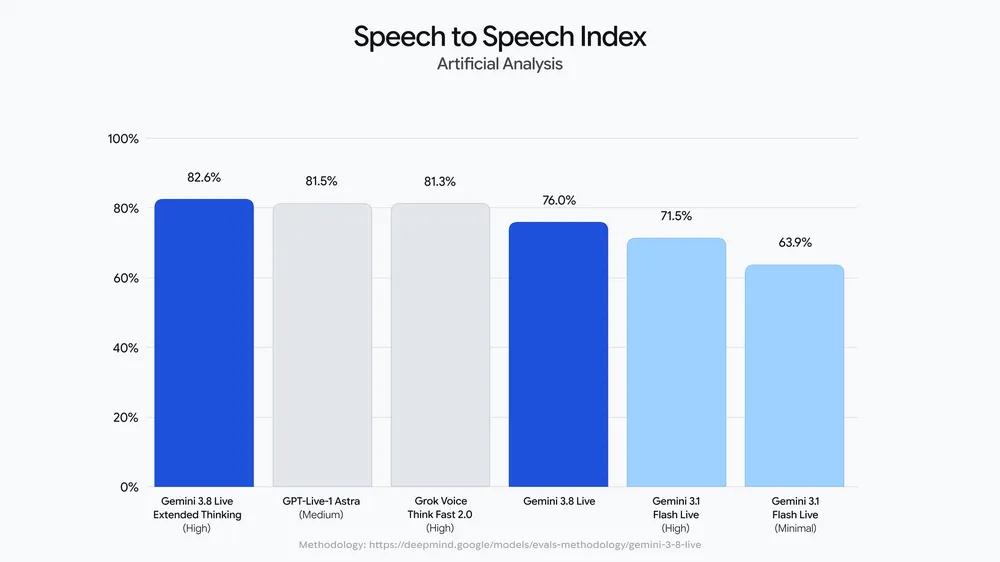
Nella precedente architettura di interazione vocale tradizionale, i sistemi di intelligenza artificiale di solito dovevano trovare un compromesso tra "dialogo superficiale a risposta rapida" e "pensiero profondo a lungo termine". Affrontare problemi difficili spesso richiedeva agli utenti di sopportare lunghi periodi di attesa silenziosa. Gemini 3.8 Live lanciato da Google si concentra sull'ottimizzazione della conversazione ultraveloce e dell'esperienza di interazione quotidiana in streaming. Può fornire agli utenti una comunicazione vocale in tempo reale estremamente fluida e di livello umano con fluttuazioni di intonazione più sensibili, interruzioni naturali e capacità di comprensione del contesto. Gemini 3.8 Live Extended Thinking, lanciato sulla sua base, è stato radicalmente aggiornato per flussi aziendali altamente complessi. Questo modello conferisce all'IA la capacità di "pensare mentre parla" (Think as it speak) in background, consentendo al sistema di eseguire contemporaneamente un complesso disassemblaggio logico multi-step, debug del codice o diagnosi tecnica in background mantenendo un dialogo coerente in tempo reale, senza la necessità di interrompere bruscamente il ritmo della conversazione quando si incontrano problemi difficili.
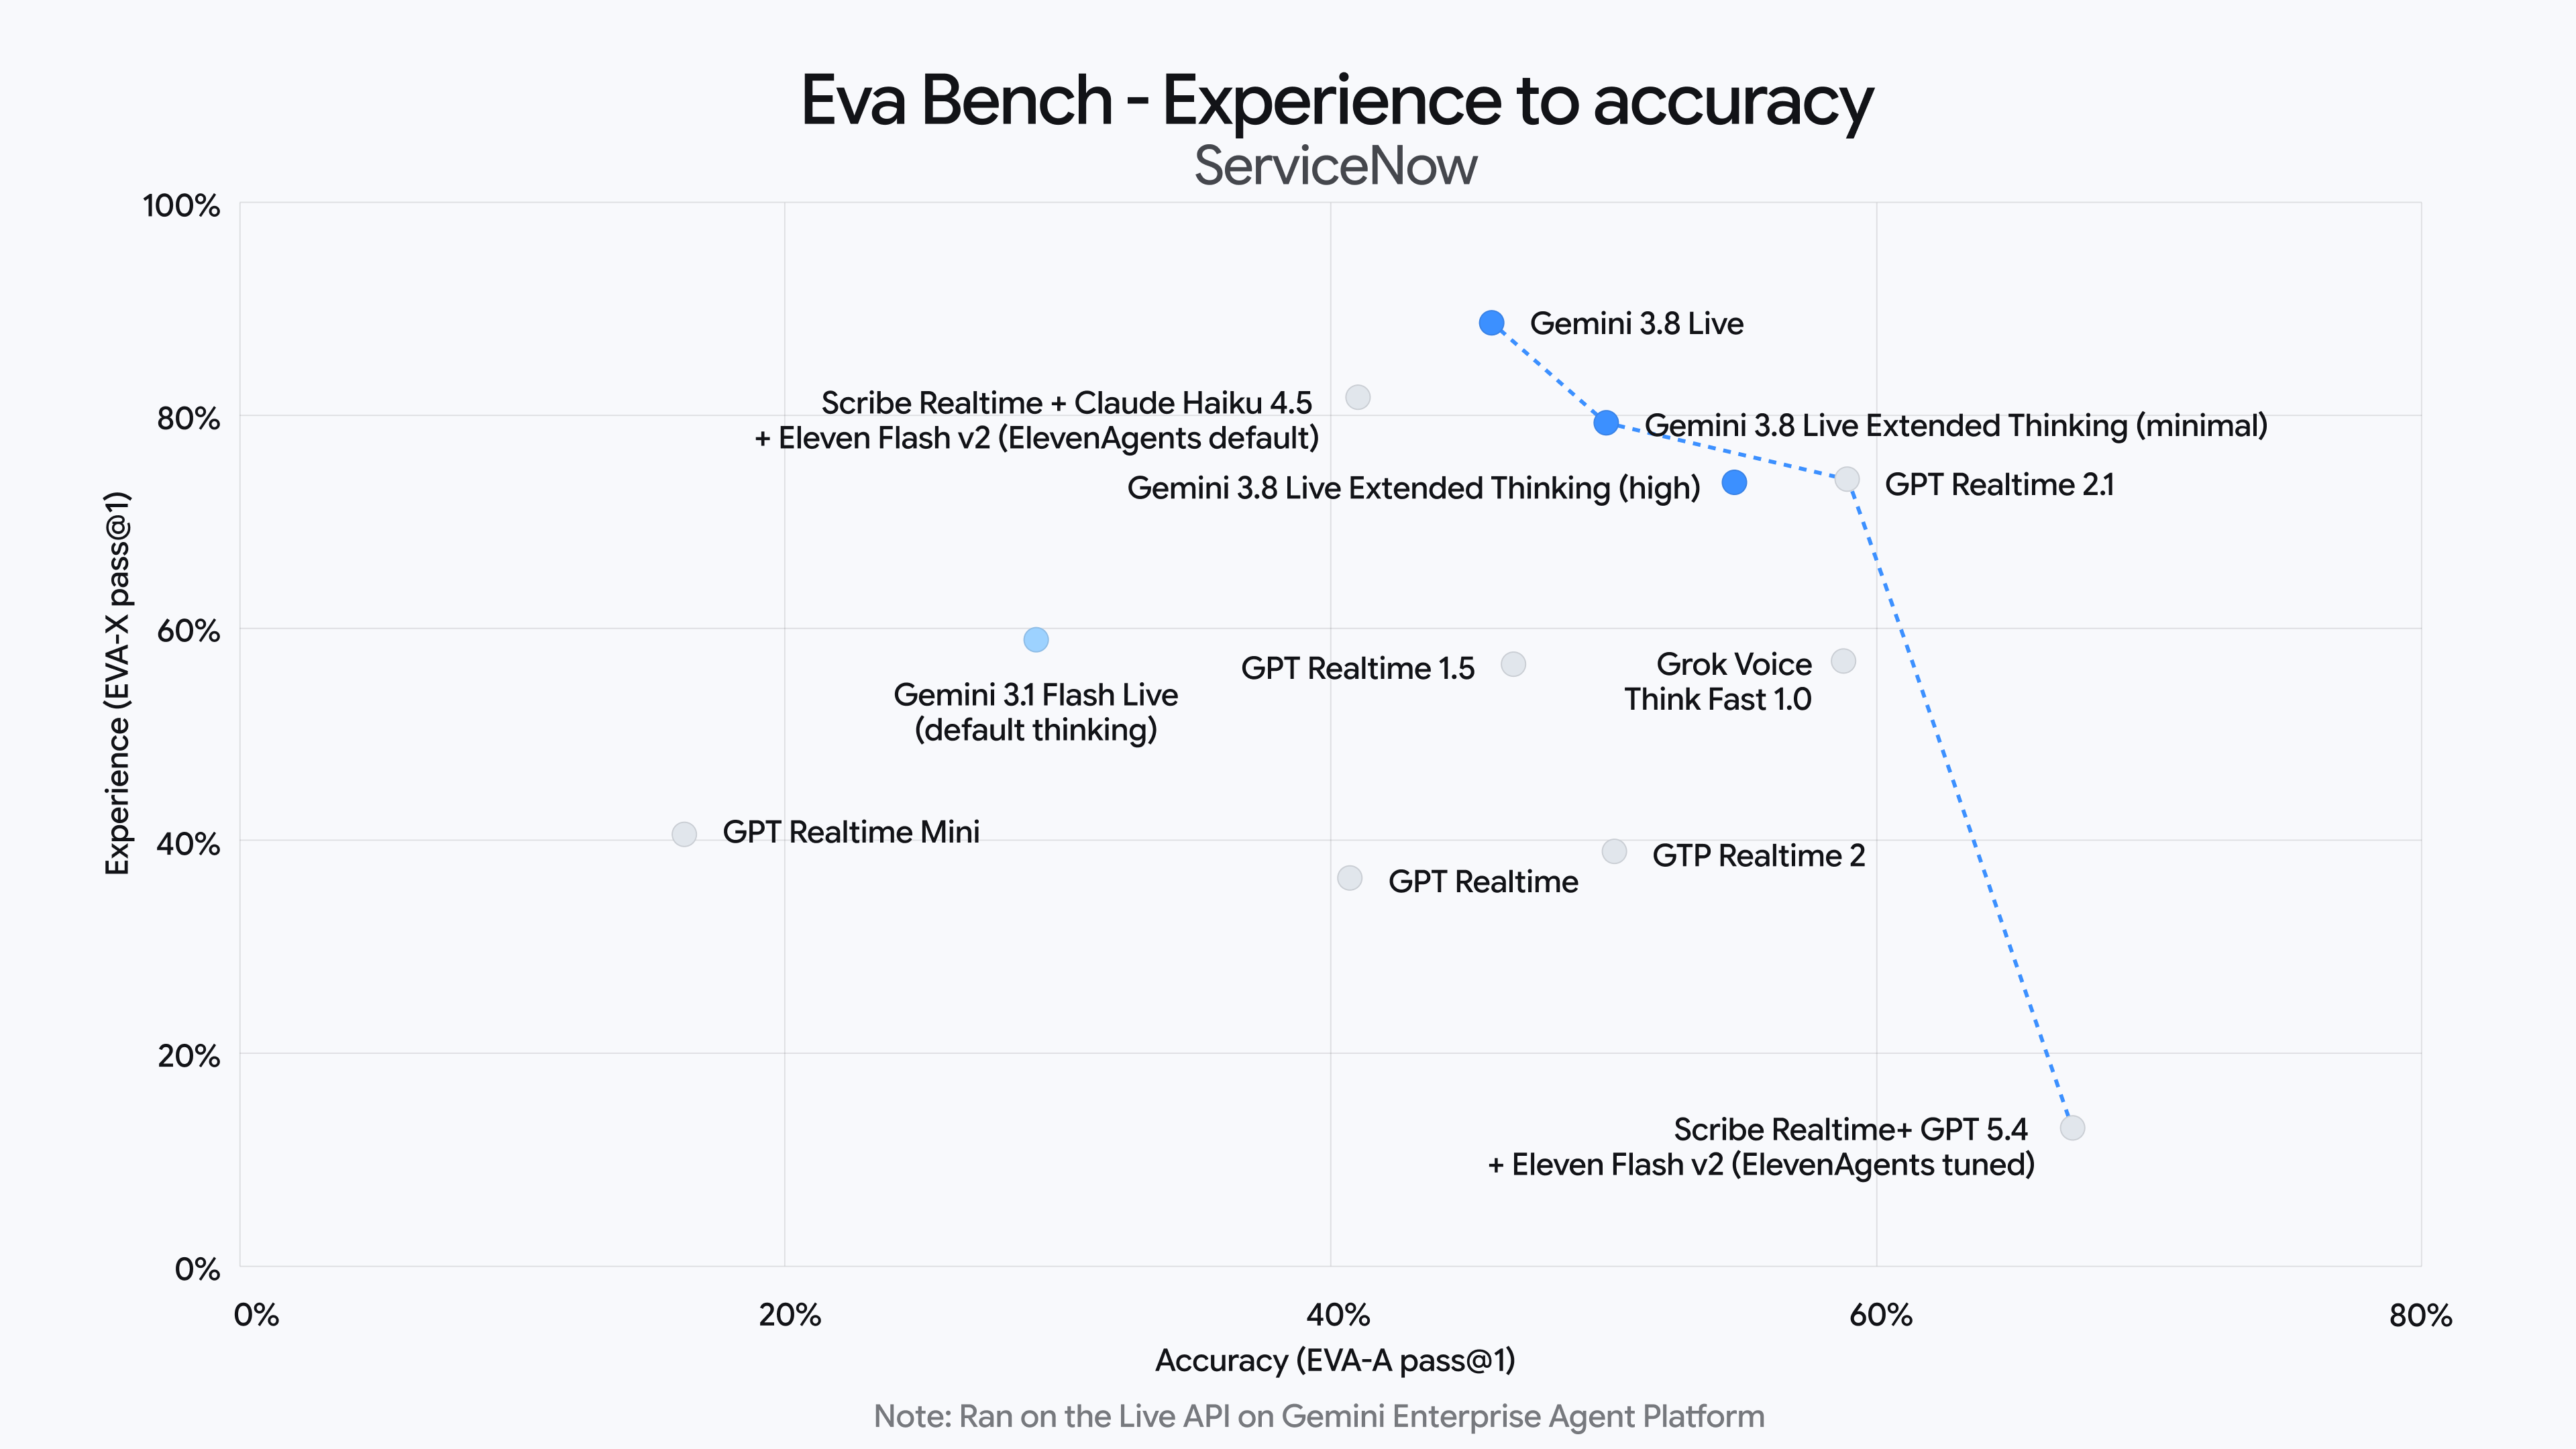
In termini di applicazione pratica, la nuova generazione di modelli della serie Live amplierà significativamente i confini del servizio degli assistenti vocali. Oltre alle conversazioni naturali quotidiane, le versioni Gemini 3.8 Live e di ragionamento esteso hanno dimostrato prestazioni significativamente migliori rispetto alle versioni precedenti in scenari con elevate esigenze intellettuali come la risoluzione dei problemi dei passaggi in tempo reale, la derivazione matematica complessa, il tutoraggio simultaneo in lingua straniera in tempo reale e l'esecuzione di istruzioni in streaming multi-task, classificandosi al primo posto in numerosi benchmark di settore del ragionamento multimodale e vocale.
Per gli sviluppatori e gli utenti aziendali, Google ha annunciato che d'ora in poi sarà ufficialmente aperto l'accesso alle funzionalità del modello pertinenti tramite Gemini API e Google AI Studio. Gli sviluppatori possono chiamare direttamente questa interfaccia API audio nativa a latenza estremamente bassa per creare rapidamente servizi di agenti vocali full-duplex di prossima generazione con capacità di ragionamento di alto livello in forme di prodotto come hardware intelligente, servizio clienti, assistenza alla programmazione in tempo reale e ufficio collaborativo.
Commenti