Riassunto:
Un ingegnere di Google DeepMind ha recentemente dimostrato un esperimento creativo: ha eseguito con successo il piccolo modello linguistico Gemma 3 270M di Google direttamente in una normale stampante laser da ufficio. Il numero di parametri di questo modello è di circa 270 milioni e la stampante utilizzata nell'esperimento ha solo 14,1 MB di memoria disponibile, ma raggiunge comunque una velocità di generazione di oltre 60 parole al secondo.
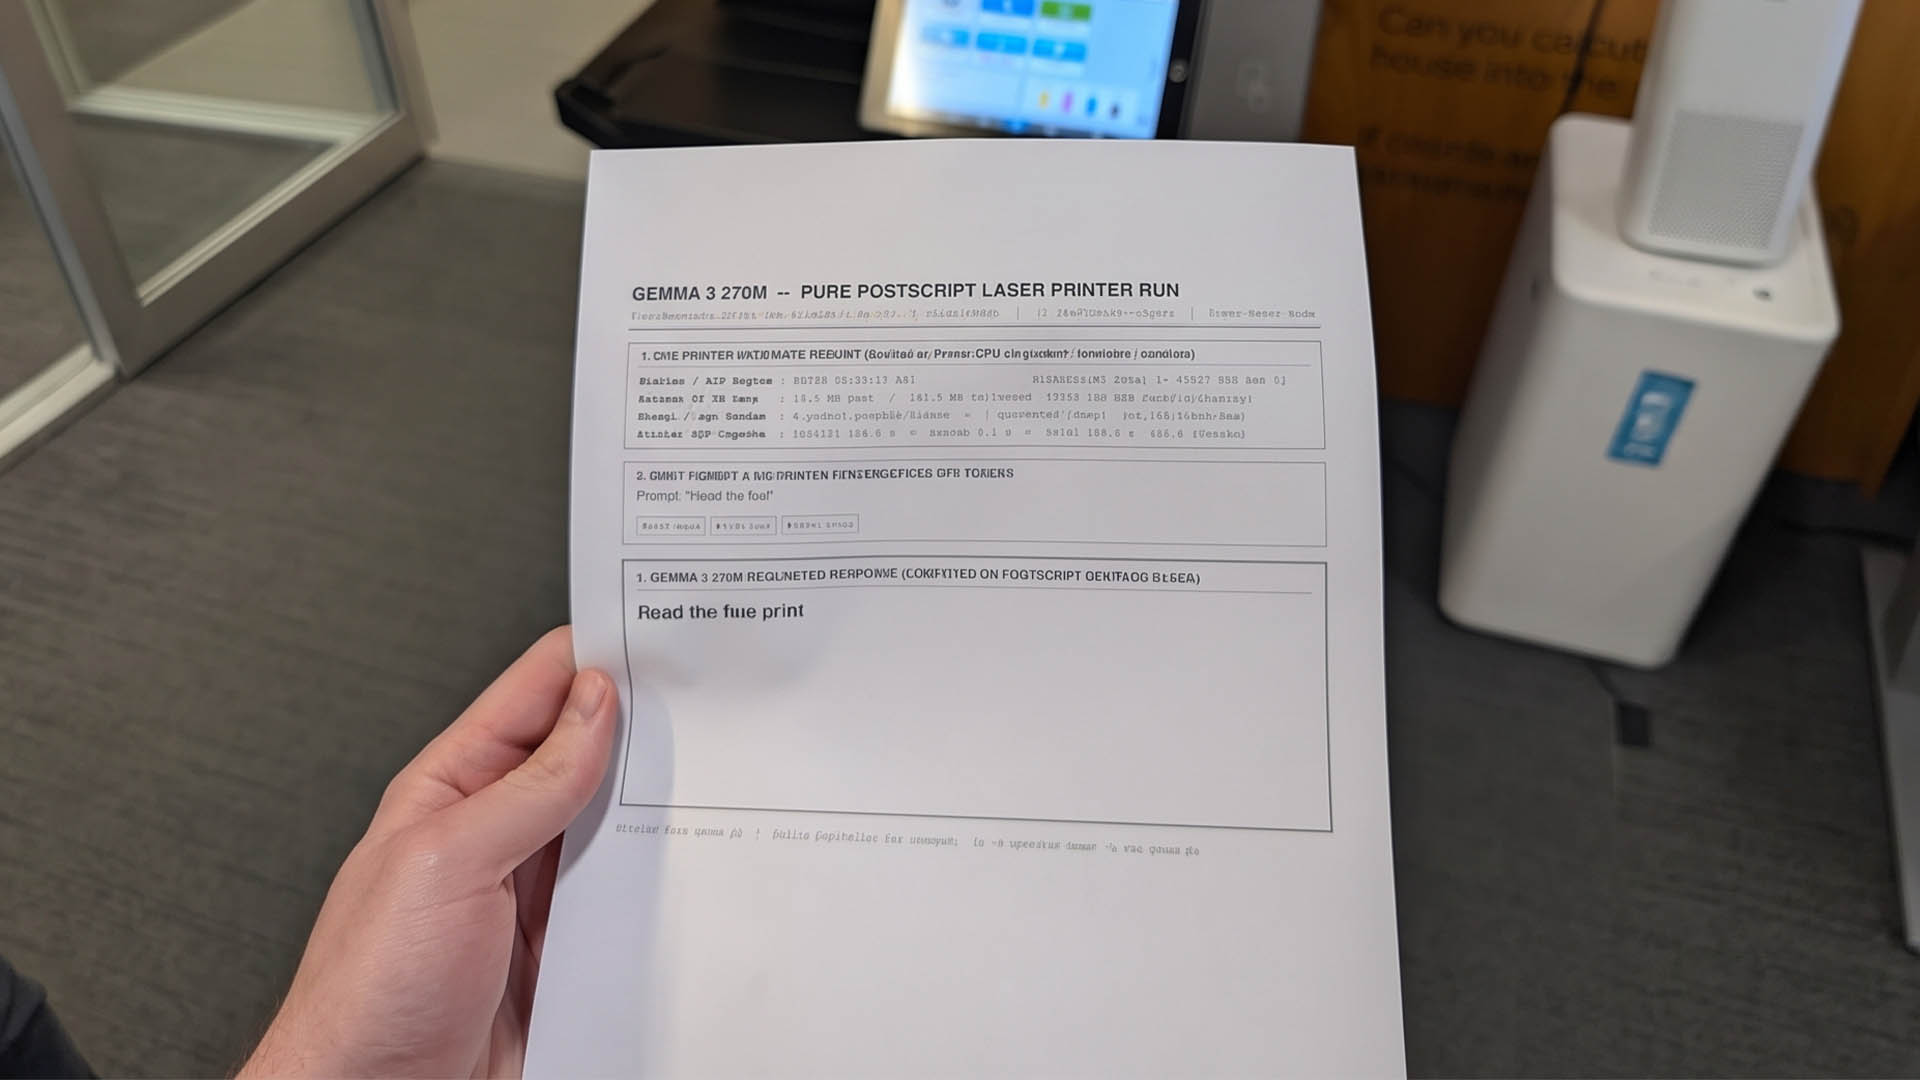
Questo risultato è stato annunciato dall'ingegnere Omar Sanseviero sulla piattaforma social X. Ha affermato che con l'aiuto del progetto Carbon ha eseguito il modello Gemma direttamente sulla stampante dell'ufficio. L'intero esperimento non ha modificato il firmware della stampante, né ha utilizzato una scheda informatica esterna o altro hardware. Si basava invece interamente sul linguaggio di descrizione della pagina PostScript integrato nelle moderne stampanti laser.
PostScript è un linguaggio di descrizione della pagina completo di Turing comunemente utilizzato per controllare il modo in cui le stampanti presentano testo, grafica e layout di pagina. Il team sperimentale ha utilizzato Carbon, un motore di inferenza Transformer leggero, e lo ha accoppiato con il modello quantizzato Gemma 3 270M per generare finalmente un file di stampa PostScript originale. Quando la stampante esegue il file, completa effettivamente il calcolo di inferenza del modello linguistico all'interno del suo interprete PostScript.
Per evitare di esaurire la memoria della stampante durante l'inferenza del modello, l'esperimento ha adottato la tecnologia di caricamento del flusso laminare dinamico. Il sistema carica costantemente diversi livelli del modello dentro e fuori dalla memoria, mantenendo il picco di utilizzo della memoria a soli 14,1 MB, mentre la stampante alloca 244,6 MB di memoria virtuale PostScript. Anche così, la Gemma 3 270M ha comunque raggiunto una velocità di generazione di 61,3 token/s sulla CPU della stampante.
Secondo le informazioni hardware acquisite nell'esperimento, questa stampante Ricoh esegue nativamente calcoli Transformer a 18 livelli all'interno dell'interprete PostScript Livello 3. Quando viene inserita la richiesta "Leggi la multa" contenente solo quattro gettoni, la fase di precompilazione dura 184 secondi, mentre il tempo di decodifica per generare un singolo gettone è di soli 0,1 secondi e l'intero processo di elaborazione ammonta a 184 secondi.
Una volta completato il calcolo, la stampante stampa finalmente la risposta di tre parole "Leggi le scritte in piccolo" direttamente sul foglio. Questo risultato non solo dimostra che il modello completa effettivamente il ragionamento all'interno della stampante, ma mostra anche che il potenziale delle apparecchiature d'ufficio quotidiane a livello di software è ben oltre le aspettative delle persone. Sebbene questa modalità operativa non sia adatta agli ambienti di produzione reali, dimostra i limiti di ciò che è possibile combinare piccoli modelli quantitativi, motori di inferenza e capacità hardware esistenti.
Commenti