
Riassunto:
Mentre l'intelligenza artificiale si evolve dai tradizionali chatbot agli agenti (agenti AI) in grado di pianificare autonomamente attività, richiamare strumenti ed eseguire flussi di lavoro complessi, anche le esigenze informatiche dei data center stanno cambiando. AMD ha rilasciato ufficialmente il progetto di riferimento per l'elaborazione AI a livello di rack Helion il 12 ottobre 2026, proponendo una nuova soluzione infrastrutturale che prende la CPU come core e può essere abbinata alle GPU in base alle esigenze.
La sua configurazione puramente CPU può integrare fino a 32.768 core di processore AMD EPYC ed è progettata per fornire un ambiente di esecuzione per agenti IA su larga scala invece di concentrare tutte le risorse di elaborazione sugli acceleratori GPU.
L'Helion rilasciato da AMD questa volta non è un chip indipendente, né un prodotto server completo che gli utenti possono acquistare direttamente, ma un progetto di riferimento rack aperto per data center. AMD prevede di contribuire con specifiche pertinenti all'Open Compute Project (OCP) per un ulteriore sviluppo e adozione da parte dei partner. Produttori come Dell, Hewlett Packard Enterprise, Lenovo, AMD e Foxconn parteciperanno allo sviluppo dei sistemi correlati e il lancio della configurazione Helion creata dai partner è previsto per novembre 2026.
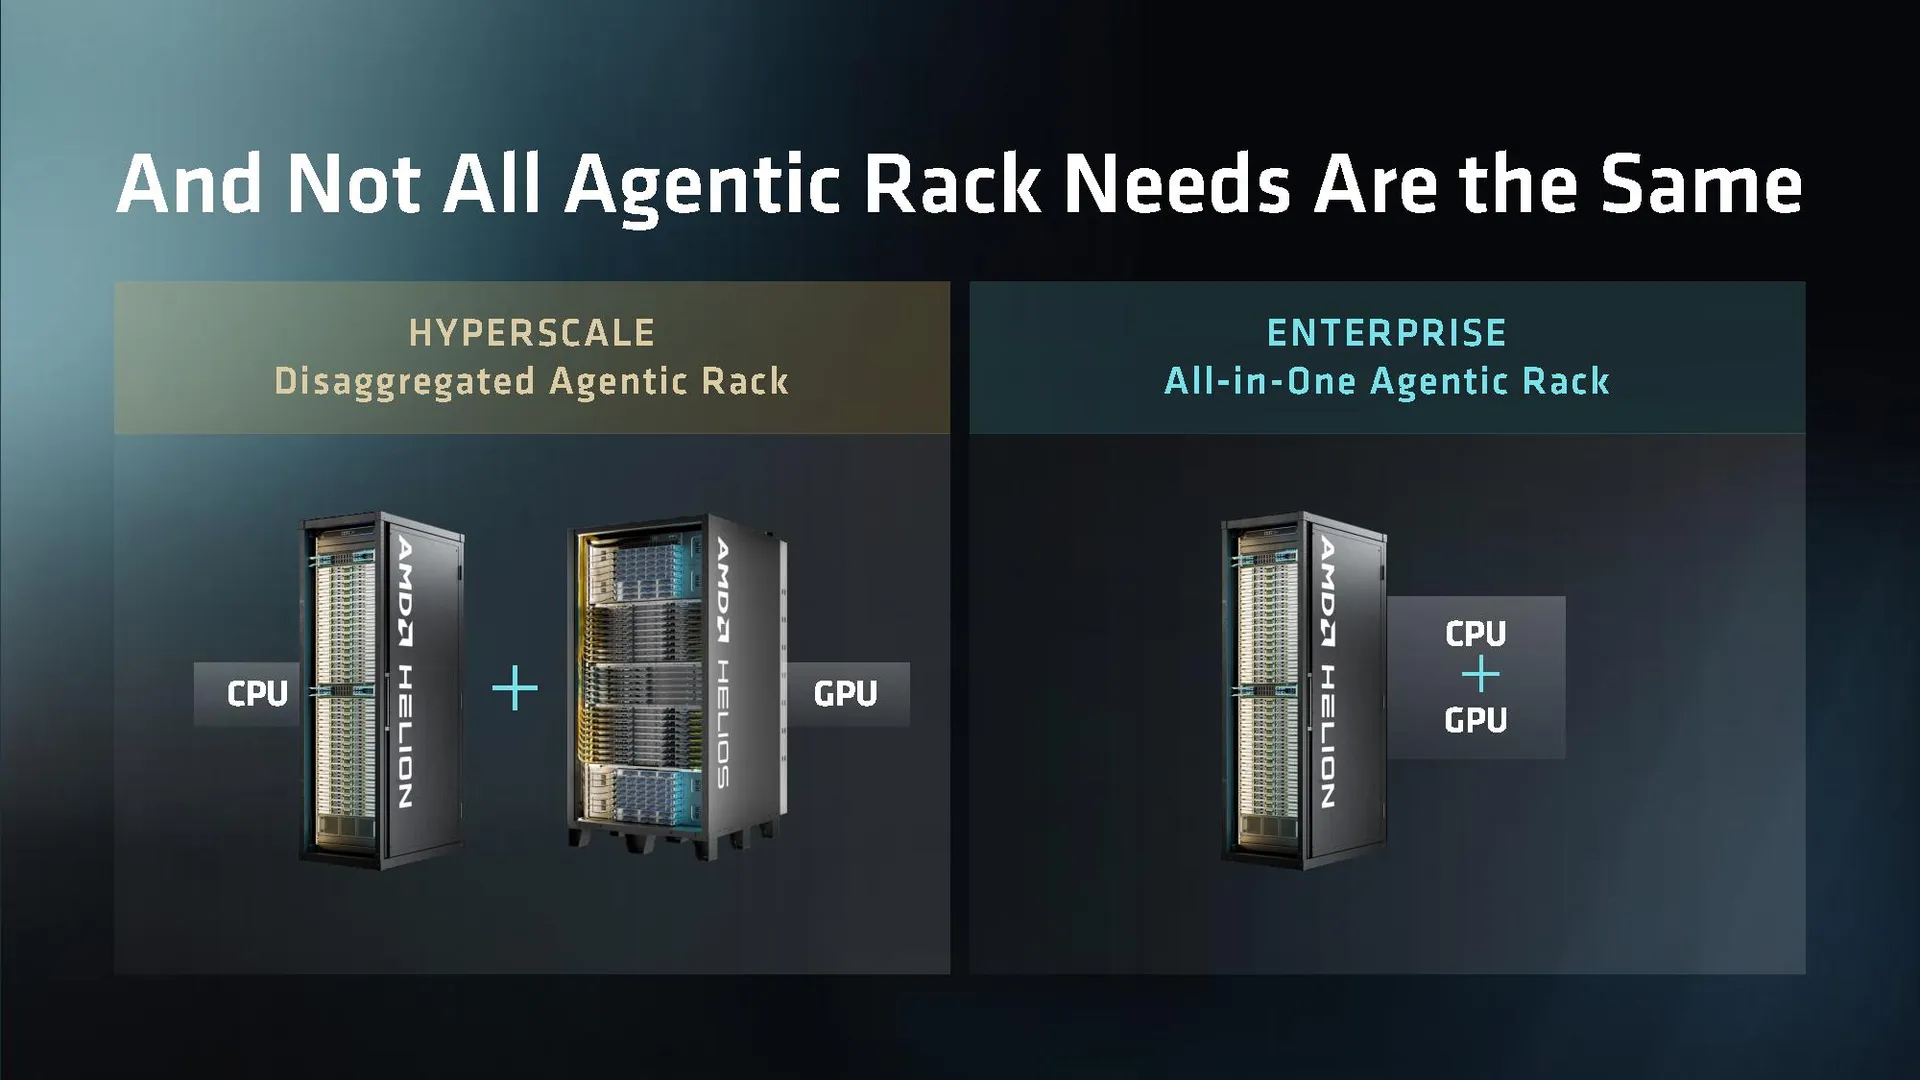
L'idea centrale di questa soluzione è configurare in modo flessibile CPU, GPU, rete e altre risorse di calcolo in base alle diverse fasi del flusso di lavoro dell'agente AI. Per data center di grandi dimensioni che necessitano di eseguire un gran numero di agenti, eseguire codice o elaborare processi aziendali complessi, i clienti possono scegliere rack CPU puri; per gli utenti che desiderano completare l'esecuzione dell'agente, l'inferenza del modello e le attività generali di elaborazione aziendale nello stesso set di apparecchiature, possono scegliere una configurazione ibrida di CPU e GPU.
Questo design riflette la nuova divisione del lavoro emergente nelle infrastrutture di intelligenza artificiale. La GPU è ancora un dispositivo di elaborazione importante per l'addestramento di modelli su larga scala e l'inferenza ad alta intensità, ma quando gli agenti di intelligenza artificiale eseguono effettivamente attività, richiedono anche una grande quantità di risorse della CPU per eseguire programmi, accedere a database, chiamare strumenti esterni, gestire lo stato delle attività e coordinare più fasi di elaborazione. Con l'aumento del numero di agenti, queste attività potrebbero diventare nuovi colli di bottiglia per le risorse nel data center.
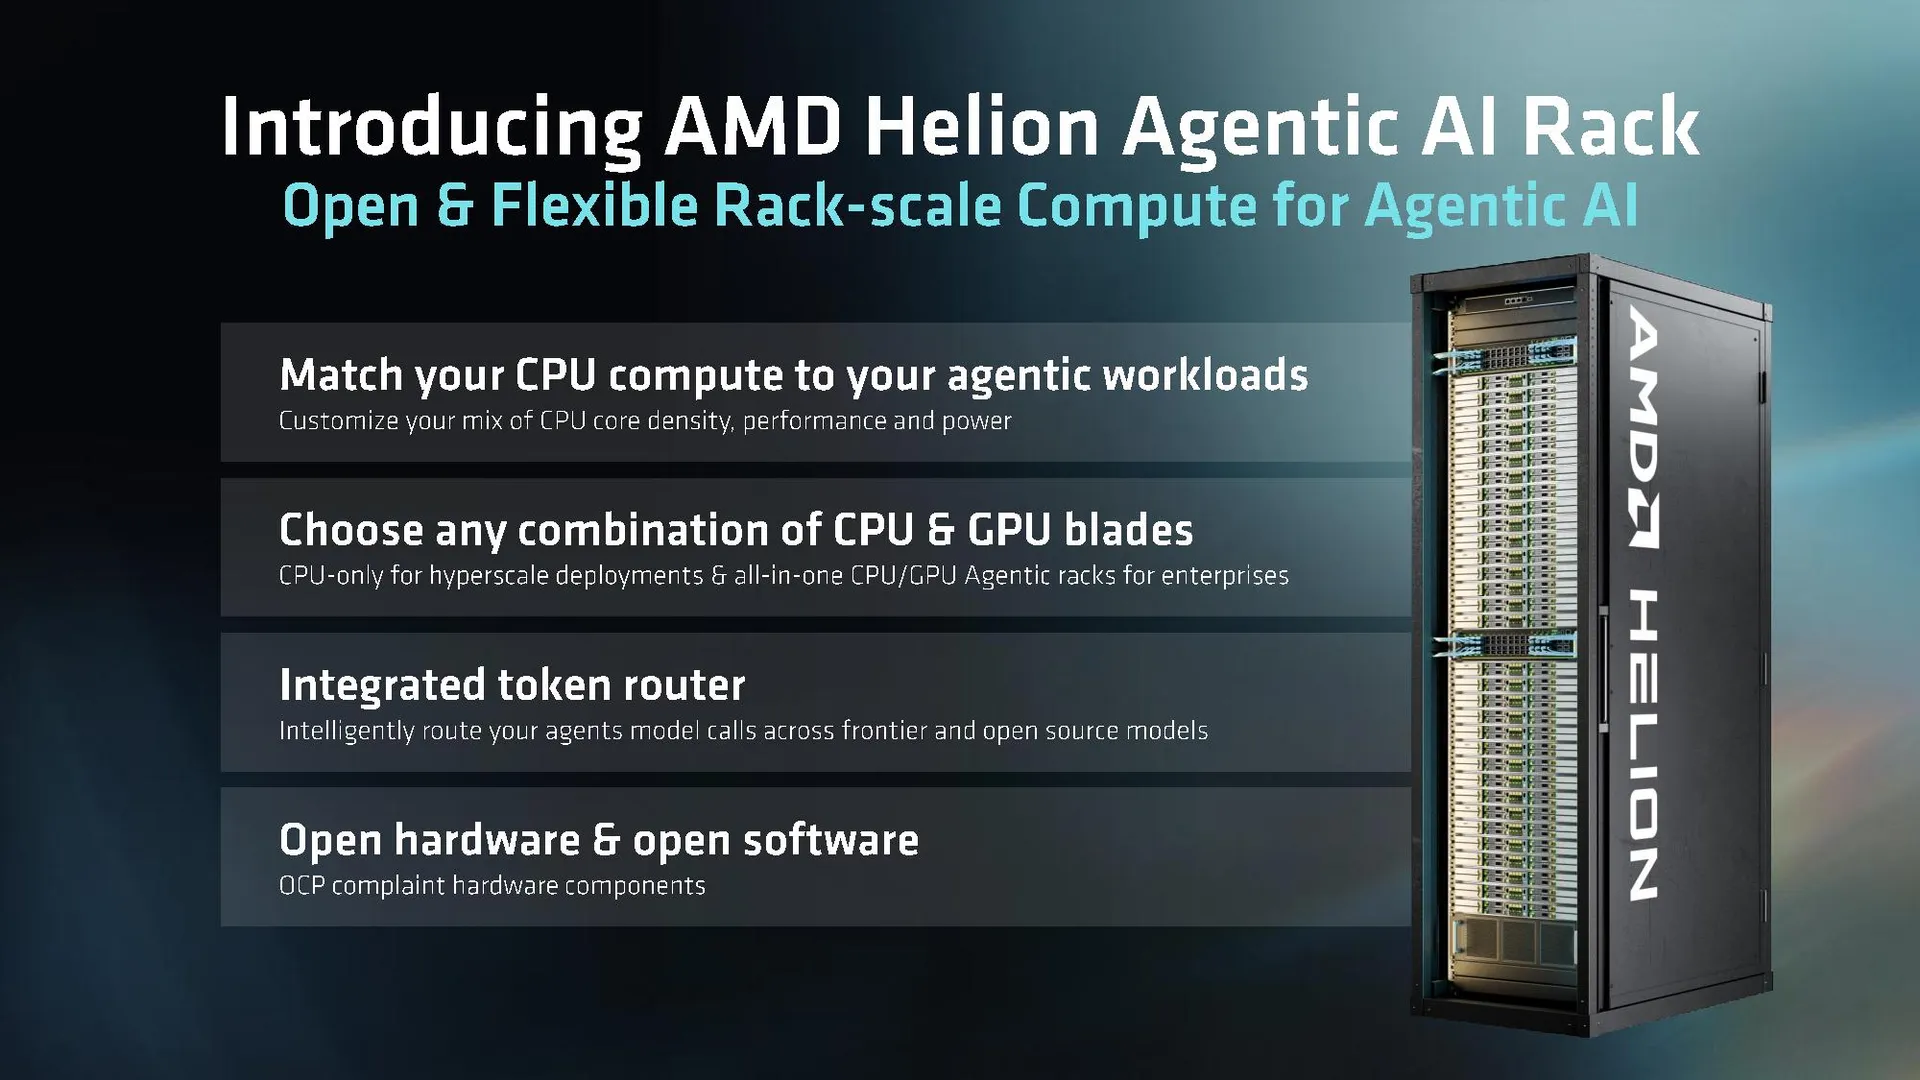
Dan McNamara, vicepresidente senior e direttore generale della divisione Computing and Enterprise AI di AMD, ha affermato che l'intelligenza artificiale degli agenti non è un singolo tipo di carico di lavoro, ma copre una varietà di scenari come agenti personali, applicazioni aziendali, esecuzione di codice e flussi di lavoro complessi. Ogni attività ha requisiti diversi per le risorse di elaborazione. Pertanto, i data center necessitano di infrastrutture in grado di regolare prestazioni, densità core e consumo energetico in base a carichi di lavoro specifici.
Ha affermato che AMD spera di utilizzare Helion per combinare le prestazioni dei processori EPYC, l'ecosistema software aperto e la progettazione rack flessibile, in modo che i partner possano costruire sistemi in base alle esigenze dei clienti e fare un uso più efficiente delle risorse energetiche limitate.
La configurazione più accattivante di Helion è un rack CPU puro che può ospitare fino a 32.768 core CPU. La soluzione utilizza il processore server EPYC di sesta generazione di AMD, l'architettura principale è Zen 6 e ha il nome in codice Venice. Secondo il progetto annunciato da AMD, l'intero rack può installare fino a 128 processori da 256 core, formando teoricamente un cluster di calcolo con 32.768 core di CPU.
Va notato che i core 32768 non sono integrati in un processore, ma sono composti da processori in un gran numero di nodi server. Helion adotta un design a livello di rack per integrare più nodi di elaborazione, apparecchiature di rete e relativa infrastruttura in un tutto per l'implementazione e la gestione centralizzata nel data center.
Questa progettazione è particolarmente adatta per scenari in cui è necessario eseguire un gran numero di attività indipendenti o parallele. Ad esempio, un'azienda può eseguire decine di migliaia di agenti IA contemporaneamente e ciascun agente richiede un ambiente di esecuzione indipendente per eseguire codice, recuperare dati, chiamare l'API interna dell'azienda o gestire attività complesse assegnategli dagli utenti. Rispetto alla semplice esecuzione dell'inferenza del modello, questo tipo di flusso di lavoro comporta solitamente più operazioni di routine di esecuzione del programma e di coordinamento del sistema e pertanto richiede una potenza di calcolo della CPU sufficiente.
Nelle tradizionali applicazioni di modelli linguistici di grandi dimensioni, dopo che l'utente ha inserito una domanda, il modello genera una risposta e il carico di calcolo è concentrato principalmente nella fase di inferenza del modello. Ma in un'applicazione agente, una richiesta può innescare una catena di operazioni: l'agente analizza l'attività, quindi richiama uno strumento di ricerca o un database, quindi esegue il codice, controlla i risultati, richiama nuovamente il modello se necessario e infine genera una risposta.
In questo processo, la GPU è responsabile dell'esecuzione di attività di elaborazione altamente parallele come l'inferenza del modello, mentre la CPU è responsabile dell'esecuzione di un gran numero di programmi, dell'elaborazione dei dati, della pianificazione delle attività e dell'invocazione di strumenti. Se il numero di agenti continua ad aumentare, anche se la GPU ha capacità di ragionamento sufficienti, risorse CPU insufficienti potrebbero limitare la velocità di elaborazione dell'intero sistema.
AMD spera di risolvere questo problema attraverso la configurazione pura della CPU Helion, fornendo un ambiente di esecuzione scalabile e su larga scala per gli agenti, lasciando l'inferenza del modello all'infrastruttura GPU indipendente per l'elaborazione.
Ciò significa che Helion non sta cercando di sostituire completamente la GPU con la CPU, ma sta cercando di separare ulteriormente le responsabilità dei due. Per i fornitori di servizi cloud su larga scala, questo design consente a diversi tipi di carichi di lavoro di utilizzare le risorse di elaborazione più adatte a loro, evitando che le costose GPU vengano occupate da un gran numero di attività ordinarie di esecuzione dei programmi.
Oltre alla versione puramente CPU, Helion fornisce anche configurazioni di livello aziendale che combinano CPU e GPU. Questa soluzione può integrare processori AMD EPYC, acceleratori GPU Instinct MI350P e nodi di elaborazione generici nello stesso rack, consentendo alle aziende di eseguire agenti, eseguire inferenze di modelli e gestire database, storage e altre attività di elaborazione generali nella stessa infrastruttura.
Secondo il progetto annunciato da AMD, la configurazione ibrida può essere dotata di un massimo di 16 acceleratori GPU Instinct MI350P e fornire una larghezza di banda di rete fino a 102 Tbps. La larghezza di banda della rete qui è l'indicatore di progettazione dell'intero sistema e non significa che ciascun nodo di calcolo possa ottenere indipendentemente la stessa larghezza di banda. Le prestazioni effettive delle comunicazioni dipendono anche dalla topologia della rete, dalla configurazione delle porte, dalla distribuzione del traffico e dal software di sistema.
In termini di nodi GPU, AMD fornisce un design server 5U utilizzando otto acceleratori Instinct MI350P. Combinando i nodi di calcolo GPU con i nodi CPU, le aziende possono regolare il numero di acceleratori in base ad attività specifiche senza dover fissare l'intero sistema a un'unica configurazione hardware.
Ad esempio, i sistemi che devono elaborare grandi quantità di dati aziendali ed eseguire flussi di lavoro complessi possono allocare più core della CPU; i sistemi che richiedono l'inferenza del modello ad alto rendimento possono aumentare le risorse della GPU. I carichi di lavoro ausiliari come database e storage possono anche utilizzare nodi di calcolo dedicati per scopi generici, riducendo la competizione per le risorse tra loro e le attività eseguite dall'agente.
AMD ha inoltre progettato una varietà di nodi di elaborazione CPU con diverse posizioni per Helion per soddisfare le diverse esigenze in termini di consumo energetico, densità di core e prestazioni single-core.
I nodi ad alta densità utilizzano processori della serie EPYC 9006 con un consumo energetico nominale di 400 watt, utilizzati principalmente per massimizzare il numero di core della CPU per unità di spazio. Il nodo bilanciato utilizza un processore a 256 core con un consumo energetico nominale di 600 watt per trovare un equilibrio tra densità del core e potenza di calcolo complessiva.
Per i carichi di lavoro che pongono maggiormente l'accento sulle prestazioni a thread singolo, AMD offre anche una configurazione del processore con 96 core e una frequenza massima di 5 GHz. Rispetto al semplice perseguimento del numero di core, questo tipo di nodo è più adatto per attività sensibili alle prestazioni a thread singolo e alla velocità di risposta.
Questo design differenziato riflette una realtà importante: gli agenti IA non sempre necessitano di tanti core CPU. Alcune attività possono essere suddivise in un gran numero di operazioni parallele, il che è adatto per server ad alta densità di core; altre attività sono limitate dalle prestazioni del thread singolo, dalla latenza della memoria o dalla velocità di risposta del servizio esterno e il semplice aumento del numero di core non può portare a corrispondenti miglioramenti delle prestazioni.
Pertanto, Helion tenta di consentire agli operatori dei data center di scegliere diverse configurazioni del processore in base ai carichi di lavoro effettivi, anziché coprire tutti gli scenari con un'unica specifica.
In termini di dissipazione del calore, Helion supporta sia soluzioni di raffreddamento ad aria che di raffreddamento a liquido. Per i rack con decine di migliaia di core CPU e apparecchiature di rete integrate ad alta velocità, la progettazione dell'alimentazione e della dissipazione del calore sono questioni ingegneristiche che non possono essere ignorate. I server ad alta densità possono migliorare l'utilizzo dello spazio della sala computer, ma comporteranno anche un carico termico più elevato per unità di spazio.
Il raffreddamento a liquido può aiutare i sistemi a rimuovere il calore generato dai processori e da altri componenti ad alta potenza in modo più efficiente, ma richiede anche il supporto dell'infrastruttura di raffreddamento, della progettazione delle tubazioni e dei processi di manutenzione. Il raffreddamento ad aria potrebbe essere più adatto per alcuni clienti che desiderano continuare a utilizzare le strutture del data center esistenti. AMD offre due soluzioni, il che significa che i partner possono scegliere in base alle condizioni della sala computer, alla scala di implementazione e ai costi operativi.
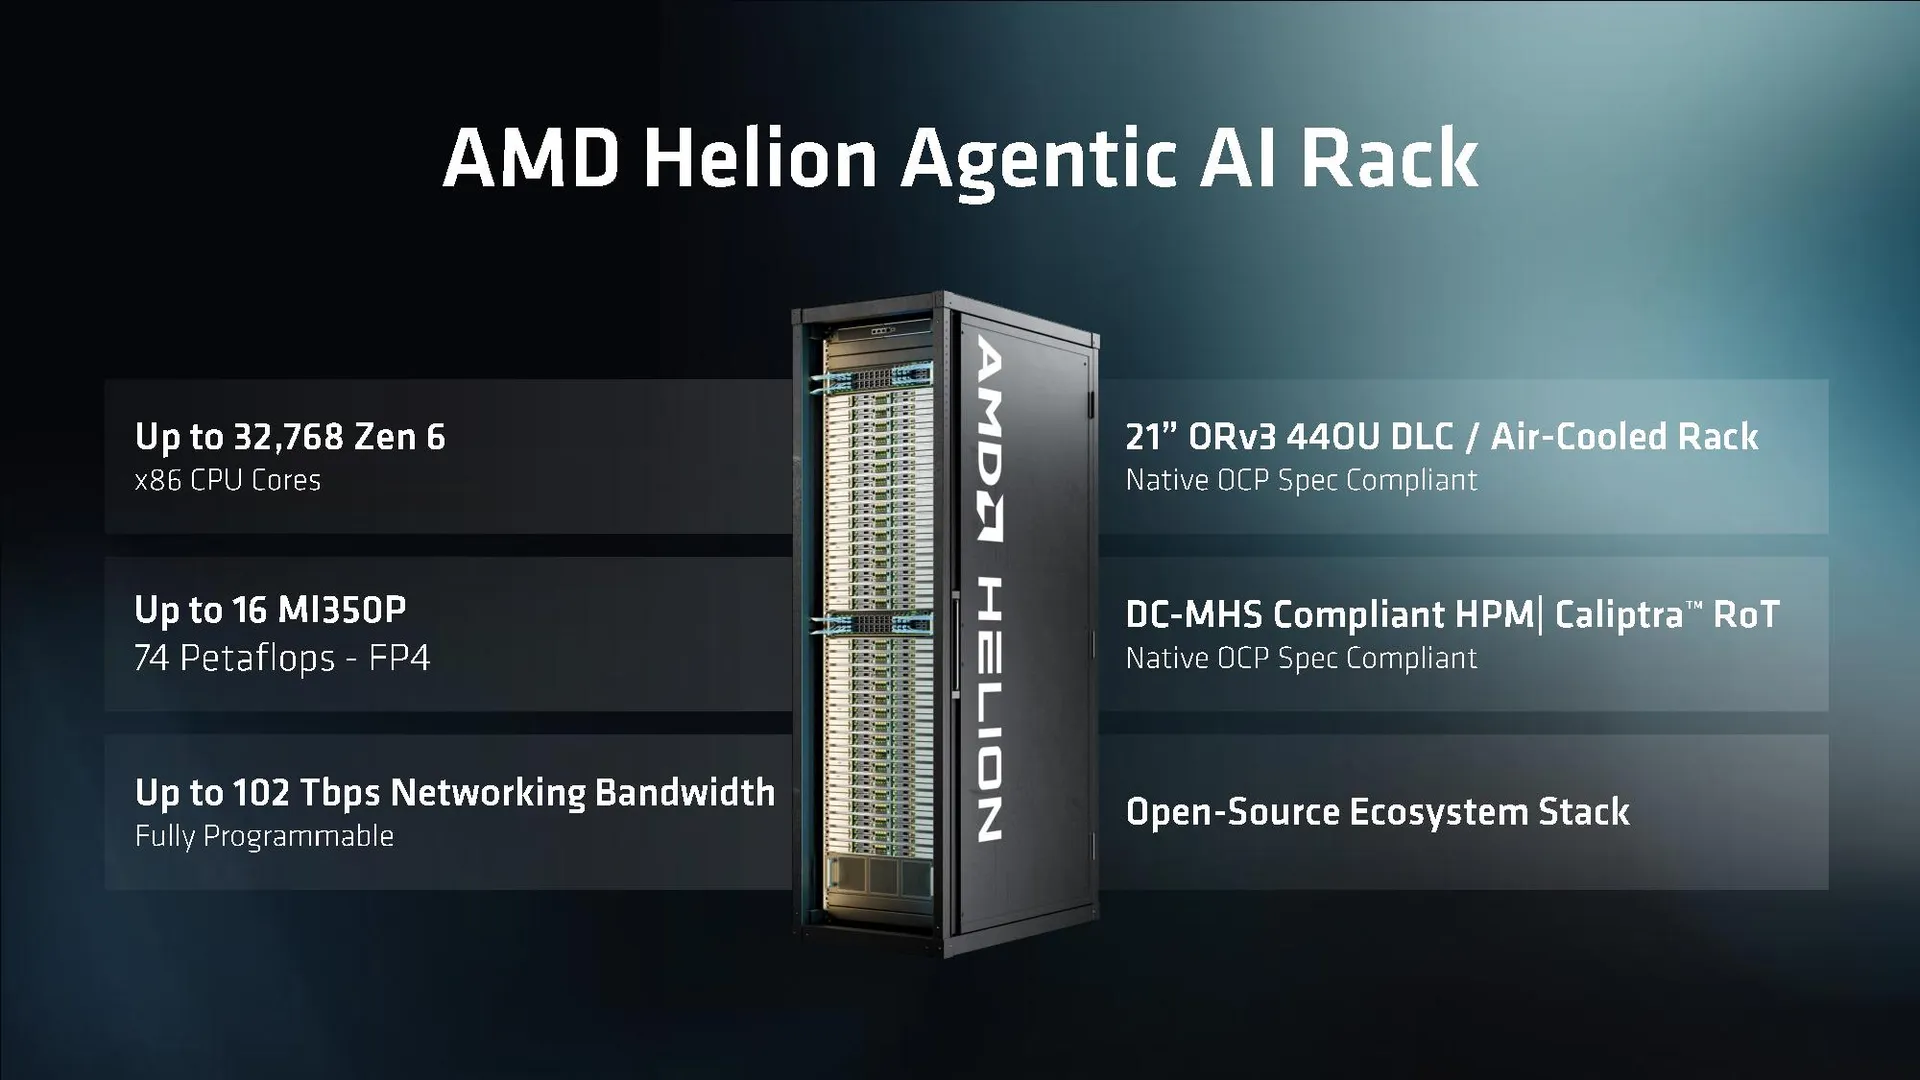
Oltre alla configurazione hardware, Helion pone l'accento anche sul software aperto e sulla progettazione del sistema. AMD prevede di fornire specifiche di riferimento rilevanti a OCP in modo che i partner possano sviluppare su una base di progettazione comune invece di fare affidamento interamente su sistemi chiusi forniti da un singolo produttore.
OCP è un'organizzazione di settore che promuove la progettazione hardware di data center aperti. Tra i suoi partecipanti figurano fornitori di servizi cloud, produttori di server e altri fornitori di infrastrutture. I progetti di riferimento aperti possono aiutare diversi produttori a integrare sistemi attorno a specifiche hardware comuni e fornire configurazioni diverse in base alle esigenze dei clienti.
AMD spera di espandere l'ecosistema di Helion in questo modo, consentendo a Dell, Hewlett Packard Enterprise, Lenovo, AMD, Foxconn e altri partner di sviluppare i propri prodotti. Ciò che i clienti acquisteranno alla fine saranno sistemi server prodotti e integrati dai partner, piuttosto che acquistare un set completo di rack standardizzati direttamente da AMD.
AMD ha affermato che la configurazione Helion è attualmente in fase di sviluppo con i partner dell'ecosistema e il suo lancio è previsto per novembre 2026. I progetti pertinenti devono ancora passare attraverso l'integrazione del sistema, la verifica e l'implementazione effettiva. Quali configurazioni potranno essere finalmente fornite, quando verranno consegnate su larga scala e le specifiche specifiche dei prodotti dei diversi produttori devono ancora essere annunciate in seguito.
Dal punto di vista della concorrenza sul mercato, Helion riflette anche che AMD sta espandendo ulteriormente il ruolo dei processori EPYC nell'infrastruttura AI.
Negli ultimi anni, la costruzione di data center IA si è concentrata principalmente su aree come gli acceleratori GPU, l'interconnessione dei server e la memoria a larghezza di banda elevata. Poiché la domanda di training e inferenza di modelli su larga scala cresce rapidamente, NVIDIA ha stabilito chiari vantaggi di mercato con i suoi prodotti GPU e il suo ecosistema software.
Ma man mano che le applicazioni IA entrano gradualmente nei processi aziendali, le attività che i data center devono gestire non sono più solo calcoli di modelli. Gli agenti potrebbero dover eseguire un gran numero di programmi, accedere a database, elaborare documenti, eseguire codice e coordinare più modelli contemporaneamente. Queste operazioni pongono nuove richieste alle risorse della CPU.
AMD spera di ottenere maggiori opportunità di mercato in questo cambiamento infrastrutturale con l'aiuto dei processori EPYC high-core. Combinando densità core della CPU, accelerazione GPU e progettazione di rete su scala rack, Helion tenta di fornire una piattaforma aperta in grado di adattarsi a diversi carichi di lavoro degli agenti.
Naturalmente, 32.768 core della CPU da soli non possono spiegare direttamente le prestazioni effettive del sistema. Le prestazioni finali dipendono anche dalla microarchitettura del processore, dalla larghezza di banda della memoria, dalla capacità della cache, dalla comunicazione tra nodi, dall'efficienza della pianificazione del software e dal grado di parallelismo del carico di lavoro. Per le attività che fanno molto affidamento sull'inferenza di modelli di grandi dimensioni, la GPU potrebbe comunque rappresentare un fattore critico nel determinare la velocità effettiva del sistema.
Allo stesso modo, l'aumento del numero di core della CPU non significa che le attività dell'agente verranno accelerate proporzionalmente. Se un numero elevato di attività deve attendere le risposte del database, accedere a reti esterne o chiamare altri servizi, il collo di bottiglia del sistema potrebbe spostarsi a livello di archiviazione, rete o software. Pertanto, il valore di Helion deve essere misurato in base alle prestazioni, all’efficienza energetica e al costo totale di proprietà nelle applicazioni reali.
Nel complesso, AMD Helion rappresenta un'espansione delle idee di progettazione dell'infrastruttura AI. AMD non enfatizza più solo il ruolo degli acceleratori GPU nell'intelligenza artificiale, ma tenta invece di fornire soluzioni informatiche integrate per gli agenti dall'esecuzione delle attività, dal ragionamento dei modelli all'elaborazione dei dati.
Man mano che gli agenti IA assumono gradualmente attività quali lo sviluppo di software, l'automazione aziendale e flussi di lavoro complessi, la divisione delle risorse tra CPU e GPU potrebbe diventare più importante. Se in futuro le aziende avranno davvero bisogno di fornire un ambiente di esecuzione indipendente per un gran numero di agenti, i server CPU ad alta densità di core avranno l'opportunità di diventare una parte importante del data center AI.
Tuttavia, Helion è ancora un progetto di riferimento aperto piuttosto che un prodotto maturo che è stato completamente implementato. La possibilità di ottenere vantaggi in termini di prestazioni e costi nelle applicazioni reali dipende in ultima analisi dall'implementazione del sistema dei partner, dalla maturità dell'ecosistema software e dalle reali esigenze dei clienti aziendali per l'infrastruttura di agent computing.
Commenti