
Riassunto:
La Sony PlayStation 5 è stata originariamente progettata come console per videogiochi, ma un progetto di sviluppo open source sta cercando di trovare un altro utilizzo per questo dispositivo di gioco: eseguire modelli linguistici di intelligenza artificiale locale di grandi dimensioni. Superando le limitazioni di sistema di PS5, gli sviluppatori hanno trapiantato il motore di inferenza open source llama.cpp sulla console e hanno utilizzato ulteriormente la sua GPU per eseguire modelli di grandi dimensioni. L’ultima dimostrazione mostra che una normale PS5 crackata può già eseguire il modello Qwen 3.8 con 27 miliardi di parametri. Utilizzando la quantizzazione a bit basso, la velocità di generazione del testo raggiunge circa 20 token al secondo.
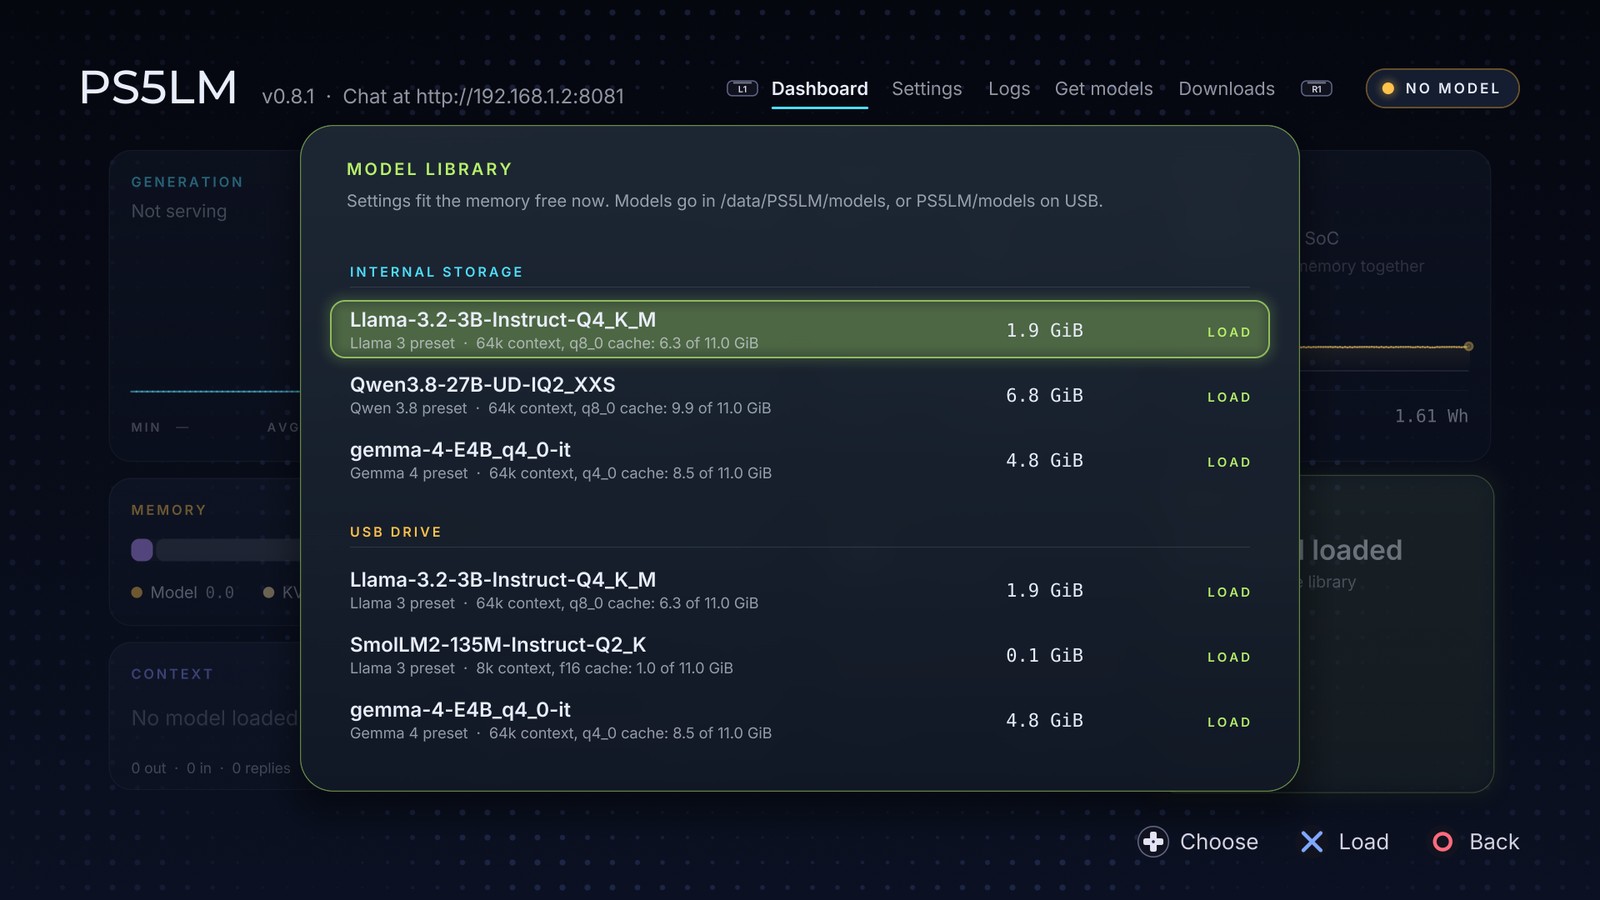
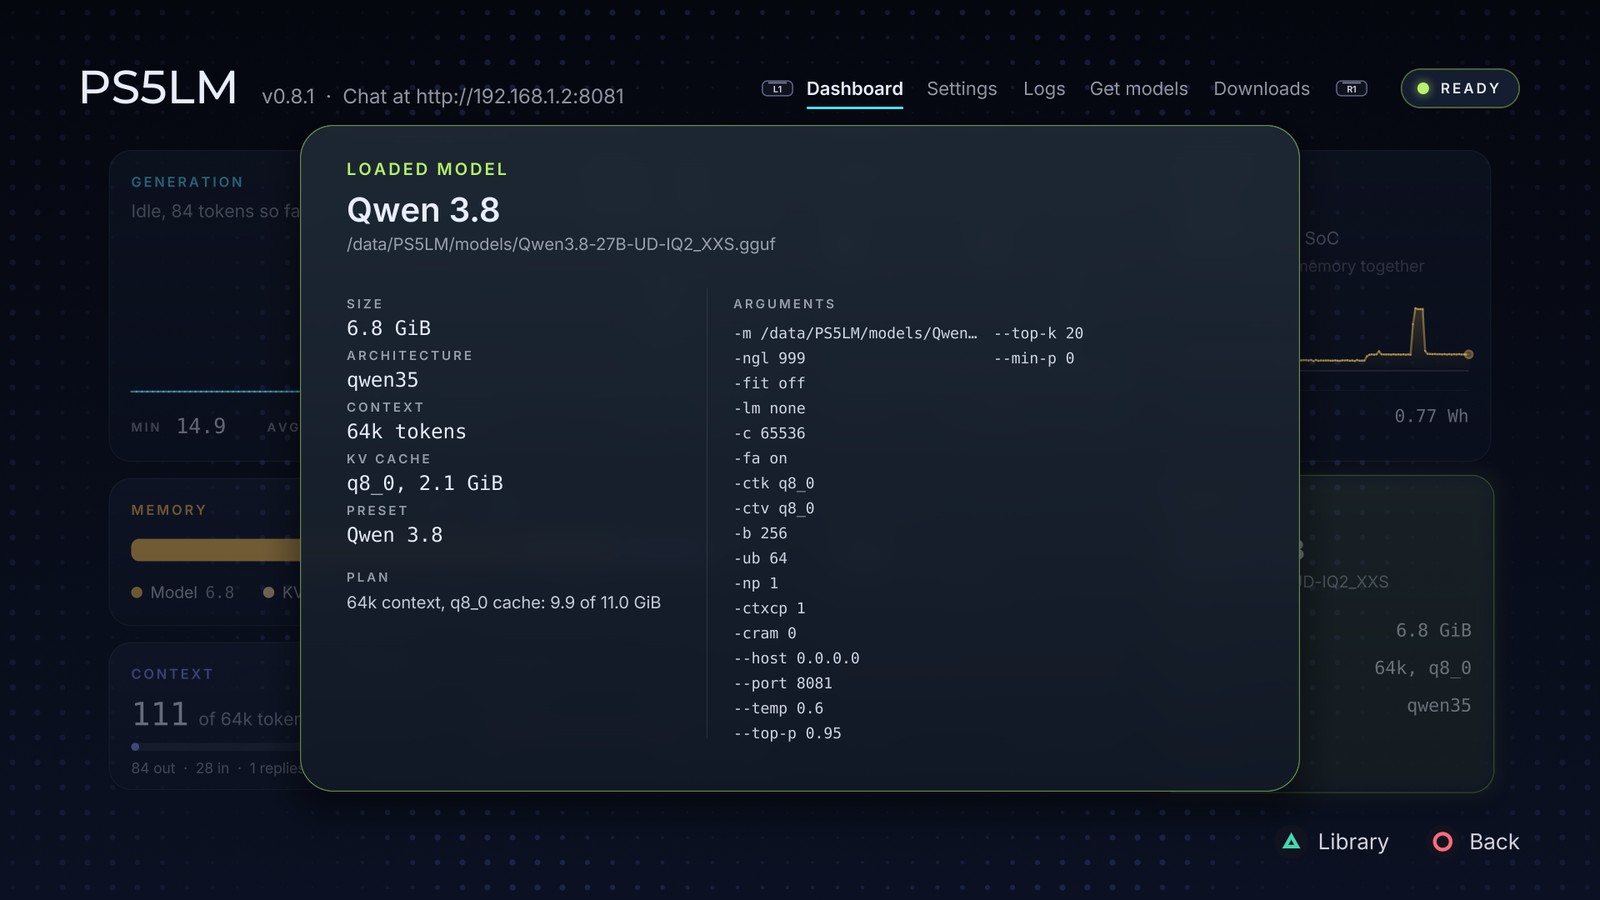
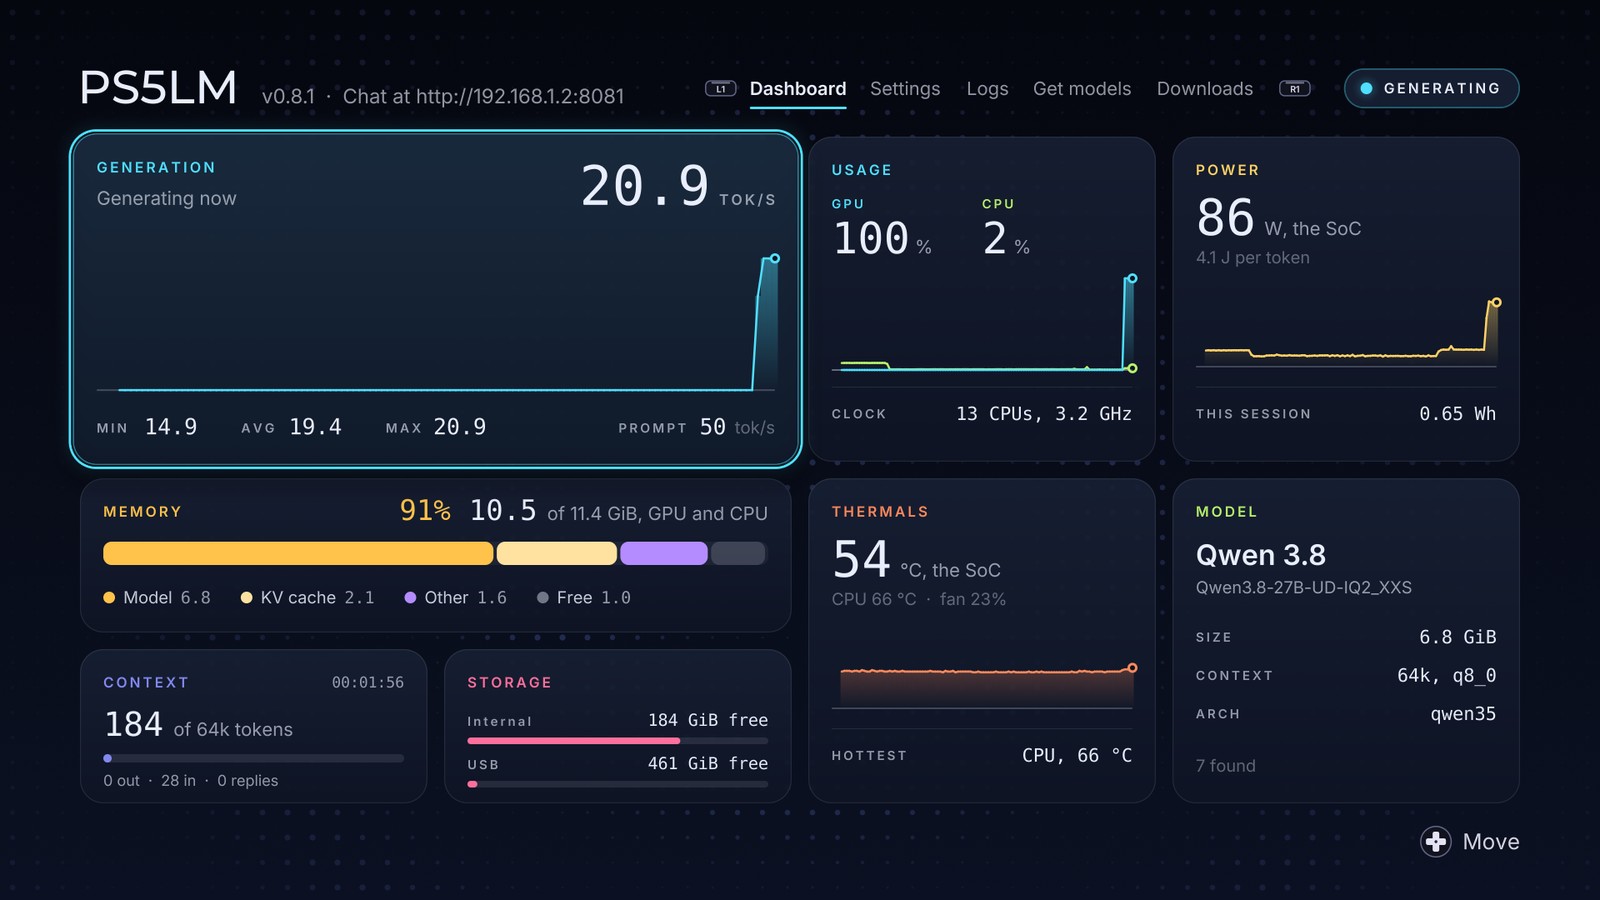
Ciò significa che un host originariamente utilizzato per eseguire i giochi può anche fungere da server locale di modelli linguistici di grandi dimensioni senza fare affidamento sui servizi di intelligenza artificiale cloud. Gli utenti possono accedere ai servizi dell'host tramite un computer o un telefono cellulare nella stessa LAN e parlare con la modella. Tuttavia, questa non è una funzionalità fornita ufficialmente da Sony, ma un'applicazione sperimentale che si basa su vulnerabilità del sistema, software non ufficiale e risultati di sviluppo della comunità.
Il progetto si chiama PS5LM ed è stato avviato dallo sviluppatore GitHub cobanov. L'idea centrale del progetto non è quella di scrivere da zero un nuovo quadro di ragionamento dell'intelligenza artificiale, ma di trapiantare lo strumento open source llama.cpp, che è stato ampiamente utilizzato per eseguire modelli locali di grandi dimensioni, sulla piattaforma PS5, per poi risolvere gradualmente i problemi di compatibilità nel sistema operativo host, nell'allocazione della memoria e nell'interfaccia di calcolo della GPU.
PS5 utilizza il processore personalizzato di AMD. La CPU utilizza l'architettura Zen 2 e dispone di 8 core; la GPU è basata sull'architettura AMD RDNA. L'host è dotato di memoria unificata GDDR6 da 16 GB e CPU e GPU devono condividere queste risorse. Sebbene PS5 non sia un dispositivo progettato specificamente per l’inferenza dell’intelligenza artificiale, la sua GPU e la memoria video a larghezza di banda elevata forniscono la base hardware per l’esecuzione di modelli in lingua locale.
PS5LM inizialmente ha adottato una modalità operativa relativamente semplice, consentendo al modello linguistico di eseguire l'inferenza attraverso la CPU host e utilizzando il browser della PS5 per fornire un'interfaccia di chat. Gli utenti possono scaricare il modello sull'host, inserire domande tramite il controller DualSense e la tastiera su schermo, quindi visualizzare le risposte generate dal modello.
Questa prima build ha dimostrato la capacità della PS5 di eseguire modelli linguistici di grandi dimensioni, ma ha subito limitazioni in termini di prestazioni e memoria. Poiché il programma viene eseguito sotto forma di payload, la memoria utilizzabile è limitata dall'ambiente di sistema. Inizialmente, solo i modelli più piccoli possono funzionare stabilmente. I documenti del progetto mostrano che la prima versione supporta principalmente modelli con dimensioni dei parametri di circa 0,8B e 2B, con una velocità di generazione del modello 2B pari a circa 9 token al secondo.
Per gli sviluppatori che desiderano eseguire modelli più grandi su PS5, lasciare semplicemente che il programma venga eseguito sulla CPU non è sufficiente. Per utilizzare appieno le prestazioni hardware dell'host, il motore di inferenza deve essere in grado di chiamare la GPU e ottenere spazio di memoria sufficiente per archiviare parametri del modello, cache e altri dati in esecuzione.
La vera svolta arriva dall'accelerazione GPU. Gli sviluppatori hanno ulteriormente implementato un ambiente di esecuzione dell'applicazione nativa su PS5 e, attraverso il driver grafico e l'interfaccia di elaborazione Vulkan sviluppata dalla comunità, llama.cpp può chiamare la GPU host per eseguire calcoli sulla rete neurale. Rispetto alla soluzione precedente che poteva fare affidamento solo sulla CPU, questa modifica non solo migliora la velocità di inferenza, ma consente anche al programma di ottenere più memoria disponibile per provare a eseguire modelli più grandi.
Nell'ultima dimostrazione, PS5 ha eseguito con successo il modello Qwen 3.8 27B lanciato dal team Alibaba Tongyi Qianwen. Il modello ha 27 miliardi di parametri e utilizza un’architettura di attenzione ibrida. L'obiettivo della progettazione è fornire forti capacità di comprensione del linguaggio, ragionamento e generazione di codice su risorse hardware relativamente limitate.
Tuttavia, PS5 non carica 27 miliardi di parametri direttamente in memoria con assoluta precisione. Per adattare il modello alle condizioni hardware dell'host, gli sviluppatori hanno utilizzato la tecnologia di quantizzazione a bit basso per comprimere i parametri del modello in uno spazio di archiviazione più piccolo. La dimostrazione utilizza versioni quantizzate come IQ2_XXS e il file del modello varia da diversi GB a 7 GB e la dimensione specifica dipende dallo schema di quantizzazione.
La quantificazione è una tecnologia chiave nell'esecuzione di modelli locali di grandi dimensioni. In genere, i parametri del modello vengono archiviati utilizzando un formato dati con precisione più elevata, ma ciò consuma molta memoria. Comprimendo i parametri in valori di larghezza di bit inferiori, è possibile ridurre significativamente i requisiti di memoria e la quantità di trasferimento dati durante l'inferenza. Il costo è che alcune informazioni di precisione andranno perse, il che potrebbe influire sulla qualità della risposta del modello, sulla capacità di ragionamento o sulle prestazioni di attività specifiche. Pertanto, essere in grado di eseguire un modello da 27 miliardi di parametri non significa che PS5 possa eseguire un modello delle stesse dimensioni con la massima precisione.
I dati di test rilasciati dallo sviluppatore mostrano che quando si utilizza la GPU per eseguire l'inferenza, la velocità di generazione del testo di Qwen 3.8 27B può raggiungere circa 20 token al secondo. Il token è l'unità di base per i modelli linguistici di grandi dimensioni per l'elaborazione del testo. Non è strettamente equivalente a un carattere cinese o a una parola inglese. Pertanto, 20 token al secondo non possono essere semplicemente intesi come la generazione di 20 caratteri cinesi al secondo. Tuttavia, è abbastanza veloce perché le conversazioni interattive abbiano una certa praticità, piuttosto che essere solo una dimostrazione tecnica per dimostrare che un modello può decollare.
Oltre al modello Qwen, lo stesso progetto ha annunciato anche i risultati dei test di altri modelli. Gemma 4 E4B genera circa 61 token al secondo, mentre Llama 3.2 3B raggiunge circa 124 token al secondo. I modelli di piccole dimensioni hanno meno parametri, richiedono meno calcoli e letture di dati e quindi generalmente raggiungono velocità di generazione più elevate.
Questi risultati dovrebbero comunque essere considerati risultati di test pubblicati dagli sviluppatori in specifiche configurazioni software e hardware, piuttosto che benchmark di settore verificati da una piattaforma di test unificata. Modelli diversi hanno scale di parametri, metodi di quantificazione, durate del contesto e attività di calcolo diverse. Le loro capacità globali non possono essere giudicate basandosi esclusivamente sul numero di token generati al secondo.
Il progetto dimostra anche la possibilità di trasformare PS5 in un server AI LAN. Eseguendo un'interfaccia di servizio compatibile con API OpenAI sull'host, altri dispositivi possono inviare richieste sulla stessa rete e ottenere risposte generate dal modello. In questo modo, gli utenti non devono sempre stare di fronte allo schermo della TV per utilizzare la console e possono anche chiamare il modello locale della PS5 tramite un computer o un telefono cellulare.
Questo approccio è interessante per gli utenti che desiderano implementare servizi di intelligenza artificiale locale nelle proprie reti domestiche. Quando il modello viene eseguito localmente, in linea di principio i contenuti delle conversazioni quotidiane non devono essere inviati a servizi AI cloud di terze parti e gli utenti non devono pagare tariffe di inferenza cloud in base al numero di chiamate. Tuttavia, l'effettiva protezione della privacy dipende ancora dal software installato, dalla configurazione di rete e dal fatto che il dispositivo abbia altri comportamenti di trasmissione dei dati. Il sistema non può essere considerato assolutamente sicuro semplicemente "funzionando localmente".
Allo stesso tempo, lo sviluppo di PS5LM si basa ancora su una serie di tecnologie non ufficiali. Gli utenti devono disporre di una PS5 in grado di eseguire il relativo programma di cracking e utilizzare firmware di sistema compatibile e strumenti di caricamento del carico utile. La gamma di firmware applicabile elencata nel documento di progetto va da 7.00 a 13.60, ma funzioni, prestazioni e compatibilità specifiche possono variare a seconda del modello host e della versione del software.
Craccare la console non significa che tutti gli utenti PS5 possano installare direttamente il programma. La normale versione al dettaglio di PS5 non può scaricare ed eseguire PS5LM tramite il PlayStation Store come i normali giochi. Gli utenti devono prima risolvere problemi come le autorizzazioni di accesso al sistema, il caricamento non ufficiale dei programmi e l'ambiente operativo, che rappresentano ancora una certa soglia per gli utenti che non hanno familiarità con il cracking degli host e lo sviluppo di software.
Inoltre, la modifica del sistema host può comportare rischi per la sicurezza e la stabilità, può anche influire sull'uso dei servizi online e coinvolgere i termini di servizio pertinenti di Sony. Gli sviluppatori consigliano di condurre ricerche solo sui dispositivi di loro proprietà o autorizzati. Per gli utenti di console che lo utilizzano principalmente per i normali giochi, in particolare quelli che si connettono frequentemente a PlayStation Network, non è necessario hackerare avventatamente il dispositivo solo per eseguire l'IA locale.
Dal punto di vista dell'hardware, l'importanza di questo esperimento non è solo quella di consentire alla console di gioco di rispondere alle domande. Illustra inoltre che la GPU e la memoria video ad alta velocità installate nelle apparecchiature di gioco di livello consumer possono anche svolgere parte del lavoro normalmente completato dalle apparecchiature informatiche dedicate all’intelligenza artificiale dopo un appropriato adattamento del software.
L'inferenza del modello linguistico di grandi dimensioni è spesso influenzata in modo significativo dalla capacità di memoria e dalla larghezza di banda. Quando il modello genera testo, deve leggere continuamente un gran numero di parametri e mantenere cache sensibili al contesto. L'architettura di memoria unificata di PS5 consente a CPU e GPU di condividere risorse di memoria ad alta velocità, ma anche il sistema stesso deve occuparne una parte, quindi lo spazio disponibile per i modelli è molto inferiore alla capacità nominale di 16 GB.
Ecco perché gli sviluppatori devono risolvere contemporaneamente problemi quali la quantizzazione, la gestione della memoria e le interfacce di elaborazione GPU. Avere semplicemente una GPU abbastanza potente non garantisce che un modello funzioni senza intoppi; se l'architettura del modello è supportata, se il driver può eseguire le operazioni di calcolo richieste e se il sistema può fornire memoria sufficiente per il programma di inferenza influenzeranno il risultato finale.
Questo risultato fornisce anche un riferimento interessante per la selezione dell'hardware AI locale. Tradizionalmente, gli utenti che desideravano eseguire modelli linguistici più ampi a casa spesso dovevano acquistare un computer con una scheda grafica dedicata e pagare un extra per la capacità di memoria e il costo complessivo della macchina. La PS5 ha già una GPU relativamente potente e una memoria ad alta velocità, quindi gli sviluppatori sperano di dimostrare che anche l'hardware di gioco esistente può essere riutilizzato senza dover acquistare una workstation AI dedicata.
Ma questo non significa che PS5 possa sostituire completamente i computer IA. Le sue risorse hardware sono ancora limitate da configurazioni fisse, ingombro del sistema e ambienti software non ufficiali. Rispetto ai computer con memoria grafica più grande, driver maturi e ricchi strumenti di sviluppo, PS5 richiede un lavoro di adattamento di base maggiore per eseguire modelli di grandi dimensioni e gli utenti non possono aggiornare liberamente la scheda grafica o espandere la memoria grafica come i normali computer AI.
Da un punto di vista pratico, questo tipo di progetto è attualmente più adatto agli appassionati di tecnologia, agli sviluppatori open source e agli utenti interessati all'intelligenza artificiale locale per studiare il ragionamento dei modelli, il GPU computing e gli ambienti operativi integrati. Per le aziende che necessitano di eseguire stabilmente servizi di intelligenza artificiale a livello di produzione, server GPU dedicati o computer ottimizzati da stack software maturi sono ancora più adatti.
Lo sviluppo di PS5LM riflette anche una tendenza nell'ecosistema dell'intelligenza artificiale open source: i framework di inferenza dei modelli e i modelli openweight hanno gradualmente abbassato la soglia per l'esecuzione dell'intelligenza artificiale, mentre gli sviluppatori della comunità continuano a provare a trasferire questi strumenti su diverse piattaforme hardware. In passato, le console di gioco erano viste principalmente come dispositivi di intrattenimento chiusi; ora, grazie agli sforzi delle comunità di cracking e reverse engineering, sono diventati anche piattaforme per esplorare il GPU Computing e le applicazioni native di intelligenza artificiale.
In generale, si tratta di un tentativo tecnico rappresentativo di consentire a una PS5 crackata di eseguire un modello linguistico di grandi dimensioni con 27 miliardi di parametri a una velocità di circa 20 token al secondo. Dimostra il potenziale utilizzo dell’hardware della console di gioco e dimostra anche che attraverso l’adattamento del software e la compressione dei modelli, modelli linguistici di una certa scala possono essere eseguiti su dispositivi IA non tradizionali. Tuttavia, questo risultato è ancora un progetto comunitario che si basa su un ambiente crackato, e c'è ancora una distanza considerevole tra esso e le funzioni ufficiali che gli utenti comuni possono utilizzare senza operazioni complicate.
Commenti