
Riassunto:
Per gli utenti Windows che desiderano eseguire modelli di intelligenza artificiale sui propri computer, esiste sempre una certa soglia per l'installazione e la configurazione degli strumenti di intelligenza artificiale locali. Gli utenti non devono solo trovare file di modello adatti, ma anche considerare questioni quali il formato del modello, la compatibilità hardware, l'installazione del motore di inferenza e i parametri di avvio. Oggi, l'applicazione open source Llama per Windows, lanciata dagli sviluppatori legati ai team Hugging Face e llama.cpp, tenta di semplificare questo processo in poche semplici operazioni, consentendo agli utenti di scaricare ed eseguire modelli linguistici locali di grandi dimensioni su computer Windows senza utilizzare la riga di comando.
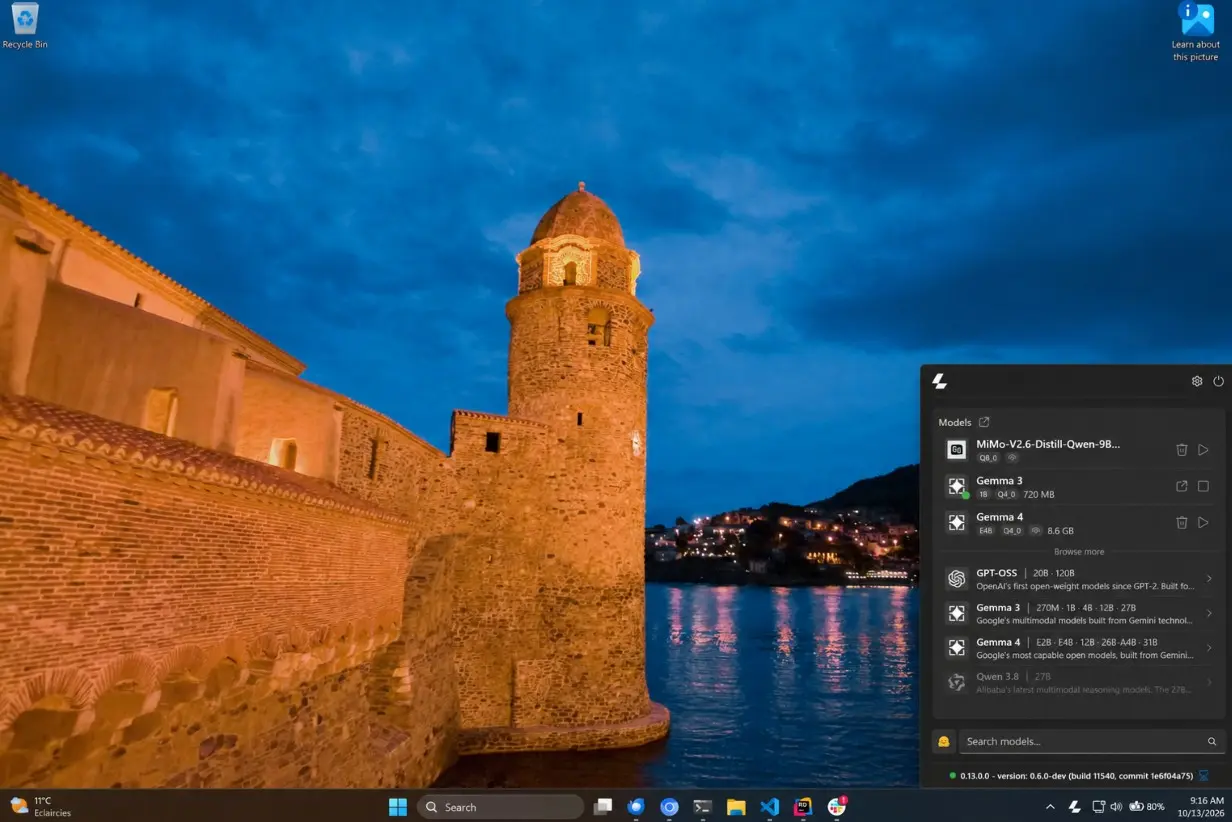
Llama per Windows sarà lanciato nell'ottobre 2026 ed è la controparte Windows della versione macOS dell'applicazione Llama. È un'applicazione Windows 11 gratuita e open source basata sulla tecnologia WinUI 3 di Microsoft e viene eseguita principalmente nell'area di notifica del sistema. Dopo averlo installato, gli utenti potranno aprire il pannello di controllo tramite l'icona dell'applicazione nell'area di notifica della barra delle applicazioni, senza dover mantenere una finestra indipendente come i software tradizionali.
La caratteristica più importante di questa applicazione è la sua capacità di connettersi direttamente al magazzino del modello Hugging Face. Hugging Face è attualmente un'importante piattaforma di hosting per modelli di intelligenza artificiale open source, che riunisce un gran numero di modelli e le loro versioni derivate da diversi team di sviluppo. In passato, gli utenti dovevano solitamente trovare da soli un file modello adatto, determinare se il formato del file era corretto, quindi scaricare la versione corrispondente e avviarla tramite il motore di inferenza. Per l’utente medio che non ha familiarità con la tecnologia dell’intelligenza artificiale, questo processo può essere piuttosto noioso.
Llama per Windows fornisce un elenco di modelli consigliati all'interno dell'applicazione. Gli utenti possono verificare la dimensione dei parametri del modello, lo spazio su disco e se supporta funzioni visive come la comprensione delle immagini, quindi selezionare un modello adatto al proprio computer da scaricare. Dopo aver selezionato il modello, fai semplicemente clic sull'opzione corrispondente e l'app inizierà automaticamente il download e visualizzerà l'avanzamento del download.
Questo strumento utilizza principalmente modelli di quantizzazione in formato GGUF. GGUF è guidato dall'ecosistema llama.cpp ed è diventato uno dei formati di file modello ampiamente utilizzati per l'esecuzione locale di modelli linguistici di grandi dimensioni open source. La tecnologia di quantificazione può ridurre lo spazio di archiviazione e la memoria di esecuzione richieste dal modello riducendo l'accuratezza numerica dei parametri del modello, offrendo ai modelli che originariamente richiedono configurazioni hardware più elevate l'opportunità di essere eseguiti su normali personal computer. Tuttavia, la quantizzazione di solito comporta anche un certo grado di perdita di precisione e l’impatto specifico dipende dal modello, dal metodo di quantizzazione e dallo scenario di utilizzo.
In termini di gestione dei modelli, Llama per Windows elencherà i modelli che sono stati scaricati sul computer. Gli utenti possono caricare o scaricare direttamente i modelli e parlare con i modelli tramite l'interfaccia web integrata. L'applicazione visualizza inoltre lo stato corrente del modello, consentendo agli utenti di sapere se il modello è stato avviato senza dover controllare manualmente il processo in background.
Il motore di inferenza sottostante può anche essere gestito automaticamente dall'applicazione. Llama per Windows utilizza llama.cpp come componente principale in esecuzione. Se nel sistema è già presente un servizio llama.cpp utilizzabile, l'applicazione può connettersi al servizio esistente; se non è installato, può essere installato tramite il programma di installazione ufficiale. L'intero processo non richiede diritti di amministratore e gli utenti non devono compilare da soli il codice sorgente o configurare manualmente parametri di avvio complessi.
Questo design abbassa la barriera di accesso per l'intelligenza artificiale locale, ma non significa che tutti i modelli possano funzionare senza problemi su qualsiasi computer. Le prestazioni effettive del modello dipendono ancora dal processore, dalla memoria, dalla scheda grafica, dalla capacità della memoria video e dalle dimensioni del modello stesso. I modelli con parametri di dimensioni inferiori sono generalmente più facili da eseguire su un normale computer, mentre i modelli più grandi possono richiedere molta memoria o persino una workstation con una scheda grafica ad alte prestazioni per ottenere buoni tempi di risposta.
Llama per Windows fornisce anche un'interfaccia di chat simile a un avvio rapido a livello di sistema. Gli utenti possono premere il tasto di scelta rapida Alt+Spazio in altre applicazioni per visualizzare la finestra di chat mobile e interagire direttamente con il modello attualmente caricato. La finestra adotta un design leggero e la conversazione non verrà chiusa immediatamente dopo essere stata nascosta e potrà continuare a essere utilizzata quando viene richiamata nuovamente. Ciò significa che gli utenti non devono passare ripetutamente ad applicazioni AI autonome quando scrivono documenti, navigano sul Web o scrivono codice.
Oltre alla funzione di chat per gli utenti comuni, il software tiene conto anche delle esigenze degli sviluppatori. L'applicazione può avviare un server locale basato su llama.cpp sul computer locale e fornire servizi modello tramite un'API compatibile con l'interfaccia OpenAI. L'indirizzo del servizio predefinito è
http://localhost:9931. Gli sviluppatori possono fare in modo che i propri script, applicazioni o agenti AI chiamino modelli locali senza dover inviare tutte le richieste ai servizi cloud remoti.
Poiché l'interfaccia è compatibile con l'API OpenAI, alcuni strumenti originariamente sviluppati per l'interfaccia OpenAI possono avere l'opportunità di accedere a modelli eseguiti localmente semplicemente modificando l'indirizzo del servizio e le relative configurazioni. Tuttavia, la compatibilità delle interfacce non significa che tutte le funzioni siano completamente coerenti. La possibilità di utilizzo dipende comunque dalle capacità API richieste dal cliente e dal fatto che il modello caricato supporti le funzioni corrispondenti.
Ciò rende Llama per Windows non solo uno strumento di chat locale, ma anche una piattaforma di intelligenza artificiale sui personal computer. Lo stesso file modello può essere condiviso da più applicazioni e gli sviluppatori non devono scaricare un modello separato per ciascun programma, riducendo così l'occupazione ripetuta dello spazio su disco. Questa architettura ha un certo valore pratico per gli utenti che desiderano creare localmente assistenti di programmazione, strumenti di analisi dei documenti o altre applicazioni AI.
In termini di privacy, il vantaggio principale dell'esecuzione dei modelli a livello locale è che il processo di inferenza non deve fare affidamento su servizi di intelligenza artificiale remoti. Secondo la descrizione del progetto, le parole prompt immesse dall'utente e l'inferenza del modello vengono eseguite in modo nativo e l'app non raccoglie dati di telemetria, analizza eventi o genera identificatori di installazione specializzati. Tuttavia, gli utenti dovranno comunque connettersi a Internet per scaricare i file del modello e ottenere gli aggiornamenti software. La descrizione del progetto menziona inoltre che queste richieste di rete porteranno un'identificazione standard dell'agente utente che contiene informazioni quali la versione del software, la versione di Windows e l'architettura del processore. Pertanto, la cosiddetta operazione locale non significa che l'intero processo di installazione e manutenzione non richieda affatto una rete, ma significa che l'inferenza del modello e l'elaborazione testi tempestiva possono rimanere localmente.
Anche la compatibilità hardware è al centro di questa app. Llama per Windows supporta le piattaforme x64 e ARM64 di Windows 11 e fornisce supporto nativo per i dispositivi Windows on Arm. Ciò è particolarmente importante per i notebook Windows dotati di processori Arm, perché in passato alcuni strumenti di intelligenza artificiale locali sono stati sviluppati principalmente per i tradizionali computer x86 e potrebbero dover fare affidamento sulla simulazione in esecuzione sui dispositivi Arm o mancare di componenti precompilati corrispondenti.
Il progetto menzionava anche il supporto per la piattaforma NVIDIA RTX Spark. La piattaforma è orientata verso applicazioni di elaborazione AI locali e può fornire un'altra opzione hardware per gli utenti che desiderano eseguire modelli più grandi in un ambiente desktop. Tuttavia, il fatto che il software supporti una determinata piattaforma non significa che tutti i modelli possano raggiungere prestazioni ideali. I risultati operativi specifici dipendono ancora dalle dimensioni del modello, dalla capacità di memoria e dalla configurazione di inferenza.
Llama per Windows può essere ottenuto tramite il sito Web ufficiale di Llama oppure è possibile scaricare il pacchetto di installazione corrispondente dalla pagina di rilascio GitHub del progetto. Una volta installata, gli utenti possono aprire l'app, selezionare un modello, attendere il completamento del download e quindi iniziare a utilizzarla tramite una finestra di chat mobile o un'interfaccia web. Va notato che l'app è attualmente per Windows 11 e non elenca Windows 10 come piattaforma supportata.
In generale, Llama per Windows non reinventa la tecnologia di esecuzione di modelli linguistici locali di grandi dimensioni, ma integra i passaggi originariamente sparsi in magazzini di modelli, motori di inferenza e strumenti a riga di comando in un'interfaccia leggera. Il suo valore più grande risiede nell'abbassare la soglia di utilizzo pur mantenendo funzionalità di scalabilità come API locali e flussi di lavoro degli sviluppatori.
Mentre il modello open source continua a svilupparsi, l'esecuzione dell'intelligenza artificiale a livello locale si sta gradualmente trasformando da un progetto alla rinfusa che richiede una certa esperienza tecnica in uno scenario applicativo che i normali utenti di computer possono provare. Il fatto che Llama per Windows possa diventare uno strumento mainstream dipende dalla sua stabilità, dalla gamma di supporto del modello e dall'effettiva esperienza di esecuzione, ma almeno rende tutto più semplice per gli utenti Windows: possono iniziare a esplorare l'esecuzione di modelli di intelligenza artificiale sui propri computer senza dover prima apprendere complesse operazioni da riga di comando.
Indirizzo di download:
https://llama.app/download/windows
https://github.com/ggml-org/Llama-Windows
Commenti