
Riassunto:
Sony ha recentemente presentato un nuovo brevetto per una tecnologia di intelligenza artificiale, che propone di utilizzare l'intelligenza artificiale per prevedere il fotogramma successivo del gioco prima che la scheda grafica completi il rendering, riducendo così il ritardo dello schermo e cercando di evitare ulteriori problemi di ritardo causati da alcune tecnologie di generazione di fotogrammi esistenti. Secondo la descrizione del brevetto, il sistema può generare un'immagine prevista in anticipo in base al fotogramma renderizzato più recentemente e alle ultime informazioni di input del controller del giocatore, e visualizzarla al giocatore prima che il fotogramma successivo venga ufficialmente renderizzato.
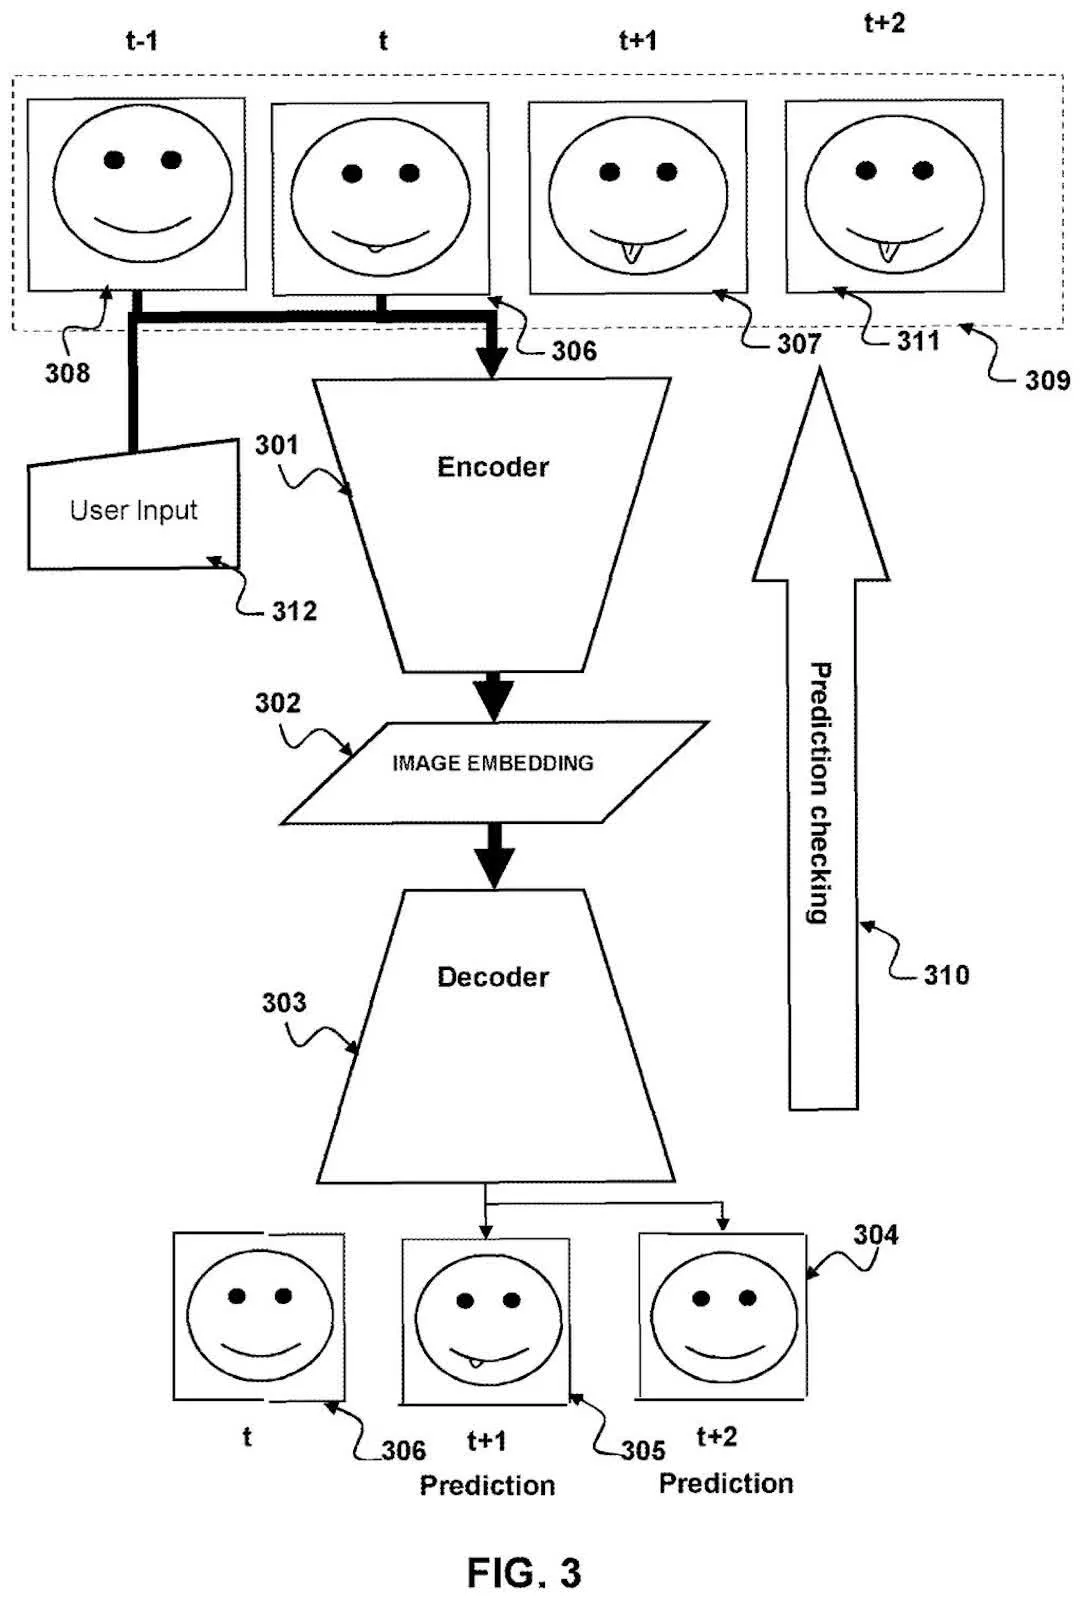
Questa tecnologia mira principalmente a un difetto nell'attuale schema di generazione di frame parziali. Molte soluzioni esistenti richiedono l'ottenimento di due frame completati prima di poter calcolare e generare il frame interpolato tra di loro, e il processo di attesa del completamento del secondo frame introduce ulteriori ritardi. Il nuovo metodo di Sony tenta di saltare questa fase di attesa e di utilizzare direttamente le immagini esistenti per prevedere le immagini future invece di interpolare tra due fotogrammi.
In teoria, questo metodo dovrebbe mantenere un output delle immagini più fluido quando il carico di rendering aumenta e la frequenza dei fotogrammi diminuisce. Tuttavia, il documento di brevetto non fornisce risultati specifici dei test prestazionali, quindi resta da verificare il suo impatto effettivo sul miglioramento della latenza e sulla qualità dell'immagine finale.
Dal punto di vista dell'implementazione tecnica, Sony ha progettato un'architettura di codifica e decoder addestrata congiuntamente. Il codificatore è responsabile della conversione dell'immagine renderizzata in una rappresentazione numerica compatta, un vettore di incorporamento; il decodificatore genera quindi un'immagine prevista basata su questi dati.
Mentre il gioco è in esecuzione, il sistema funzionerà in sincronia con la pipeline di rendering grafico. Quando l'hardware esegue il rendering del fotogramma successivo, l'intelligenza artificiale elabora contemporaneamente il fotogramma precedente e invia i risultati della previsione nel buffer di visualizzazione. In questo modo, il fotogramma previsto può essere visualizzato prima che il fotogramma effettivamente renderizzato venga completato, colmando il gap di rendering.
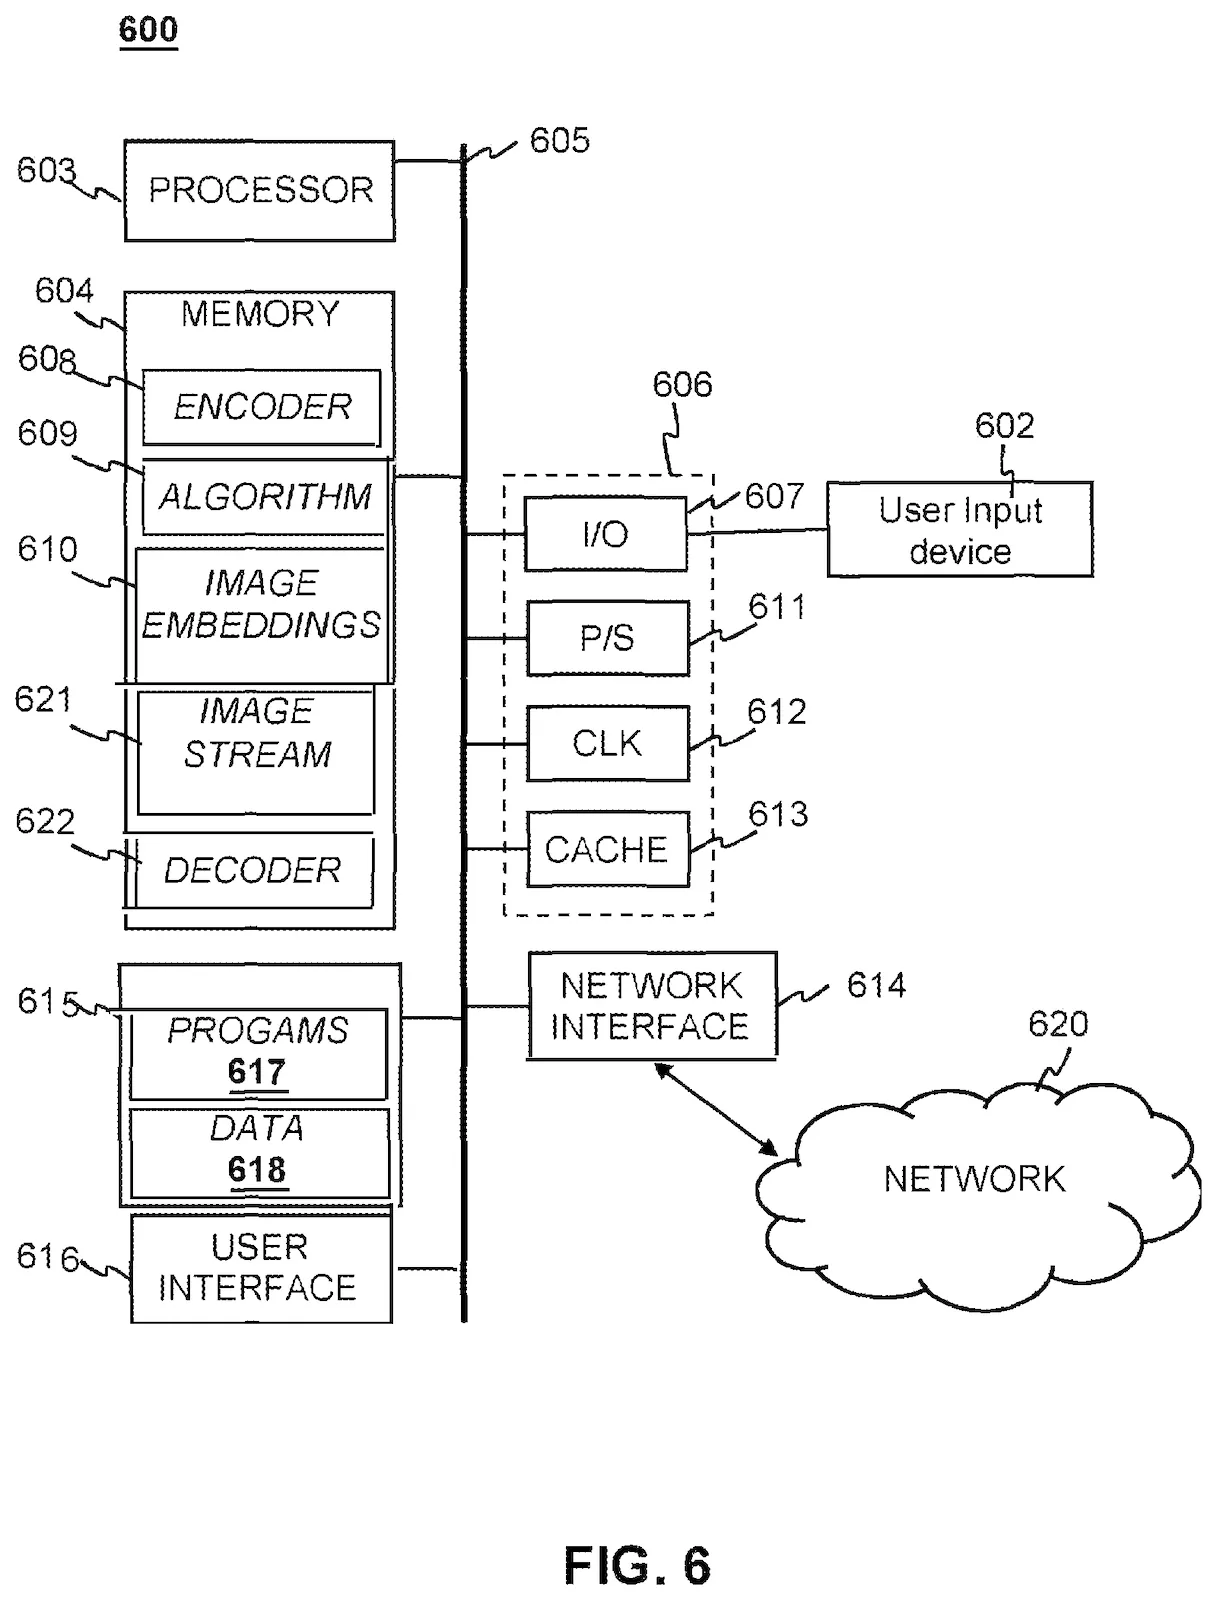
Il brevetto menziona inoltre che il modello può utilizzare vettori di movimento e i dati di input del controller più recenti per migliorare la precisione della previsione. I vettori di movimento possono riflettere la direzione del movimento e la velocità degli oggetti nell'immagine, mentre le operazioni chiave possono riflettere le ultime intenzioni comportamentali del giocatore. Entrambi possono fornire all’IA più informazioni rispetto al solo frame precedente.
La fase di training utilizza fotogrammi video continui come origine dati. La rete neurale inizia prima l'addestramento con pesi casuali, riceve un fotogramma dell'immagine come input e tenta di prevedere il fotogramma successivo, quindi confronta i risultati della previsione con i fotogrammi successivi reali, misura l'errore attraverso il valore di perdita e ottimizza continuamente il modello.
Secondo la descrizione del brevetto, il sistema rileverà continuamente se il valore della perdita raggiunge la soglia impostata durante il processo di formazione. Poiché il video continuo stesso può fornire immagini di riferimento reali, l'intero processo di formazione non richiede l'annotazione manuale dei dati. Inoltre, il decodificatore emette più canali di colore rispetto a quelli ricevuti dal codificatore, il che significa che il sistema avrà la capacità di generare più fotogrammi previsti contemporaneamente in futuro.
Oltre alla soluzione AI, Sony ha proposto anche un'alternativa non basata sull'intelligenza artificiale. Questo schema genera fotogrammi sintetici spostando blocchi di pixel in base alle informazioni di movimento senza utilizzare modelli di codifica e decodifica addestrati. Il documento di brevetto afferma inoltre che queste tecnologie dovrebbero evitare di ridurre la qualità dell'immagine mantenendo una velocità di output dei fotogrammi fissa, ma non è ancora noto se i fotogrammi generati possano davvero ottenere effetti visivi simili al rendering nativo.
Gli esperti del settore ritengono che il test chiave di questa tecnologia sia se l'intelligenza artificiale sia in grado di generare con precisione le immagini previste a una velocità sufficientemente elevata e di riempire i posti vacanti sul display in modo tempestivo quando le prestazioni di rendering diminuiscono. Il brevetto mostra un'idea fattibile, ma il suo effetto reale deve ancora essere verificato da future dimostrazioni di prodotto o tecnologia.
Commenti