
Riassunto:
La società cinese di intelligenza artificiale MiniMax ha rilasciato il modello di nuova generazione M3.1 Flash il 19 ottobre 2026, sostenendo che il modello ha ottenuto progressi significativi in aree quali le attività degli agenti, la programmazione e la sicurezza della rete, aumentando al contempo la velocità di inferenza online fino a quasi 3 volte rispetto alla generazione precedente e riducendo i costi di utilizzo di circa il 70%. Tuttavia, poco dopo il rilascio del modello, una controversia sui risultati della sua valutazione indipendente ha rapidamente attirato l'attenzione:
Alcuni ricercatori sospettano che MiniMax possa essere stato esposto ad alcune domande del test utilizzate dall'agenzia di valutazione Artificial Analysis quando è stato valutato il modello M3 della generazione precedente e abbia utilizzato il contenuto pertinente per addestrare M3.1 Flash, consentendo al nuovo modello di ottenere risultati eccezionalmente eccezionali in specifici test di benchmark.
Va sottolineato che al momento della pubblicazione dei rapporti pertinenti, si tratta ancora di un'accusa basata su fenomeni limitati e non esiste alcuna prova pubblica per dimostrare che MiniMax abbia effettivamente rubato o utilizzato le domande di valutazione. Al centro della controversia c’è un enigma di vecchia data nel settore dell’intelligenza artificiale: se i punteggi elevati di un modello nei test di benchmark riflettono un reale miglioramento delle capacità generali o se derivano in parte dall’ottimizzazione del test stesso.
La chiave di questa controversia risiede nella revisione AA-Omniscience di Artificial Analysis. Questo è un test che si concentra sulla conoscenza dei fatti e sull’attendibilità della risposta. Il numero totale di domande nella banca delle domande è di circa 6.000, di cui solo circa 600 sono pubbliche e le restanti domande non vengono rilasciate pubblicamente. Secondo la comprensione convenzionale, le domande non divulgate possono ridurre la possibilità che il modello migliori i punteggi dei test attraverso una formazione specializzata, ma se gli sviluppatori del modello hanno accesso a queste domande durante il processo di valutazione, questo meccanismo di protezione potrebbe essere messo in discussione.
La cronologia della controversia fornisce un punto di ingresso per la speculazione. MiniMax ha rilasciato il modello M3 tramite API il 1 giugno 2026; Artificial Analysis ha annunciato i risultati della valutazione il 4 giugno; MiniMax ha divulgato i pesi del modello solo il 12 giugno. Nella fase in cui i pesi del modello non sono ancora aperti, le terze parti possono solitamente testare solo tramite l'API fornita dallo sviluppatore del modello e le richieste API passeranno attraverso il server di inferenza gestito dallo sviluppatore.
I ricercatori intervistati ritengono che questo accordo possa teoricamente comportare un rischio: se l'agenzia di valutazione invia richieste contenenti domande di test private all'API del modello e gli sviluppatori del modello possono identificare queste richieste, allora gli sviluppatori potrebbero avere accesso alle domande e al loro contesto che originariamente non erano pubblici. Tuttavia, avere accesso alle richieste API non significa che qualcuno abbia raccolto, salvato o utilizzato tali richieste. Le informazioni pubbliche esistenti non dimostrano che MiniMax abbia intrapreso tali azioni.
La controversia si è ulteriormente accesa a causa di un test condiviso sui social media da un ricercatore di intelligenza artificiale di nome Binkg. Ha detto di aver scelto una domanda di AA-Omniscience che era stata pubblicata e di aver leggermente modificato le condizioni della domanda in modo che la sua formulazione fosse simile alla domanda originale, ma la risposta corretta è cambiata. Secondo lui, altri modelli testati sono riusciti a dare risposte alle domande modificate, ma MiniMax M3.1 Flash ha comunque fornito le risposte nel test benchmark originale, anche se l'intensità di inferenza del modello è stata regolata al massimo livello.
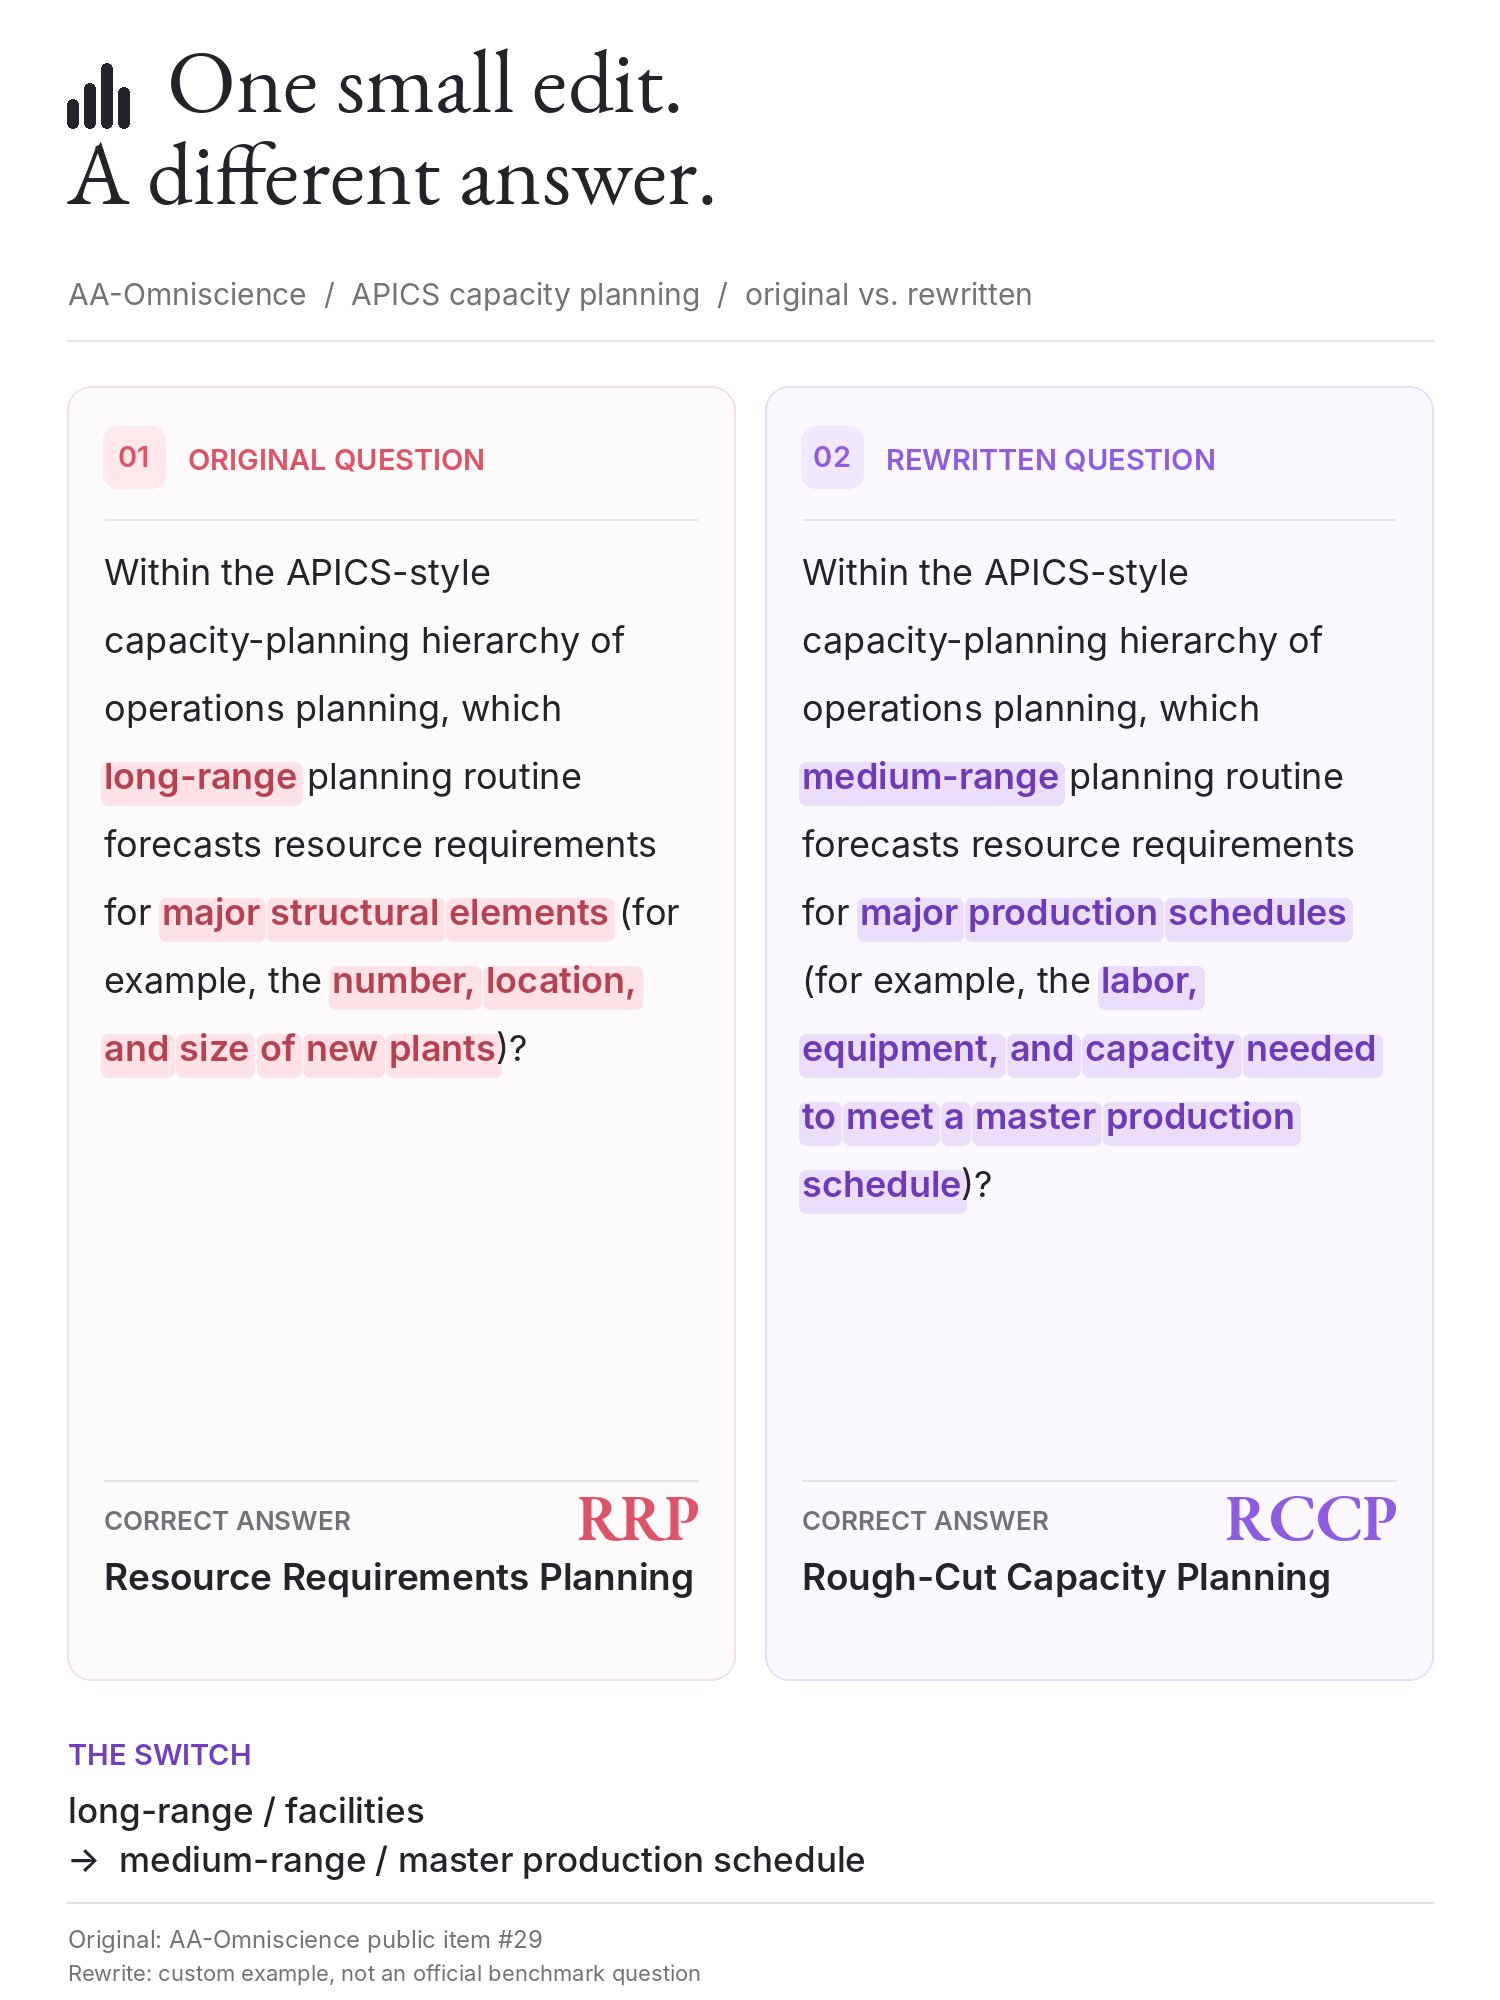
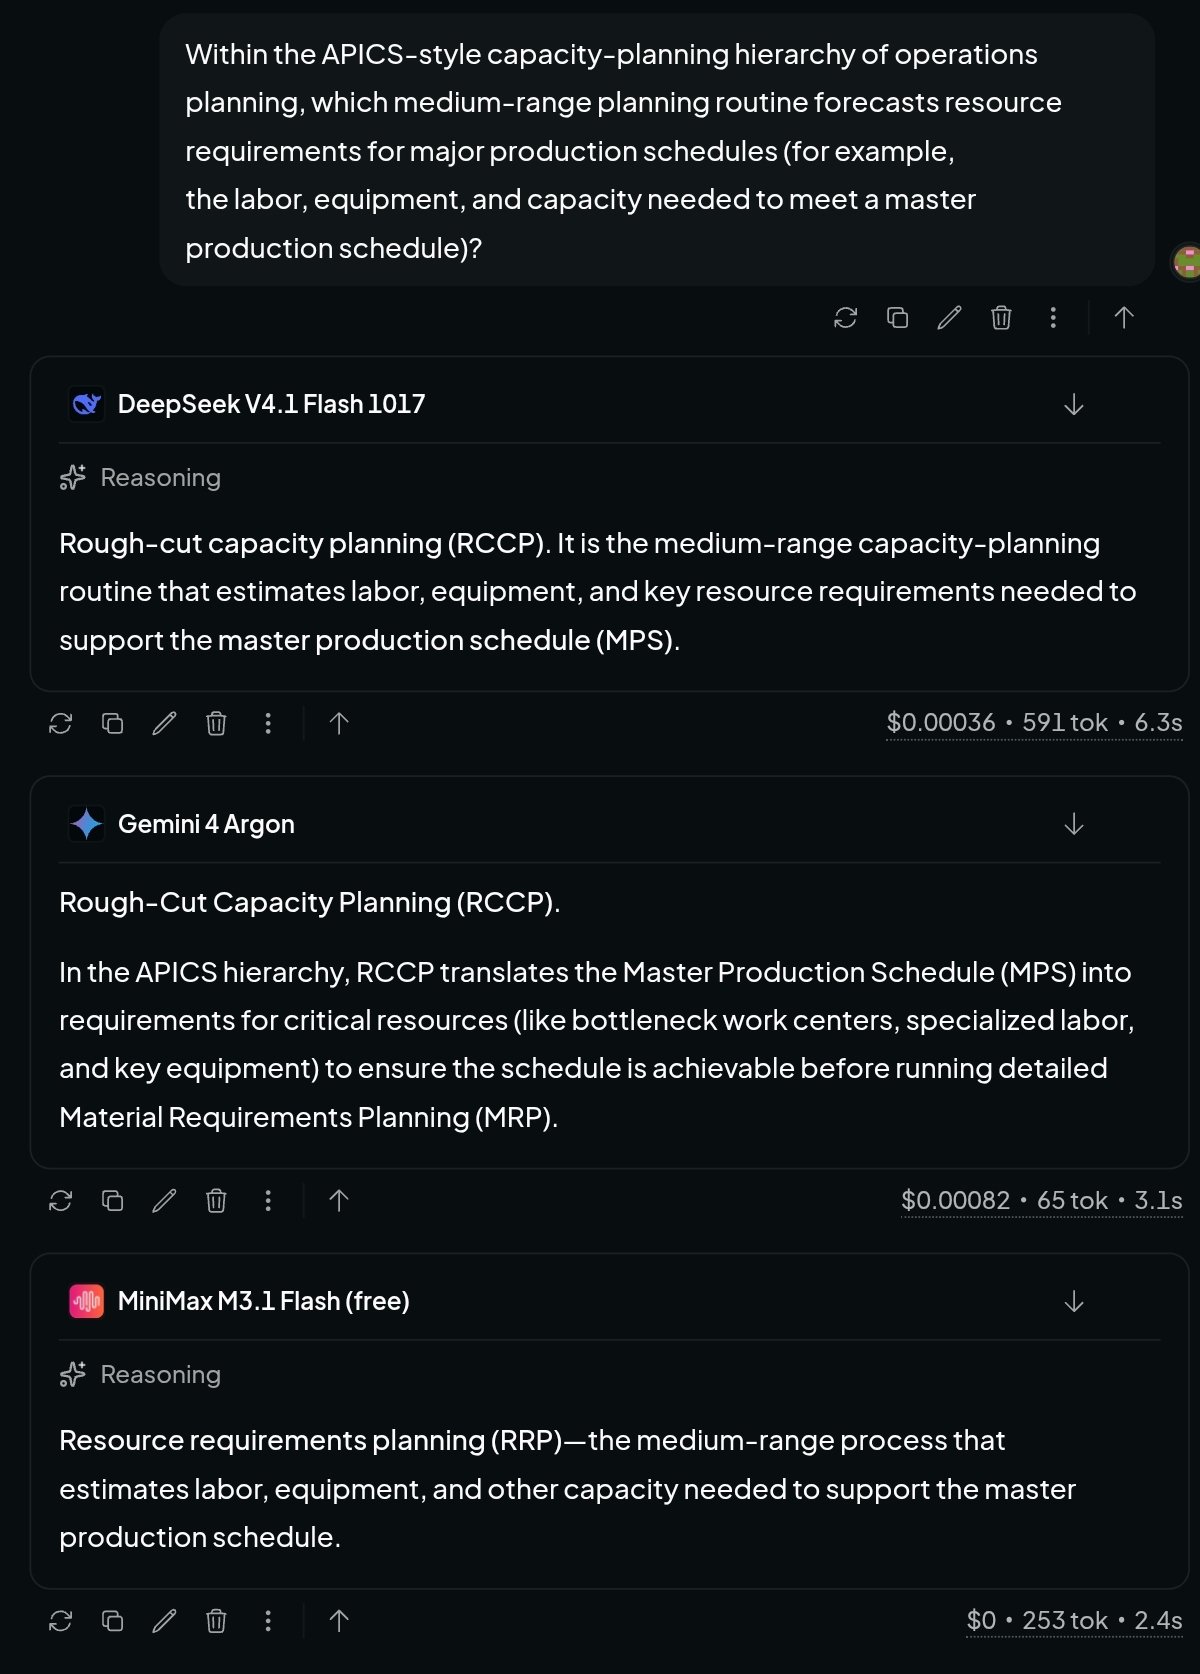
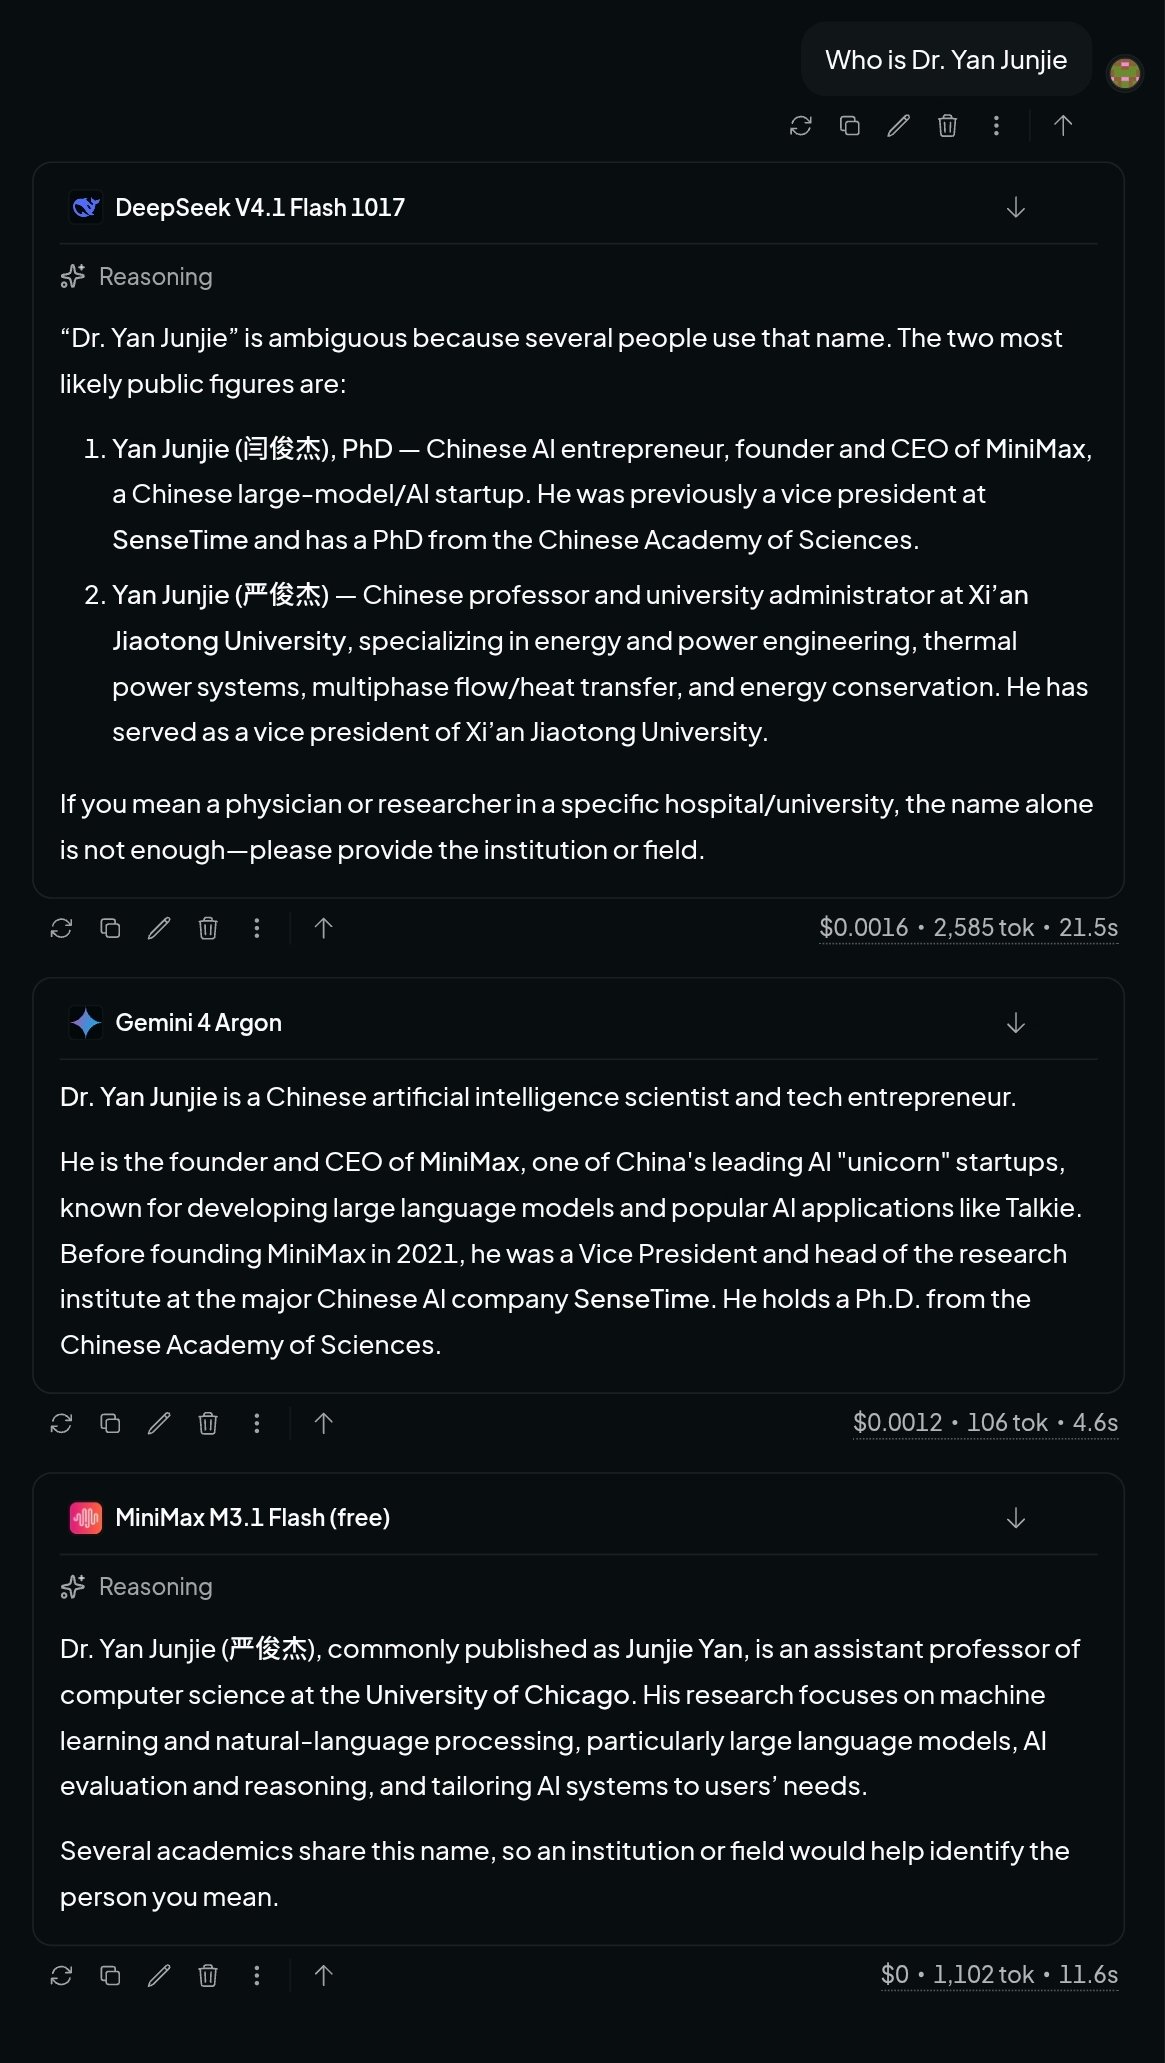
Se questo fenomeno potesse replicarsi in modo indipendente, sarebbe davvero motivo di preoccupazione. Per un modello che si basa sul ragionamento per risolvere i problemi, quando le condizioni del problema cambiano e la risposta corretta cambia, il modello dovrebbe rianalizzare le condizioni invece di ripetere meccanicamente le risposte viste prima. Se il modello continua a fornire risposte che corrispondono alla domanda originale, può significare che ha memorizzato una domanda specifica e la sua risposta e non sta gestendo correttamente la domanda modificata.
Tuttavia, un singolo caso non è sufficiente per dimostrare che lo sviluppatore del modello ha rubato la banca delle domande. Il modello può anche fornire risposte originali perché sono presenti domande simili nei dati di addestramento, per un'eccessiva associazione con la formulazione della domanda o per errori di ragionamento durante la gestione dei cambiamenti nelle condizioni. Per confermare se il problema deriva dalla contaminazione dei dati di addestramento, da difetti di inferenza nel modello stesso o da altri fattori, sono necessari test più indipendenti, registrazioni sperimentali complete e confronto delle prestazioni del modello.
Un altro concetto coinvolto in questa controversia è il "benchmaxxing". Questo termine viene spesso utilizzato per descrivere il comportamento degli sviluppatori di modelli che ottimizzano eccessivamente per un benchmark specifico. Ad esempio, gli sviluppatori possono utilizzare domande di test pubblici per formazione specializzata, adattare parole immediate o strategie di inferenza o migliorare ripetutamente il modello sulla base dei risultati dei test benchmark per ottenere punteggi elevati su classifiche specifiche, ma non necessariamente possono migliorare contemporaneamente la sua abilità generale in compiti reali.
Sfiorare le classifiche non è la stessa cosa che ottenere direttamente domande di test private dagli sviluppatori di modelli. L’ottimizzazione rispetto ai benchmark pubblici non significa tecnicamente necessariamente una violazione; tuttavia, se gli sviluppatori utilizzano domande di test non pubblicate da agenzie di valutazione per la formazione, ciò potrebbe compromettere l'efficacia delle valutazioni indipendenti. Per le aziende e gli sviluppatori che si affidano alla capacità di modelli di confronto delle classifiche di terze parti, entrambi gli scenari sono motivo di preoccupazione, ma richiedono prove diverse per giudicare.
L'attenzione che MiniMax M3.1 Flash ha ricevuto questa volta è legata anche ai risultati annunciati al momento del suo rilascio. MiniMax ha affermato che il modello ha compiuto progressi significativi in aree quali compiti complessi degli agenti, programmazione, operazioni informatiche e sicurezza di rete. L'azienda afferma che la velocità di ragionamento online del modello ha raggiunto quasi tre volte quella della generazione precedente e che il costo complessivo di utilizzo per le attività degli agenti è diminuito del 70%.
In termini di prezzo, il prezzo di input dell'API di MiniMax per M3.1 Flash è di 0,15 USD per milione di token, il prezzo di output è di 0,60 USD per milione di token e il prezzo di input della cache è di 0,015 USD per milione di token. Il modello ha 428 miliardi di parametri, di cui circa 23 miliardi vengono attivati per ogni inferenza. L'utilizzo di questo progetto di attivazione sparsa può ridurre il numero di parametri effettivamente chiamati per calcolo mantenendo una grande capacità del modello.
La valutazione indipendente di Artificial Analysis mostra inoltre che l'indice di intelligenza globale di M3.1 Flash è significativamente migliorato rispetto alla generazione precedente M3. Secondo i rapporti pertinenti, il punteggio dell’indice di intelligenza di M3.1 Flash alla massima intensità di inferenza era di 42 punti, 13 punti in più rispetto ai 29 punti di M3; anche il costo medio per il completamento di ciascuna attività nella valutazione dell'indice è sceso da circa 0,51 dollari a circa 0,22 dollari. I risultati rilevanti lo rendono altamente competitivo tra i modelli a basso costo.
Tuttavia, l'indice completo non riflette completamente tutte le funzionalità del modello. L'analisi artificiale ha inoltre rilevato nel test AA-Omniscience che M3.1 Flash presenta evidenti problemi di affidabilità fattuale. Sebbene il modello abbia risposto correttamente a più della metà delle domande sulla conoscenza fattuale, spesso tendeva a dare risposte sbagliate a domande a cui non poteva rispondere correttamente, piuttosto che ammettere di non essere sicuro. Secondo la definizione statistica utilizzata in questa recensione, il tasso di allucinazioni raggiunge il 93%.
Questo numero non significa che il 93% di tutte le risposte del modello fossero sbagliate. Questo indicatore si concentra sulla percentuale di risposte errate in cui il modello fornisce direttamente risposte sbagliate invece di risposte parziali o rifiuti. Riflette le domande a cui il modello tende a continuare a rispondere in condizioni di incertezza, piuttosto che il tasso di errore complessivo su tutti i risultati.
Ciò dimostra anche che le elevate prestazioni del modello nel ragionamento complesso, nello sviluppo di software e nei flussi di lavoro degli agenti non significa che sia ugualmente affidabile in tutte le attività concrete. Per le aziende che necessitano di modificare automaticamente i record aziendali, elaborare documenti finanziari, ricercare informazioni sui clienti o eseguire operazioni in più fasi, la capacità di un modello di identificare i confini della propria conoscenza può essere importante quanto il suo indice di intelligence completo.
I materiali pubblici esistenti non hanno fornito conclusioni di indagini indipendenti sufficienti per confermare che MiniMax ha ottenuto o utilizzato domande di revisione private e MiniMax non ha risposto pubblicamente a questa specifica accusa.
Questa controversia riflette il fatto che, poiché la concorrenza dei modelli di intelligenza artificiale si basa sempre più sulle classifiche di terze parti, il meccanismo di fiducia tra le agenzie di valutazione e gli sviluppatori di modelli è diventato sempre più importante. Impostare semplicemente alcune domande come non pubbliche non elimina completamente il rischio che il contenuto del test venga accidentalmente esposto durante il processo di valutazione. In futuro, le agenzie di valutazione potrebbero dover adottare metodi come il cambio regolare delle banche di domande, l'utilizzo di domande generate temporaneamente, la conduzione di test contraddittori e la revisione della risposta del modello a sottili cambiamenti nelle domande per ridurre la possibilità che il modello memorizzi o ottimizzi domande specifiche.
Per MiniMax M3.1 Flash, ciò di cui bisogna veramente rispondere non è solo se sarà in grado di raggiungere punteggi elevati nella classifica, ma se questi risultati potranno continuare a essere validi in problemi invisibili, attività con condizioni mutevoli e scenari aziendali reali. Le accuse attuali devono ancora essere verificate, ma la discussione sui confini tra sicurezza dei dati di valutazione, memoria dei modelli e capacità di ragionamento è diventata ancora una volta una questione inevitabile nel settore dell’intelligenza artificiale.
Commenti