Riassunto:
Lo sviluppatore Linux Osama Arif ha presentato due patch alla mailing list del kernel volte a ridurre la contesa delle richieste quando zswap carica le pagine di swap. Zswap è il meccanismo di compressione della cache di Linux. Comprime le pagine da scambiare e le memorizza temporaneamente nella memoria. Se le pagine possono essere lette dalla cache di compressione, l'accesso al dispositivo di scambio può essere ridotto, il che è particolarmente utile per alleviare la pressione I/O del disco quando la memoria è limitata.
Il problema è che il codice esistente fa sì che le scritture compresse e le letture compresse condividano richieste di compressione asincrone per CPU e blocchi mutex. Se un'attività di scrittura a bassa priorità viene anticipata durante il periodo di blocco, anche un'attività di lettura ad alta priorità potrebbe essere costretta ad attendere. La prima patch imposta richieste, oggetti wait e blocchi mutex rispettivamente per la compressione e la decompressione, in modo che la lettura non sia più bloccata dalle attività di scrittura; la seconda patch consente all'algoritmo di compressione software sincrono di utilizzare richieste on-stack per aggirare ulteriormente il blocco zswap. Gli algoritmi che richiedono l'elaborazione asincrona o un contesto di richiesta aggiuntivo utilizzano ancora richieste per CPU e blocchi mutex.
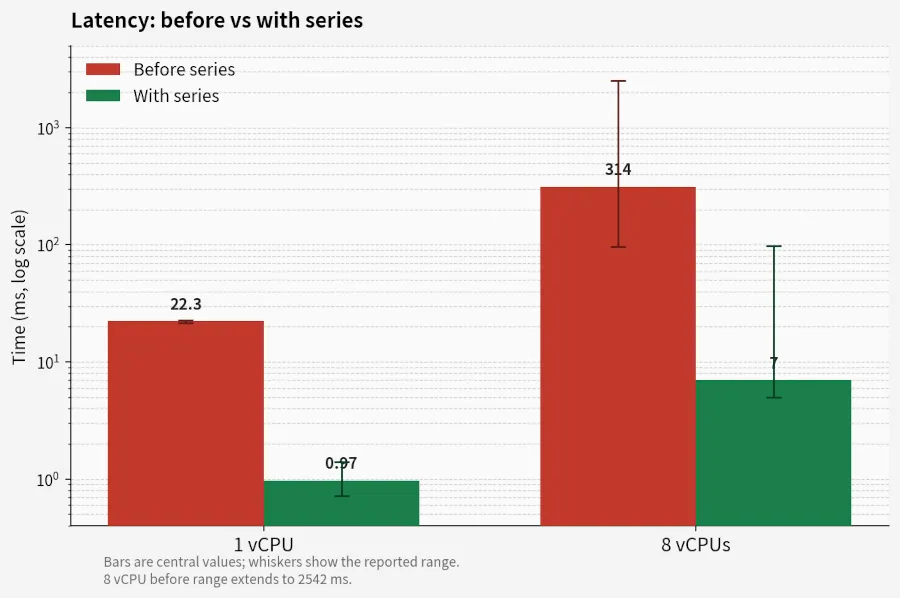
I test benchmark pubblicati dall'autore della patch mostrano che in un singolo ambiente CPU virtuale, la latenza media di lettura più lenta per round è scesa da 22,3 millisecondi a 0,97 millisecondi; in un ambiente con 8 CPU virtuali, è sceso da 314 millisecondi a 7 millisecondi. Ogni test è stato eseguito per 5 round, utilizzando il compressore zstd, la macchina virtuale e il disco di memoria come dispositivi di commutazione e creando carico tramite diverse attività prioritarie; anche il numero di letture superiori a 10 millisecondi è stato ridotto da 26 a 35 volte per round in un single core a zero, e in un ambiente multi-core è stato ridotto da 3 a 18 volte per round fino a un massimo di una volta. Gli autori affermano che benchmark e programmi di test sono scritti con l'aiuto di modelli linguistici di grandi dimensioni.
Questi numeri riflettono i miglioramenti della latenza di lettura in specifici stress test e non significano che tutti i dispositivi Linux o i carichi di lavoro giornalieri vedranno lo stesso aumento di velocità complessivo.
La patch è ancora nella fase di revisione della mailing list del kernel e non è stata ancora incorporata nel kernel principale:
https://lore.kernel.org/lkml/
[email protetta]
/
Commenti