Riassunto:
Un esperimento completato da uno sviluppatore mostra che collegare l'iPhone 17 Pro Max a un MacBook Pro dotato di chip M4 Pro tramite un software personalizzato può migliorare significativamente l'efficienza operativa del modello linguistico locale di grandi dimensioni. Quando si esegue il modello Qwen3.8-27B, le prestazioni di preriempimento del sistema migliorano fino al 44%.
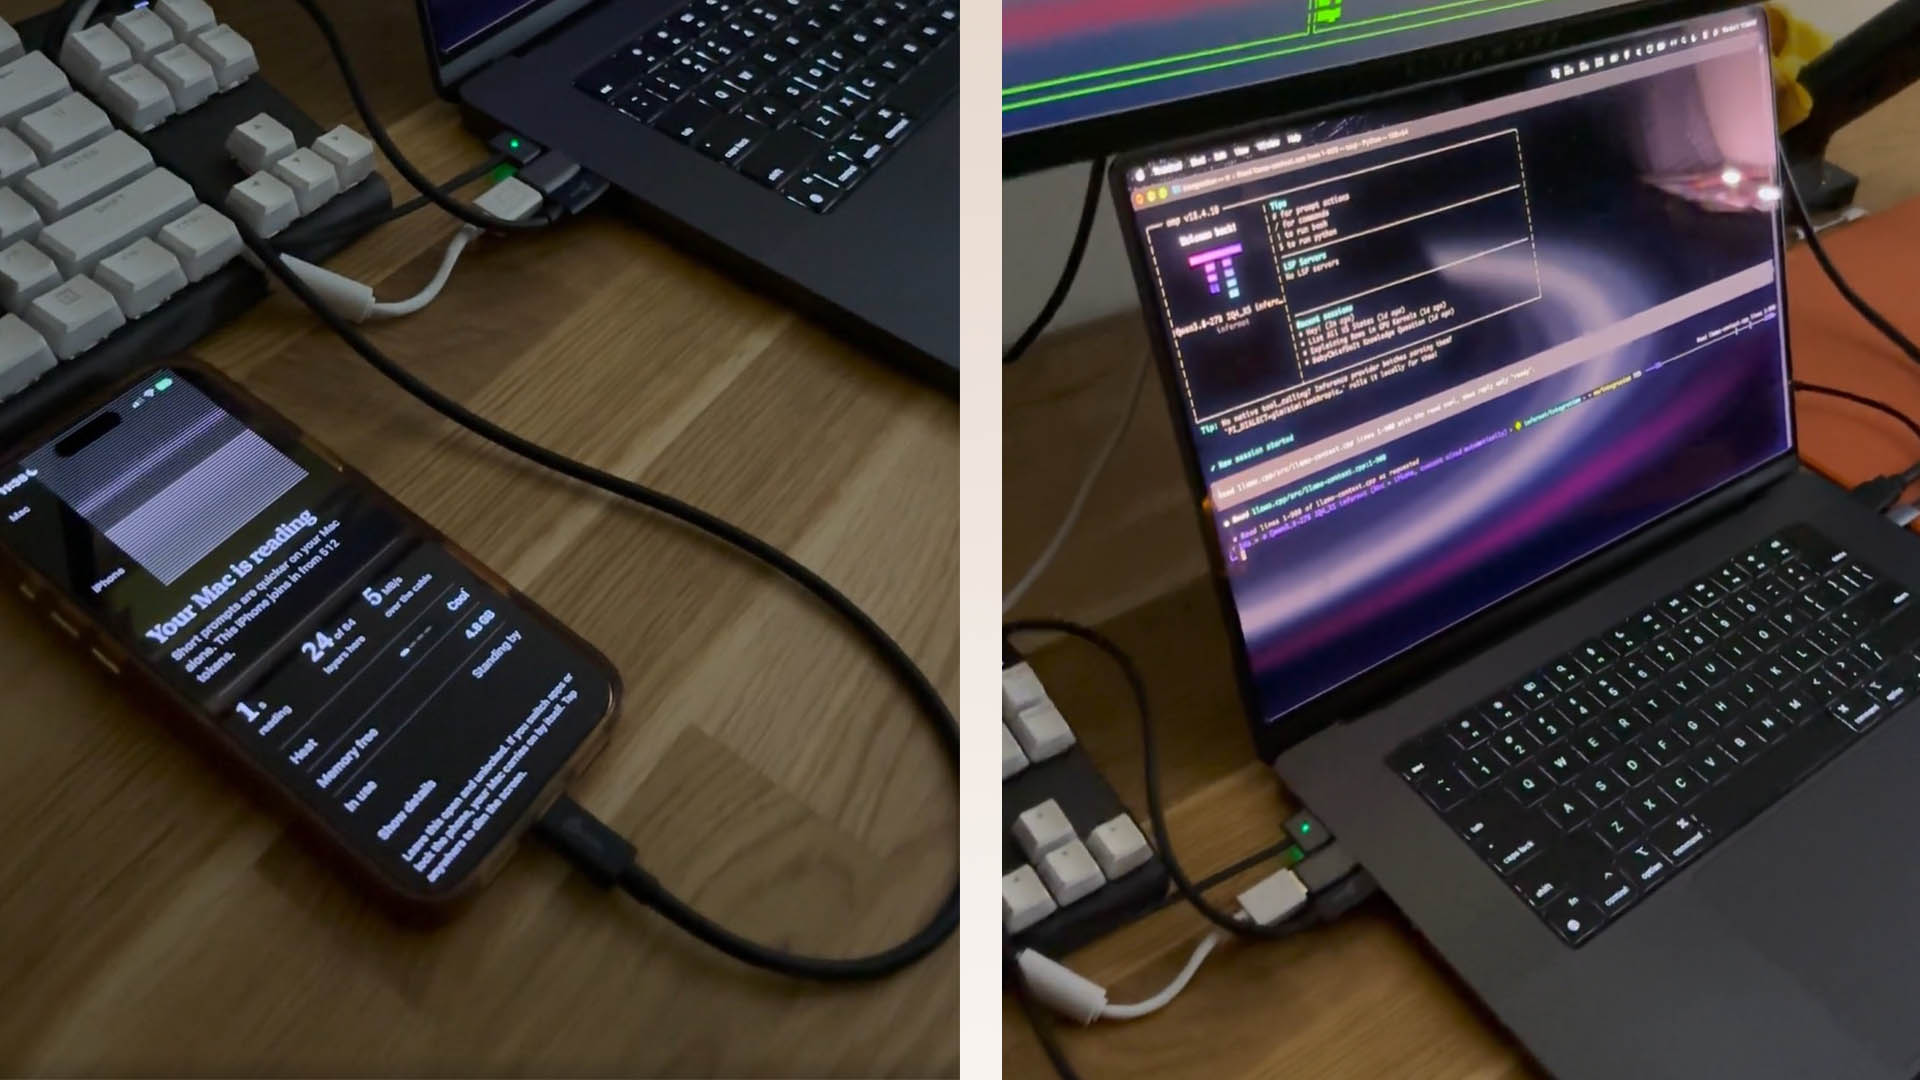
Il contesto di questo esperimento è che i modelli linguistici di grandi dimensioni hanno requisiti estremamente elevati in termini di memoria video e capacità di memoria del sistema. Sebbene il MacBook Pro dotato del chip M4 Pro disponga di 24 GB di memoria unificata, è ancora limitato dalla capacità di memoria e dalle dimensioni della finestra di contesto quando si esegue un modello di grandi dimensioni con 27 miliardi di livelli di parametri. Gli sviluppatori hanno quindi provato a utilizzare l'iPhone 17 Pro Max come nodo di elaborazione aggiuntivo per eseguire modelli insieme a MacBook Pro tramite l'interfaccia USB-C.
Secondo il piano annunciato dallo sviluppatore, il MacBook Pro è responsabile dell'elaborazione delle attività di elaborazione dal livello 1 al livello 40 in ogni batch di 256 token e trasmette i dati di attivazione intermedi all'iPhone in tempo reale. Successivamente, l’iPhone 17 Pro Max utilizza la GPU nel chip A19 Pro per continuare a eseguire operazioni dal livello 41 al livello 64, mentre il Mac inizia a elaborare contemporaneamente il successivo batch di dati. Attraverso questa divisione del lavoro in pipeline, due dispositivi possono partecipare contemporaneamente al processo di inferenza del modello.
I risultati sperimentali mostrano che, rispetto all'esecuzione del modello solo su MacBook Pro, la velocità di preriempimento è notevolmente migliorata dopo l'introduzione dell'iPhone. Nella finestra di contesto 8K, la velocità di elaborazione aumenta da 132 Token al secondo a 177 Token, con un aumento del 35%; nella finestra di contesto da 16K, le prestazioni aumentano da 109 Token al secondo a 157 Token, con un incremento del 44%; nello scenario della finestra di contesto da 32K, la velocità di elaborazione aumenta da 101 Token al secondo a 130 Token, con un aumento di circa il 29%.
Oltre al calcolo collaborativo della GPU, anche il motore di rete neurale nel chip A19 Pro partecipa ad alcune attività. Gli sviluppatori hanno affermato che ogni contesto storico di 16K verrà convertito in un modello di rete neurale dedicato per l'elaborazione. Alla scala di contesto di 140.000 Token, il tempo di scrittura di un singolo Token viene ridotto da 279 millisecondi quando si fa affidamento solo sulla GPU a 176 millisecondi, migliorando ulteriormente l'efficienza operativa in scenari con contesto lungo.
Tuttavia, questa soluzione non è priva di limitazioni. Gli sviluppatori hanno sottolineato che l'iPhone aiuta principalmente a migliorare le prestazioni della fase di precompilazione, mentre nelle attività di generazione di testo inferiori a 64K, la maggior parte del lavoro di ragionamento effettivo viene ancora svolto principalmente dal Mac. Inoltre, questa soluzione richiede un supporto software appositamente sviluppato e attualmente non è adatta per l'implementazione diretta da parte degli utenti ordinari.
Tuttavia, questo esperimento dimostra il potenziale dei dispositivi Apple di livello consumer per l'elaborazione IA locale. Poiché le prestazioni dei chip mobili continuano a migliorare, in futuro potrebbe formarsi un sistema informatico collaborativo più flessibile tra smartphone, tablet e personal computer, riducendo così la dipendenza dalla configurazione hardware di un singolo dispositivo per eseguire grandi modelli di intelligenza artificiale.
Commenti