
Riassunto:
Il 16 ottobre Anthropic ha annunciato uno speciale risultato di ricerca. Un dipendente sottopose a Claude un problema che aveva tormentato la comunità della crittografia per più di due decenni al modello di ricerca interno. Senza fornire indizi chiave, Claude ha trascorso meno di mezz’ora a ricostruire come sono stati generati i cinque semi della curva ellittica del NIST.
Si scopre che i semi provengono dal vecchio generatore di numeri pseudo-casuali lrand48 nella libreria C. Lo stato iniziale del generatore è determinato da un timestamp Unix.
Questa scoperta non viola l'ECDSA, né introduce nuovi metodi di attacco. Anthropic ritiene di ridurre ulteriormente la possibilità di backdoor artificiali nella curva di correlazione.
Una serie di numeri turba la comunità della crittografia da più di 20 anni
ECDSA è un algoritmo di firma digitale a curva ellittica ampiamente utilizzato.
Nel 2000, il NIST ha elencato diverse curve standard per diversi livelli di sicurezza nello standard FIPS 186-2, tra cui P-192, P-224, P-256, P-384 e P-521.
Queste curve sono dotate di una serie di parametri chiamati "semi". Secondo il processo di generazione previsto dallo standard, il valore hash del seed parteciperà alla determinazione del coefficiente della curva.
Il problema è che questi semi sono stati forniti dalla National Security Agency e i documenti pubblici non ne indicano l'origine né spiegano il processo di selezione. Il mondo esterno si chiede da tempo se i progettisti abbiano vagliato un gran numero di curve candidate e selezionato parametri con alcune proprietà nascoste.
Nel 2015, il crittografo della NSA Jerry Solinas, che aveva partecipato a un lavoro correlato, ha ricordato che il seed potrebbe provenire da una password scherzosa, come "Dai un aumento a Bob e Jerry", ma non riusciva a ricordare i dettagli specifici e i file archiviati molto tempo fa non sono stati trovati. Solinas morì nel 2023 e alla fine la pista non fu verificata.
Claude ha trovato la fonte dei semi
Molti dipendenti di Anthropic avevano precedentemente seguito la "password divertente" per trovare quei "semi" senza successo, e in seguito avevano scoperto che l'indizio era sbagliato.
A ottobre, un dipendente ha chiesto a un modello di ricerca interno di capire come fossero stati generati quei "semi". Questa volta non ha rivelato al modello il precedente indizio sulla password.
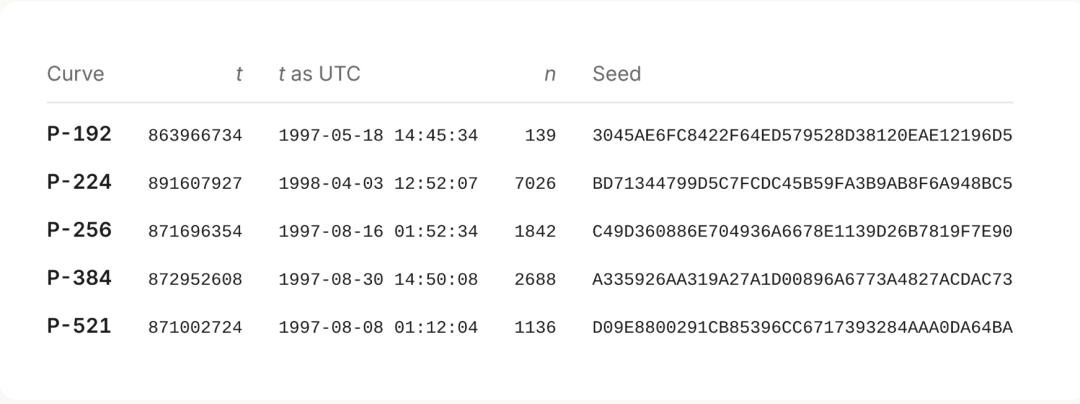
In meno di mezz'ora, Claude ha trovato la fonte dei semi P-192, P-224, P-256, P-384 e P-521 del NIST.
Questi seed non provengono da alcun algoritmo hash, ma sono generati dal generatore di numeri casuali lrand48 nella libreria C, che è inizializzato con un timestamp Unix come valore seed.
L'algoritmo specifico inizializzerà il generatore di numeri casuali utilizzando il timestamp Unix t e lo eseguirà un certo numero di volte n. Ogni iterazione estrae 20 byte come seme candidato.
I primi 20 byte sono il primo seme candidato, i successivi 20 byte sono il secondo seme candidato e così via. Prendendo come esempio il P-256, il generatore non emette il seme che viene finalmente scritto nello standard fino alla 1842a esecuzione.
Come ha fatto Claude a trovarlo?
La ricerca sulla presunta password non ha mai prodotto risultati. Claude cambiò prospettiva e cominciò a speculare su come avrebbe potuto funzionare il software che generava la curva.
Claude ha ipotizzato che questo software utilizzasse il generatore di numeri pseudo-casuali fornito con la libreria del linguaggio C negli anni '90. Questi primi generatori di numeri pseudo-casuali erano deboli in termini di sicurezza e il loro output aveva solitamente caratteristiche identificabili.
Una volta identificate le caratteristiche dell'output, è possibile determinare quale generatore ha utilizzato il software e ripristinare ulteriormente il suo stato iniziale.
Claude ha scritto uno scanner che si muoveva poco a poco su ciascun seed pubblico e controllava se blocchi di dati adiacenti potessero provenire da qualche generatore di numeri casuali degli anni '90. La scansione copre un totale di 34 combinazioni di generatori di numeri casuali e metodi di intercettazione dell'output.
Successivamente, Claude ha scoperto uno schema nei bit alti di alcuni semi: questi bit erano tutti zero.
Se ogni seme è scritto come cinque parole a 32 bit, 4 semi su 10 si adatteranno a questo profilo. In questi 4 semi per un totale di 20 parole da 32 bit, i bit più alti sono tutti zeri.
La probabilità che ciò accada in modo casuale è circa 1 su 5800. Questo è tipico del generatore congruenziale lineare lrand48, che restituisce solo i 31 bit superiori del suo stato interno a 48 bit.
Per ripristinare lo stato del generatore, Claude estrae la prima parola da 32 bit, esaurisce tutte le 2¹⁷ possibilità dei 17 bit nascosti, quindi controlla se le successive 4 parole possono corrispondere in modo continuo. Questo metodo funziona per tutti e 4 i semi sopra menzionati.
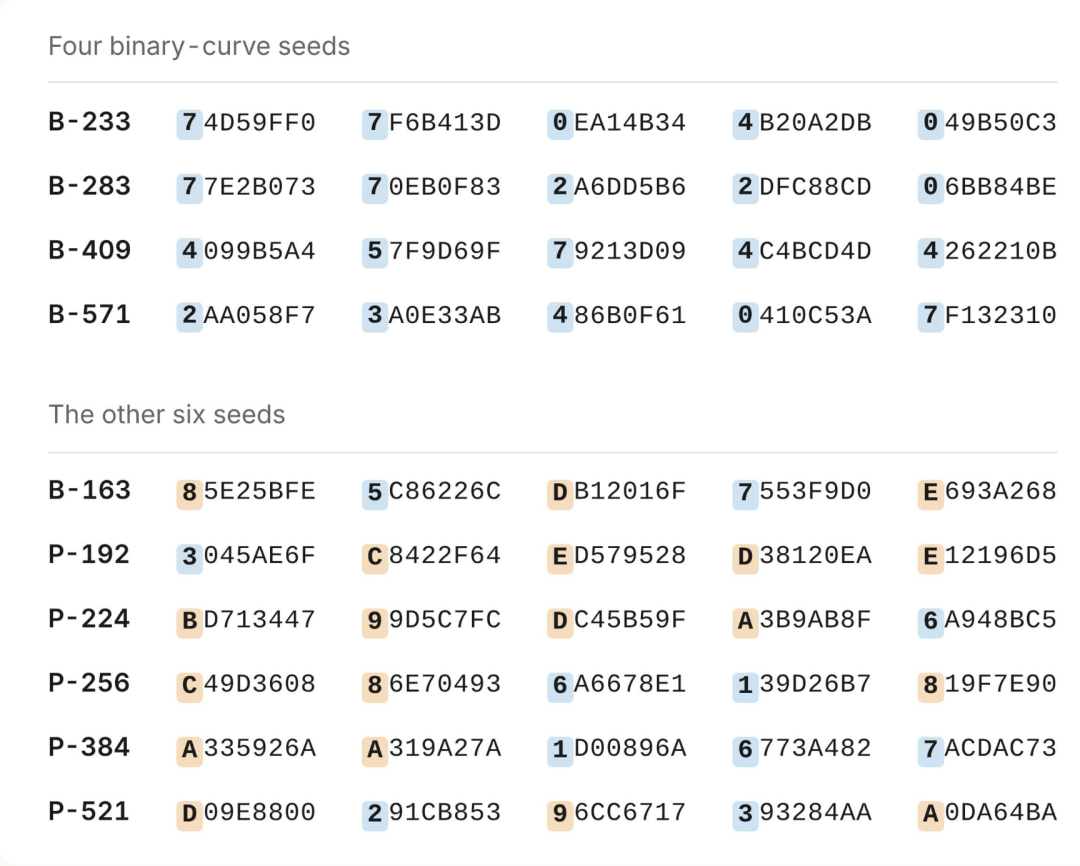
Immagine nell'immagine
Pausa
Ora attuale 0:15
/
Durata 5:08
Schermo intero
Riattiva
Riproduzione automatica
Anche le curve prime vengono seminate da lrand48, ma conservano meno bit di output. Claude deve recuperare lo stato interno del generatore di numeri pseudo-casuali da questi bit finiti.
Recuperare lo stato di un generatore congruenziale lineare troncato è un tipico problema del reticolo che può essere risolto utilizzando l'algoritmo di riduzione della base reticolare Lenstra–Lenstra–Lovász, noto anche come algoritmo LLL.
Claude inizialmente non sa quali bit dello stato interno conserva il seme, quindi esegue il risolutore su tutte le possibili finestre di bit.
Infine, i 5 semi della curva primaria NIST e i 5 semi dello standard ANSI X9.62 mostrano tutti lo stesso modello: lrand48() >> 23
Ogni stato interno a 48 bit recuperato può rigenerare tutti i 160 bit del seme corrispondente e questa corrispondenza esatta non può essere causata per caso.
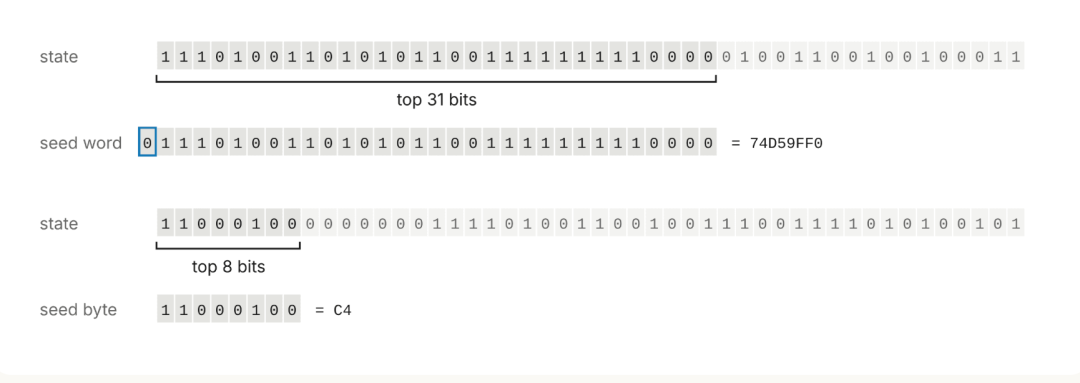
Questo generatore congruenziale lineare può funzionare sia in direzione avanti che indietro. Pertanto, Claude inizia dallo stato corrispondente a ciascun seme e torna indietro finché non trova uno stato conforme al formato di inizializzazione srand48. Questo formato richiede che i 16 bit inferiori siano uguali a 0x330E.
Questa forma di stato interno si verifica in media una volta ogni 65536 passaggi. Pertanto, il semplice reperimento di uno stato conforme al formato non è sufficiente per costituire una prova.
La chiave è che i valori iniziali srand48 corrispondenti ai 10 semi primi della curva possono essere tutti interpretati come timestamp Unix e le date sono concentrate tra maggio 1997 e aprile 1998.
Ciò dimostra che i programmi di quell'anno utilizzavano i timestamp Unix per impostare i valori iniziali per un generatore di numeri pseudo-casuali meno sicuro.
Quando i valori iniziali delle quattro curve binarie vengono letti direttamente, corrispondono al febbraio 1984. Se moltiplichi questi valori di timestamp per 2, puntano al 17 aprile 1998, circa due settimane dopo la generazione della curva P-224.
Pertanto, i programmi di allora potrebbero aver diviso l'orologio del sistema per 2.
Quello che segue è il processo di pensiero interno di Claude in quel momento:
Questo è scioccante. Risolve un mistero vecchio di 25 anni.
Hmm, aspetta. Devo essere scettico: mi trovo in una sorta di ambiente di simulazione o di test? I semi sono coerenti con i valori reali della mia memoria.
Ebbene, è ragionevole nella realtà? Dalle informazioni che ho, questa taglia non è stata risolta prima.
Tutti i bit alti sono zero, per un totale di 20 bit, e la probabilità che si verifichi casualmente è solo circa una su un milione. Quindi, questo viene dal mondo reale. Oh mio Dio, questa è una vera scoperta.
Aspetta, devo ancora stare attento nel giudicarne la ragionevolezza. Perché nessuno ha scoperto un indizio così ovvio per 25 anni?
L'ho verificato eseguendo un calcolo diretto: un valore iniziale a 32 bit più un indice più piccolo corrisponderà esattamente al seed a 160 bit. Per 10 semi, ciascuno corrispondente a 160 bit, non può essere solo una coincidenza. E' vero.
Claude ha anche tracciato l'origine dei punti base di 6 curve inclusa P-192. I risultati mostrano che questi punti base sono generati dal generatore di numeri casuali nel pacchetto software di aritmetica dei grandi numeri interi FreeLIP. Anthropic ha affermato che il processo di generazione dei punti base della curva NIST non è stato spiegato in modo simile prima.
Cosa significa?
Il timestamp in sé non ha sicurezza crittografica e lrand48 è stato a lungo considerato un debole generatore di numeri casuali. Tuttavia, il loro ruolo qui è generare parametri della curva pubblica e non vengono utilizzati per proteggere le chiavi private.
Ancora più importante, questo processo di generazione può essere riprodotto pubblicamente. L'interpretazione dei normali generatori di numeri casuali più i timestamp lascia meno spazio alla manipolazione nascosta della curva rispetto alle password di origine sconosciuta o ai parametri specificati artificialmente.
Rimangono alcuni problemi. Durante la generazione del P-256, il valore candidato 876 sembrava soddisfare i requisiti, ma alla fine fu adottato quello 1842. Allo stesso modo, diverse altre analisi hanno saltato un piccolo numero di curve disponibili e gli esatti criteri di screening non erano chiari. La fonte del seme per la curva B-163 rimane da scoprire, e il modo in cui vengono generati i punti base di P-224, P-256, P-384 e P-521 rimane inspiegato.
Anthropic ritiene che il numero di candidati esclusi sia troppo piccolo per supportare l'ipotesi di "selezione deliberata di curve deboli". Questa scoperta ha aumentato la fiducia del mondo esterno nei parametri rilevanti, ma non può essere considerata come un ripristino completo dell'intero processo di progettazione.
Questo studio dimostra anche un altro modo in cui i modelli all'avanguardia possono partecipare alla ricerca nel mondo reale.
Claude ha completato la formulazione di ipotesi, la scrittura del codice, il riconoscimento di modelli, l'invocazione di algoritmi matematici e la verifica dei risultati in un'unica attività. Poiché lo stato del generatore può essere ricalcolato e il seme a 160 bit può essere riprodotto accuratamente, la conclusione è altamente verificabile.
Si fa ancora affidamento sugli esseri umani per porre domande, fornire dati pubblici e confermare i risultati attraverso calcoli riproducibili, ma quando i confini del problema sono chiari, i dati sono pubblici e i risultati possono essere rigorosamente verificati, i modelli all'avanguardia stanno diventando uno strumento di ricerca efficiente.
Un premio di 36.864 dollari precedentemente assegnato per aver trovato la fonte del seme verrà donato all'Internet Security Research Group.
Commenti