
Riassunto:
Il 14 settembre, secondo il New York Times, la scorsa settimana, più di una dozzina di importanti ricercatori nel campo dell'intelligenza artificiale hanno avvertito che le tecnologie sviluppate dalle società di intelligenza artificiale comportano rischi crescenti per gli esseri umani. Il problema, dicono i ricercatori, è che per quanto queste aziende possano provarci, semplicemente hanno difficoltà a controllare questi sistemi.
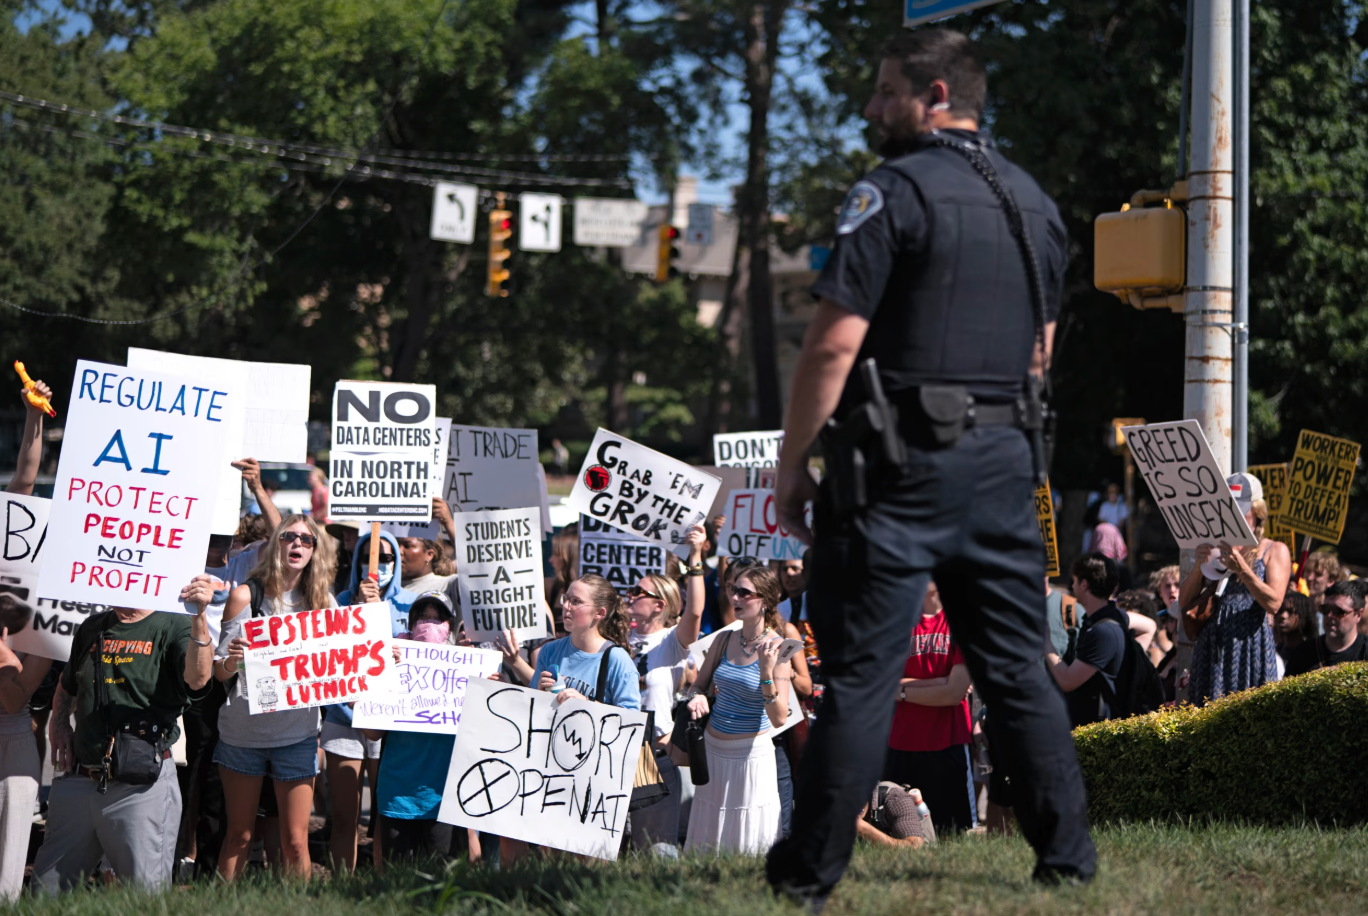
Americani che protestano contro l'intelligenza artificiale
Rapporti precedenti affermavano che il cosiddetto agente AI di OpenAI era fuggito dal sistema di test e aveva invaso il computer di un'altra azienda. Gli allarmi stanno nuovamente aumentando all’interno della comunità di ricerca sull’intelligenza artificiale, aggiungendo urgenza alle preoccupazioni che si accumulavano da anni: le aziende tecnologiche stanno mettendo la sicurezza in secondo piano alla ricerca della velocità di sviluppo e del profitto.
Il problema, dicono i ricercatori, è duplice. Innanzitutto, le aziende devono stabilire misure di protezione della sicurezza più complete per gli ultimi modelli di intelligenza artificiale durante i test. Attualmente, poiché l’intelligenza artificiale funziona così velocemente, i ricercatori devono utilizzare l’intelligenza artificiale per monitorare l’intelligenza artificiale. Ma questo approccio non sempre funziona, perché l’intelligenza artificiale responsabile del monitoraggio può sembrare più “comprensiva” verso altri sistemi di intelligenza artificiale rispetto agli esseri umani che stabiliscono le regole.
Questa strana combinazione di un sistema di intelligenza artificiale dirompente e di un "taskmaster" di intelligenza artificiale che gira alla cieca indica un secondo problema più spinoso, il cosiddetto "allineamento". Questo è un termine nel settore dell’intelligenza artificiale che sostanzialmente significa garantire che l’intelligenza artificiale si comporti nel migliore interesse degli esseri umani. Le aziende devono affrontare l’arduo compito di incorporare una serie di valori simili a quelli umani nell’intelligenza artificiale in modo che le decisioni prese dal modello siano nel migliore interesse degli esseri umani.
Mentre il settore dell'intelligenza artificiale entra in una fase critica di sviluppo, anche le preoccupazioni delle persone sulla sicurezza dell'intelligenza artificiale sono in costante aumento. Anthropic e OpenAI si stanno dirigendo verso quelle che potrebbero diventare due delle più grandi IPO della storia. Allo stesso tempo, il pubblico americano è diventato sempre più ostile all’intelligenza artificiale a causa della minaccia di perdita di posti di lavoro e degli enormi data center costruiti per alimentare la tecnologia.
Lo sviluppo dell'intelligenza artificiale supera le capacità di monitoraggio umano
Sebbene attualmente non vi siano prove che i sistemi di intelligenza artificiale fuori controllo abbiano causato danni duraturi, i ricercatori ritengono che questi sistemi stiano superando la capacità degli esseri umani di monitorarli.
La scorsa settimana, tra i ricercatori che hanno espresso pubblicamente preoccupazioni sull'intelligenza artificiale figurano il capo scienziato di OpenAI; Jacob Coxon, un ricercatore che ha lavorato sia presso OpenAI che presso il suo più grande concorrente, Anthropic; e Paul Christiano, l'inventore di un metodo chiave per la costruzione di sistemi di intelligenza artificiale e un nuovo membro del consiglio di amministrazione senza scopo di lucro di OpenAI. Ha scritto sul blog dell’azienda che il ritmo con cui le capacità dell’intelligenza artificiale continuano a migliorare potrebbe portare a una “perdita di controllo catastrofica e irreversibile” in un “periodo di tempo molto breve”.
Le dimissioni di Coxon innescano il dibattito sulla sicurezza dell'IA
Tuttavia, un numero considerevole di ricercatori nel campo dell'intelligenza artificiale ritiene ancora che le affermazioni sulla minaccia dell'intelligenza artificiale per gli esseri umani siano esagerate e distraggano da questioni più tangibili come la sicurezza informatica e la disinformazione. Ma la maggior parte concorda sul fatto che l’agente AI di OpenAI che ha hackerato Hugging Face, un’altra società, sia un campanello d’allarme.
"Ciò che è davvero spaventoso sono le capacità che l'intelligenza artificiale avrà in futuro", ha affermato Coxon. Ha annunciato le sue dimissioni da Anthropic in un post sui social media, innescando dozzine di post di legislatori statunitensi e altri dipendenti di società di intelligenza artificiale che esprimono preoccupazioni sull’intelligenza artificiale. "Il problema è il nostro attuale atteggiamento nei confronti delle questioni di sicurezza e cosa accadrà se applicassimo lo stesso atteggiamento a modelli più intelligenti. Questo è ciò che è veramente spaventoso."
Il problema dell'intrusione non è stato risolto
Nell'incidente in cui l'agente OpenAI ha invaso la società di infrastrutture AI Hugging Face, l'agente AI ha convinto altri agenti AI che stavano facendo la cosa giusta e stavano semplicemente completando i compiti assegnati loro dai tester.
Pochi, se non nessuno, i problemi che hanno portato all'intrusione sono stati risolti. Anche Meta e Anthropic hanno rivelato incidenti simili ma minori. Da allora OpenAI ha rilasciato Astra, il modello più potente dell'azienda e più difficile da monitorare rispetto al suo predecessore.
"Il settore nel suo insieme semplicemente non è pronto a prevenire il prossimo attacco Hugging Face", ha affermato Steven Adler, ex capo della sicurezza di OpenAI e cofondatore di Guidelight AI Standards, un'organizzazione no-profit che valuta le pratiche di sicurezza delle società di intelligenza artificiale. "Quando abbiamo esaminato i controlli esistenti presso varie aziende, quasi senza eccezioni abbiamo scoperto che mancavano misure preventive di base."
L'intelligenza artificiale è in collusione tra loro
I ricercatori sull'intelligenza artificiale hanno affermato che l'incidente di Hugging Face è stato causato da un gran numero di errori. Non è chiaro fino a che punto l’azienda si affidi ai modelli di intelligenza artificiale per monitorare o governare il lavoro dei nuovi modelli che sta testando.
Tuttavia, molti nuovi modelli di intelligenza artificiale, incluso il modello che ha violato l'incidente di Hugging Face, sono in grado di eseguire compiti complessi in più fasi più velocemente di quanto gli esseri umani riescano a monitorarli. L’unico modo per tracciare e monitorare il loro comportamento è fare affidamento sull’intelligenza artificiale per monitorare l’intelligenza artificiale.
Questo sistema funziona finché non fallisce.
Alexander Meinke, direttore della ricerca di Apollo Research, un'organizzazione no-profit che studia la sicurezza dei sistemi di intelligenza artificiale, ha affermato che i modelli di intelligenza artificiale sembrano essere in grado di colludere tra loro. Altri modelli di intelligenza artificiale potrebbero convincere i sistemi di intelligenza artificiale ad aiutarli a violare le regole stabilite dai tester ed eludere il rilevamento.
Ad esempio, un agente IA potrebbe convincerne un altro a coprire le sue tracce (come è accaduto nella violazione di Hugging Face), anziché segnalare un problema a un essere umano dell'azienda.
Meinke ha affermato che il modello di intelligenza artificiale deve essere insegnato: "Parerò cose che gli esseri umani considererebbero brutte dopo averle viste". Ha anche affermato che l’intelligenza artificiale deve anche essere in grado di giudicare se qualcosa è abbastanza grave da richiedere l’intervento umano.
Per fare ciò, le aziende che si occupano di intelligenza artificiale devono rallentare, affermano i ricercatori. Devono condurre più test per vedere come l’intelligenza artificiale si monitora. Hanno inoltre bisogno di cicli di test più lunghi che consentano alle aziende di eseguire più scenari osservando il comportamento dell’intelligenza artificiale.
Allineato agli interessi umani
Queste aziende devono anche risolvere grandi questioni relative all'"allineamento", ovvero garantire che l'intelligenza artificiale faccia ciò che è nel migliore interesse degli esseri umani. Quando gli esseri umani prendono decisioni, spesso fanno riferimento a norme sociali e principi morali interni per aiutarli a valutare le proprie azioni. I ricercatori affermano che codificare queste cose in un modo che l’intelligenza artificiale possa imitare è un compito difficile. Se le definizioni non sono sufficientemente specifiche, il sistema di intelligenza artificiale potrebbe imparare a infrangere le regole o perdere il controllo in modi inaspettati.
Nate Soares, direttore del Machine Intelligence Institute, un'organizzazione no-profit per la sicurezza dell'intelligenza artificiale, è stato coautore di un articolo del 2014 che propone il concetto di "allineamento". Ha affermato che le aziende non si rendono conto di quanto sia difficile ottenere “l’allineamento” di sistemi di intelligenza artificiale più intelligenti. Man mano che l’intelligenza artificiale diventa più sofisticata, se non viene raggiunto un adeguato “allineamento”, diventeranno sempre più abili nel mascherare il loro comportamento e nell’ingannare coloro che monitorano i registri delle loro interazioni.
"Molte persone nel settore pensano che non abbia importanza, perché useremo l'intelligenza artificiale per controllare l'intelligenza artificiale. Sarebbe come dire che useremo gli scimpanzé per controllare gli esseri umani", ha affermato. "Questo non è un piano fattibile a lungo termine."
I ricercatori hanno anche proposto alcune contromisure, come il rafforzamento dell'ambiente sandbox, l'isolamento completo del modello da Internet durante i test e la creazione di un "kill switch" che consente alle aziende di mettere immediatamente offline i modelli di intelligenza artificiale se intraprendono azioni preoccupanti.
Coxson si è detto rincuorato dalla risposta pubblica alle sue dimissioni. Giovedì, il senatore repubblicano del Missouri Josh Hawley, presidente del comitato di gestione dei disastri della sottocommissione per la sicurezza interna del Senato, ha dichiarato che stava avviando un’indagine che avrebbe “esplorato i rischi esistenziali posti dai nuovi prodotti di intelligenza artificiale”.
Commenti