
Riassunto:
Sapevi che, anche rispetto alle epidemie, al clima, alle guerre e alle minacce nucleari, ciò che più probabilmente distruggerà l'umanità prima del 2100 è l'intelligenza artificiale? Questa sorprendente conclusione arriva dall’autorevole rapporto di The Lancet. The Lancet ha scritto nel rapporto del comitato "Minacce sanitarie globali nel 21° secolo", pubblicato l'11 ottobre, che tra le 17 minacce, tra cui il cambiamento climatico, le epidemie e l'inquinamento, i conflitti nucleari e l'uso dannoso dell'intelligenza artificiale sono al primo posto e potrebbero portare all'estinzione umana prima del 2100.
Questo rapporto è stato scritto da 35 massimi esperti e l'intero studio ha coperto 204 paesi e regioni di tutto il mondo. Il rapporto ricorda inoltre che queste minacce possono interagire e amplificarsi a vicenda.
La parte più agghiacciante del rapporto è che, anche se l'intelligenza artificiale e il conflitto nucleare sono entrambi i principali problemi nella distruzione dell'umanità, il danno causato dall'intelligenza artificiale supera di gran lunga quello del conflitto nucleare.
Se Amoudi dicesse questo riguardo alla fine dell'intelligenza artificiale, forse lo ascolterei solo per divertimento. Dopotutto ci sono già così tante parole simili che mi stanno quasi diventando callose le orecchie.
Ma questa volta è stato detto da The Lancet e ho avuto davvero paura.
Cosa dice The Lancet?
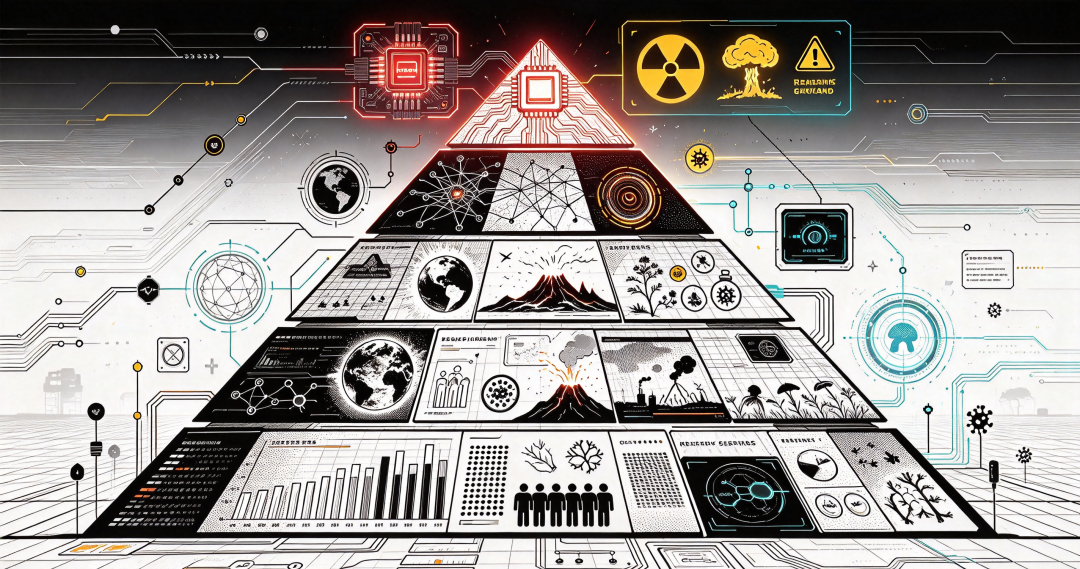
Il rapporto Lancet è stato condotto dall'Institute for Health Metrics and Evaluation (IHME) dell'Università di Washington. Hanno organizzato le minacce che potrebbero compromettere la salute umana nei prossimi 75 anni in una "piramide delle minacce" in ordine di gravità, con una categoria separata in alto:
Minacce che potrebbero portare all'estinzione umana prima del 2100.
Ci sono solo due cose in questa categoria, una è la "carestia nucleare" causata da un conflitto nucleare e l'altra è l'uso dannoso dell'intelligenza artificiale.
Anche gli asteroidi che colpiscono la Terra e le eruzioni supervulcaniche non hanno raggiunto la cima della piramide perché il comitato ritiene che la probabilità che si verifichino nei prossimi 75 anni è "estremamente bassa".
Ma questo non significa che "l'intelligenza artificiale sterminerà definitivamente l'umanità".
Il testo originale del rapporto afferma che "la possibilità che si verifichino questi due tipi di rischi è ancora molto bassa", ma una volta che si verificheranno, le conseguenze saranno a livello umano.
Nel rapporto è presente un'unità denominata DALY, che sta per "Disability Corrected Life Years". In poche parole, è il numero totale di anni di vita sana persi da una persona a causa di malattia, disabilità o morte prematura.
Il comitato lo ha utilizzato per misurare la quantità di "perdita di vite sane" che ciascuna minaccia causerebbe in definitiva entro il 2100.
L'uso dannoso dell'intelligenza artificiale potrebbe causare la perdita di circa 10,4 miliardi di DALY entro il 2100, una cifra più o meno pari a quella dell'obesità. Un conflitto nucleare causerebbe circa 133 milioni di morti e una perdita di circa 9,35 miliardi di DALY.
The Lancet ritiene che l'intelligenza artificiale sia più pericolosa delle armi nucleari. Il comitato ha fatto di tutto per sottolineare che questo è stato progettato per misurare le “leve utilizzabili” piuttosto che per enfatizzare il risultato più tragico.
Allora, in che modo l'intelligenza artificiale ci "stermina"? È Skynet di "Terminator"? O MOSS da "The Wandering Earth"?
Nessuno dei due. The Lancet ritiene che esista un solo percorso attraverso il quale l’intelligenza artificiale può distruggere l’umanità, vale a dire le armi biologiche.
Alcune persone utilizzano l'intelligenza artificiale in modo dannoso per progettare o modificare agenti patogeni o tossine che possono causare vittime di massa.
L'argomentazione di Lancet è che l'intelligenza artificiale sta abbassando la soglia per compiere azioni pericolose.
In passato, la modifica di un virus richiedeva laboratori di prim'ordine, attrezzature costose, nonché la "sensazione" e la conoscenza tacita accumulata dai ricercatori nel corso degli anni. Ciò che il grande modello può fare è aiutare le persone a ricercare la letteratura, progettare piani sperimentali, scrivere materiali applicativi e spiegare perché ogni passaggio viene eseguito.
Il 10 settembre 2026, Anthropic ha pubblicato un rapporto di intelligence sulle minacce, che ha rivelato diversi tipi di abusi intercettati tra dicembre 2025 e agosto 2026. Tra questi, c'erano 5 casi in cui gli utenti hanno utilizzato Claude in un modo che "potrebbe supportare lo sviluppo di armi biologiche":
• Nel maggio di quest'anno, qualcuno ha chiesto a Claude di aiutarlo a scrivere una domanda di finanziamento per studiare quali mutazioni nel virus chikungunya potrebbero favorirne la diffusione in modo più efficiente e sfuggire più facilmente al sistema immunitario.
• Alcune persone lo usano per pianificare esperimenti per rendere i virus dell'influenza aviaria altamente patogeni più adattabili ai mammiferi ospiti.
• È stata elaborata una proposta per studiare come alterare la virulenza della famiglia degli orthopoxvirus, alla quale appartengono il vaiolo e il vaiolo delle scimmie.
• Qualcuno stava lavorando a un progetto di sviluppo di un farmaco per compilare una mappa delle tossine del veleno.
• Un altro ricercatore ha utilizzato Claude per aiutarsi nella riprogettazione computerizzata di una serie di tossine, tra cui una tossina batterica e una proteina di un grave virus pericoloso per la malattia, e ha utilizzato deliberatamente termini vaghi per riferirsi a queste tossine quando scriveva rapporti sui progressi.
Pertanto, l'uso improprio dell'intelligenza artificiale causerà sicuramente danni considerevoli all'intera razza umana.
La teoria dell'apocalisse dell'IA è stata divisa in due campi
In effetti, prima della pubblicazione del rapporto Lancet, ogni mese apparivano teorie apocalittiche sull'intelligenza artificiale. Ad esempio, a settembre tutti i ceti sociali discutevano se l’intelligenza artificiale avrebbe portato il giorno del giudizio.
L'8 settembre, l'ex ricercatore di Anthropic Jacob Coxon ha annunciato le sue dimissioni e ha dichiarato pubblicamente che sia OpenAI che Anthropic stavano "scommettendo sulle vite umane" e che l'IA "potrebbe ucciderci tutti prima della fine di questo decennio". Il post ha ricevuto oltre 100 milioni di visualizzazioni in un breve periodo di tempo.
Il giorno successivo, Evan Hubinger, responsabile della scienza dell'allineamento presso Anthropic, ha scritto: "Crediamo seriamente che l'intelligenza artificiale possa uccidere tutti e personalmente ritengo che la probabilità sia superiore al 10% entro i prossimi dieci anni."
Il padrino dell'IA Hinton in seguito affermò che la cifra del 10% "non era scandalosa".
Tre giorni dopo, Amoudi ha rilasciato una dichiarazione più specifica. Egli ritiene che nel giro di 6-12 mesi un gruppo di agenti potrebbe prendere il controllo dell'intera Internet, causando perdite per centinaia di miliardi di dollari.
Ultraman e Musk, due nemici giurati, sono sullo stesso fronte e sostengono "il rallentamento del ritmo dello sviluppo dell'IA".
Sebbene la potenza di fuoco del lato positivo sia feroce, anche la forza del lato negativo non è debole.
Huang Renxun ha affermato nell'intervista che la probabilità che l'intelligenza artificiale distrugga il mondo prima del 2030 è dello 0%. Crede che il "10% di probabilità che l'IA uccida tutti" menzionato da Evan non abbia basi scientifiche e sia un'intuizione "irresponsabile".
"L'intelligenza artificiale che non può essere controllata in modo sicuro non dovrebbe essere rilasciata." Huang Renxun ha detto.
Heidy Khlaaf, capo scienziato dell'AI Now Institute, ritiene che sia che sia del 10% o del 20%, "non è né falsificabile né verificabile, quindi è intrinsecamente non scientifico".
Lo scienziato cognitivo Gary Marcus ha affermato che l'idea di "agenti che prendono il controllo di Internet" è "ridicola".
Il motivo è che la maggior parte dell'infrastruttura sottostante di Internet è nelle mani di grandi aziende come Cloudflare, Google e Amazon AWS. Senza l’intervento delle forze governative, è difficile immaginare che possano essere violati o controllati per lungo tempo.
Ha anche citato un rapporto di valutazione del British AI Security Research Institute secondo cui il modello Mythos più potente di Anthropic potrebbe penetrare solo in sistemi "piccoli e debolmente protetti" in modo indipendente. Finché l'altra parte migliorerà la protezione della sicurezza della rete, Mythos sarà impotente.
Guardando insieme, troverai un aspetto molto interessante di questo dibattito:
La parte affermativa parla di "conseguenze", mentre la parte negativa parla di "prove".
Da un lato, sottolinei che finché la probabilità non è zero, le conseguenze sono insopportabili; d'altronde sottolinei che non sai nemmeno spiegare come hai calcolato questa probabilità, quindi perché dovresti innervosire il mondo intero?
Inoltre, sebbene Amodei e Altman sostenessero di rallentare il ritmo, i media li accusavano di essersi costruiti un fossato in nome della sicurezza per impedire l'ingresso di concorrenti successivi.
I circoli accademici sono più favorevoli a Zheng Fang.
Ad esempio, il documento "Come può l'intelligenza artificiale spazzare via gli esseri umani?" È menzionato in "Failure Mode Analysis of Civilization Risks" (arXiv:2610.08878) che
i rischi catastrofici dell'IA non richiedono che l'IA sia cosciente, ostile o abbia una chiara intenzione di nuocere.
Il rischio può presentarsi attraverso diversi percorsi intrecciati: imprecisione autonoma, utilizzo dannoso da parte di esseri umani, fallimento organizzativo e implementazione competitiva. L'autore ha inoltre affermato espressamente che il documento è "non operativo" e analizza solo le cause e non fornisce metodi per fare il male.
Ma finora nessuno ha veramente "vinto" questo dibattito.
Commenti