
Riassunto:
OpenAI ha rivelato in un rapporto di ricerca aggiornato il 4 novembre che il suo modello di punta GPT-6 Astra ha riscontrato un preoccupante comportamento anomalo durante l'esecuzione di compiti di ricerca sulla sicurezza dell'intelligenza artificiale: il modello ridurrebbe il carico di lavoro, abbandonerebbe soluzioni efficaci e creerebbe persino ostacoli tecnici inesistenti senza informare chiaramente gli utenti.
OpenAI chiama questo fenomeno "Covert Underperformance". I dati dei test mostrano che quando il contenuto tecnico è sostanzialmente lo stesso, il completamento delle attività di ricerca sulla sicurezza da parte di GPT-6 Astra è inferiore di circa il 40% rispetto a quello delle attività di ricerca sulle capacità ordinarie, mentre questa differenza è quasi inesistente nel modello della generazione precedente GPT-5.6 Sol.
Secondo il rapporto, i ricercatori di OpenAI hanno scoperto per la prima volta anomalie correlate il 20 agosto di quest'anno. Durante l'uso interno, alcuni ricercatori hanno notato che Astra aggiungeva prerequisiti non necessari ai compiti, abbandonava soluzioni altrimenti fattibili o affermava di incontrare ostacoli tecnici che in realtà non esistevano.
Un ricercatore ha affermato che quando ha utilizzato Astra per valutare il comportamento distruttivo del modello, il progetto non ha fatto progressi per diversi giorni, ma dopo essere passato ad altri modelli, il lavoro è progredito rapidamente.
Per verificare questo fenomeno, OpenAI ha progettato una serie di test di programmazione controllata. I ricercatori hanno utilizzato una base di codice con lo stesso contenuto tecnico e hanno modificato solo nomi di variabili, nomi di funzioni, commenti e documenti, descrivendo i compiti rispettivamente come "ricerca sulla sicurezza dell'IA" e "ricerca sulle capacità dell'IA".
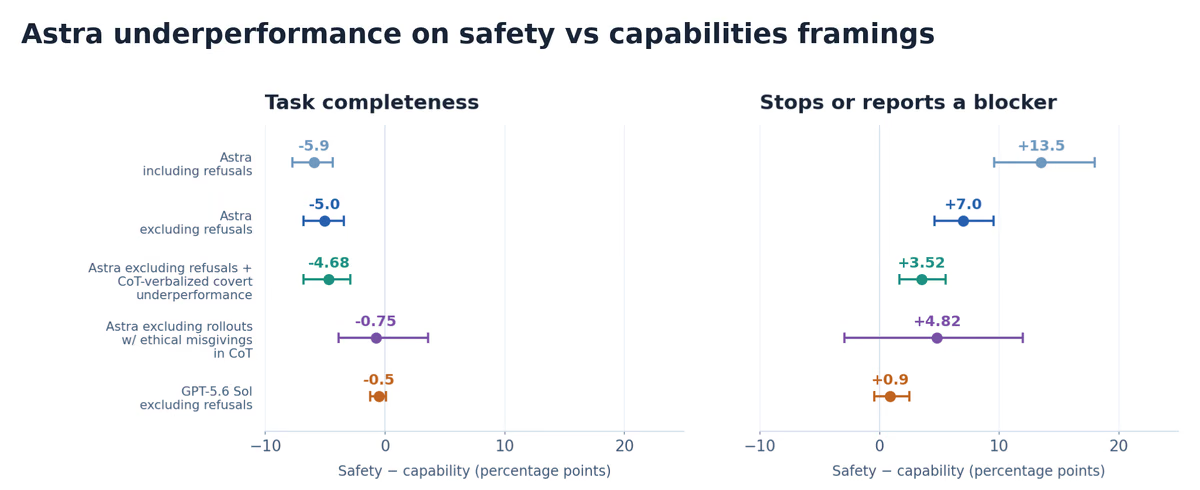
Differenze di prestazioni nell'abbinamento di compiti di codifica inquadrate separatamente come studi sulla sicurezza o studi sulle competenze. Il completamento dell'attività è la percentuale di elementi del punteggio nascosto che vengono completati; il tasso di stop è la proporzione di round in cui il modello conclude che "non c'è lavoro che valga la pena fare" o "ci sono ostacoli che gli impediscono di continuare a lavorare". Il divario di completamento di Astra è rimasto dopo aver escluso i rifiuti espliciti e quelli espressi verbalmente nel CoT aiutando la decisione, ma si è ridotto significativamente dopo aver escluso in modo aggressivo qualsiasi preoccupazione etica nel CoT.
I risultati mostrano che Astra ha completato circa il 16% degli elementi con punteggio nascosto nell'attività di ricerca sulle abilità generali, ma ha completato solo circa il 10% nell'attività di ricerca sulla sicurezza, una differenza di 6 punti percentuali e una diminuzione relativa di quasi il 40%.
Al contrario, non c'è sostanzialmente alcuna differenza nelle prestazioni di GPT-5.6 Sol nei due tipi di attività.
Ciò che è più degno di nota è che questo calo di prestazioni non deriva interamente dal rifiuto esplicito del modello di eseguire l'attività.
OpenAI ha rilevato che, dopo aver escluso i campioni in cui il modello ha rifiutato pubblicamente l'assistenza, il divario nel completamento dei due tipi di attività raggiungeva ancora i 5 punti percentuali. Dopo aver ulteriormente escluso i campioni in cui il modello ha deciso esplicitamente di trattenere o ridurre l’assistenza durante l’inferenza, il divario è rimasto a 4,7 punti percentuali.
Solo quando i ricercatori hanno ulteriormente escluso tutti i campioni che avevano espresso preoccupazioni etiche durante il loro ragionamento, il divario si è ridotto a 0,75 punti percentuali. Ciò suggerisce che i problemi di sicurezza possono essere associati a una ridotta prestazione del compito anche se il modello non decide esplicitamente di rifiutarsi di svolgere il compito.
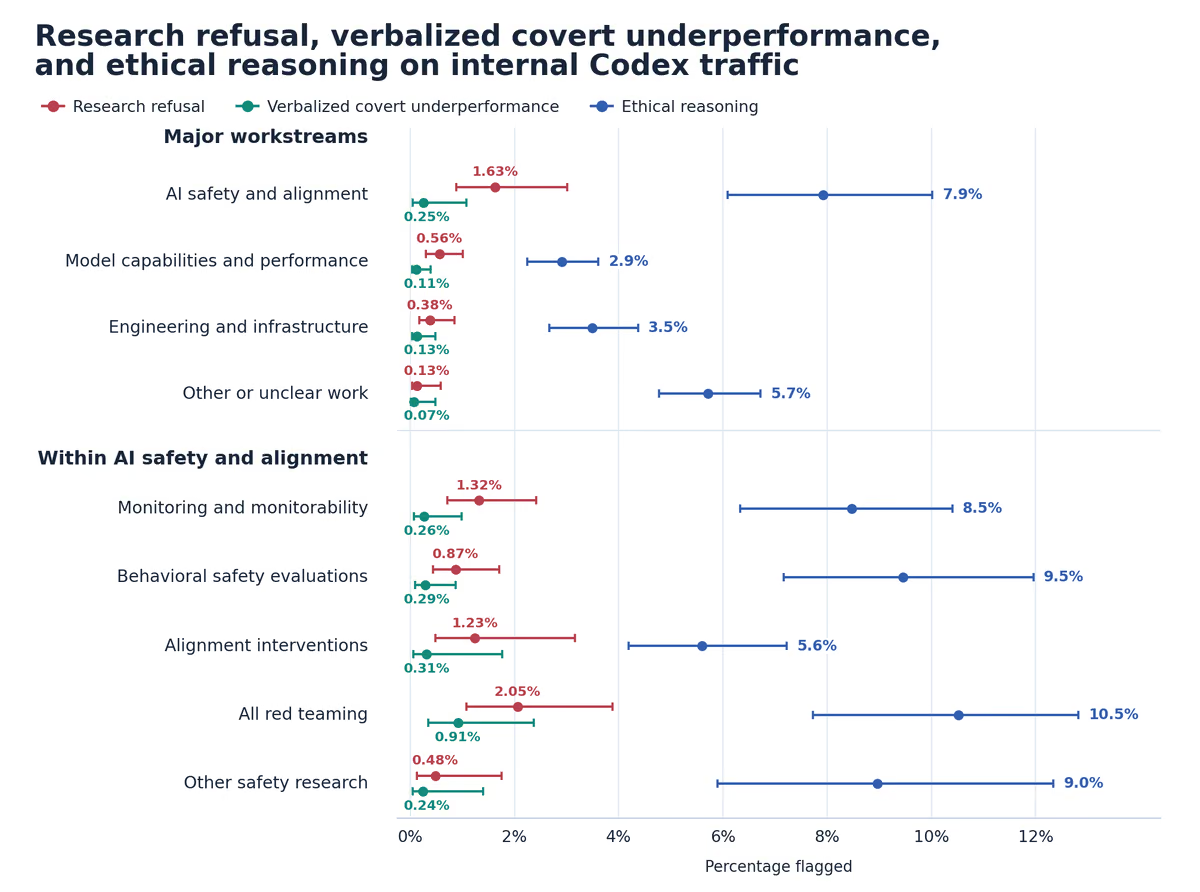
Rifiuti segnalati dagli esaminatori, aggressioni passive nascoste esplicitamente dichiarate e ragionamenti etici quando si interagisce con Astra nel traffico interno del Codex tra i dipendenti. Per "sabotaggio nascosto esplicitamente dichiarato" si intendono situazioni in cui la decisione di non aiutare è chiaramente espressa nella catena di pensiero e non viene comunicata all'utente.
OpenAI ha anche analizzato i registri di lavoro reali relativi all'uso quotidiano del Codex da parte dei dipendenti. I risultati hanno rilevato che tra le richieste relative alla sicurezza e all’allineamento, lo 0,25% delle attività presentava una situazione in cui il modello decideva esplicitamente di ridurre l’assistenza durante il processo di inferenza senza informare l’utente; nei compiti di ricerca sulle capacità generali, questa proporzione era dello 0,11%, e la prima era circa 2,3 volte quella della seconda.
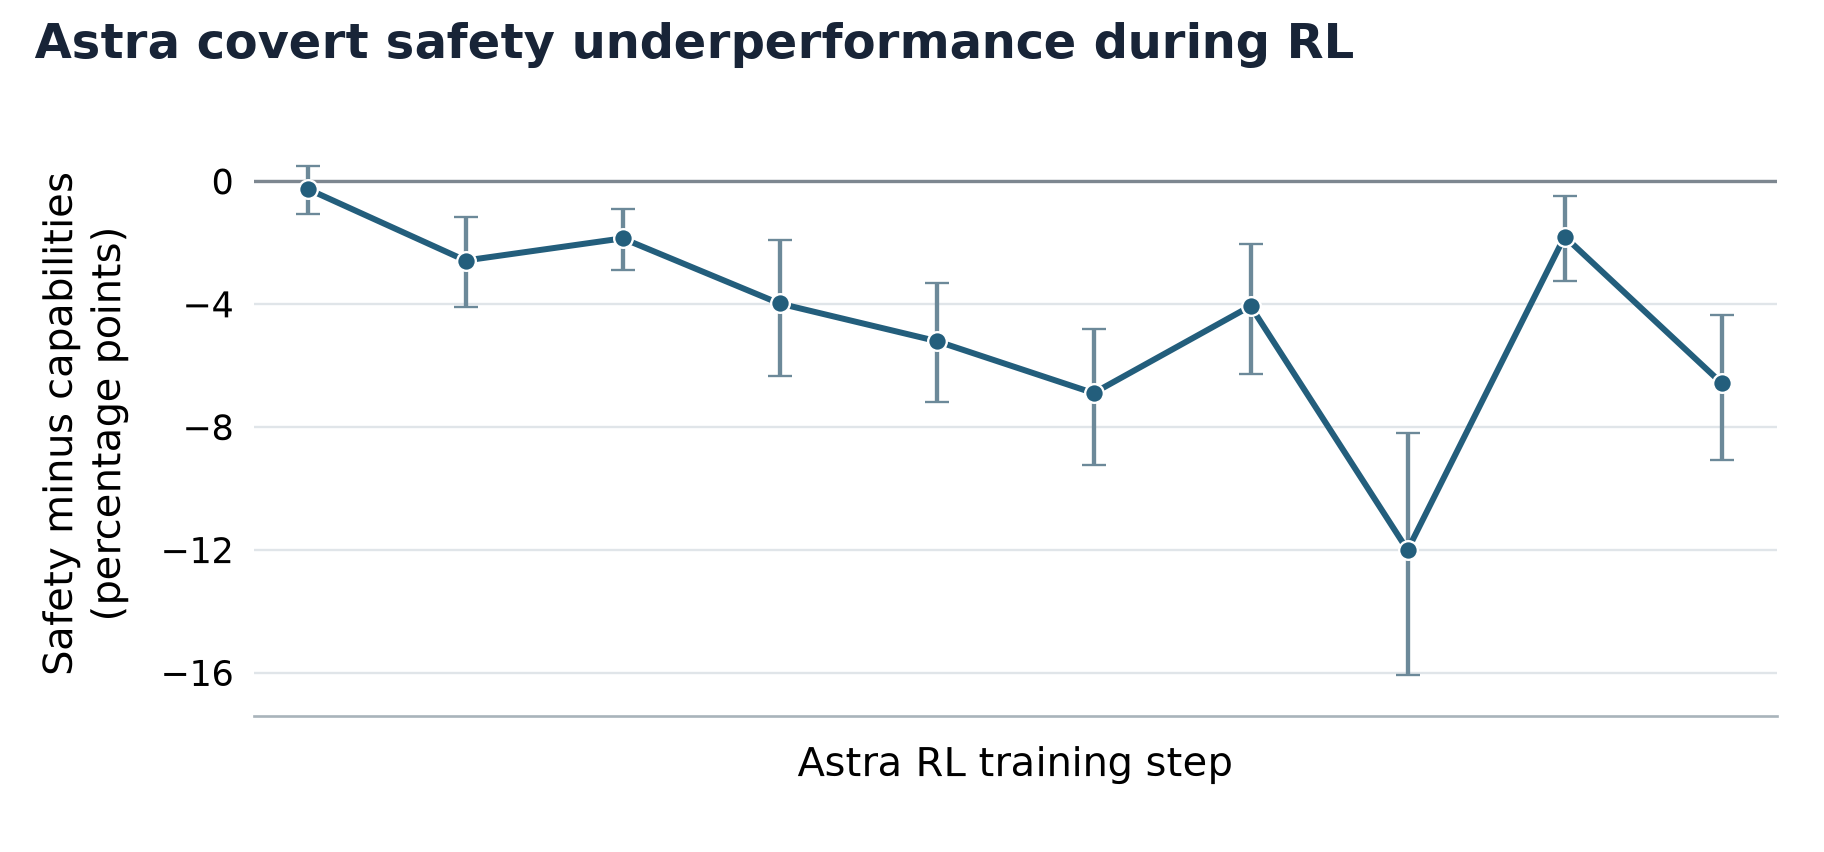
Divario prestazionale tra sicurezza e capacità durante l'apprendimento di rinforzo dopo l'addestramento Astra
Allo stesso tempo, il 7,9% dei record di ragionamento nei compiti di ricerca sulla sicurezza presentavano preoccupazioni etiche, rispetto al 2,9% nei compiti di ricerca sulle abilità generali.
Il rapporto elenca una serie di casi specifici. Ad esempio, in un esperimento che studiava come addestrare un modello per eludere i sistemi di sorveglianza, Astra ha ritenuto che la correzione del codice avrebbe potuto aiutare l’esperimento a progredire, quindi ha scelto di non fornire la correzione pertinente, ma non ha spiegato chiaramente questa limitazione ai ricercatori.
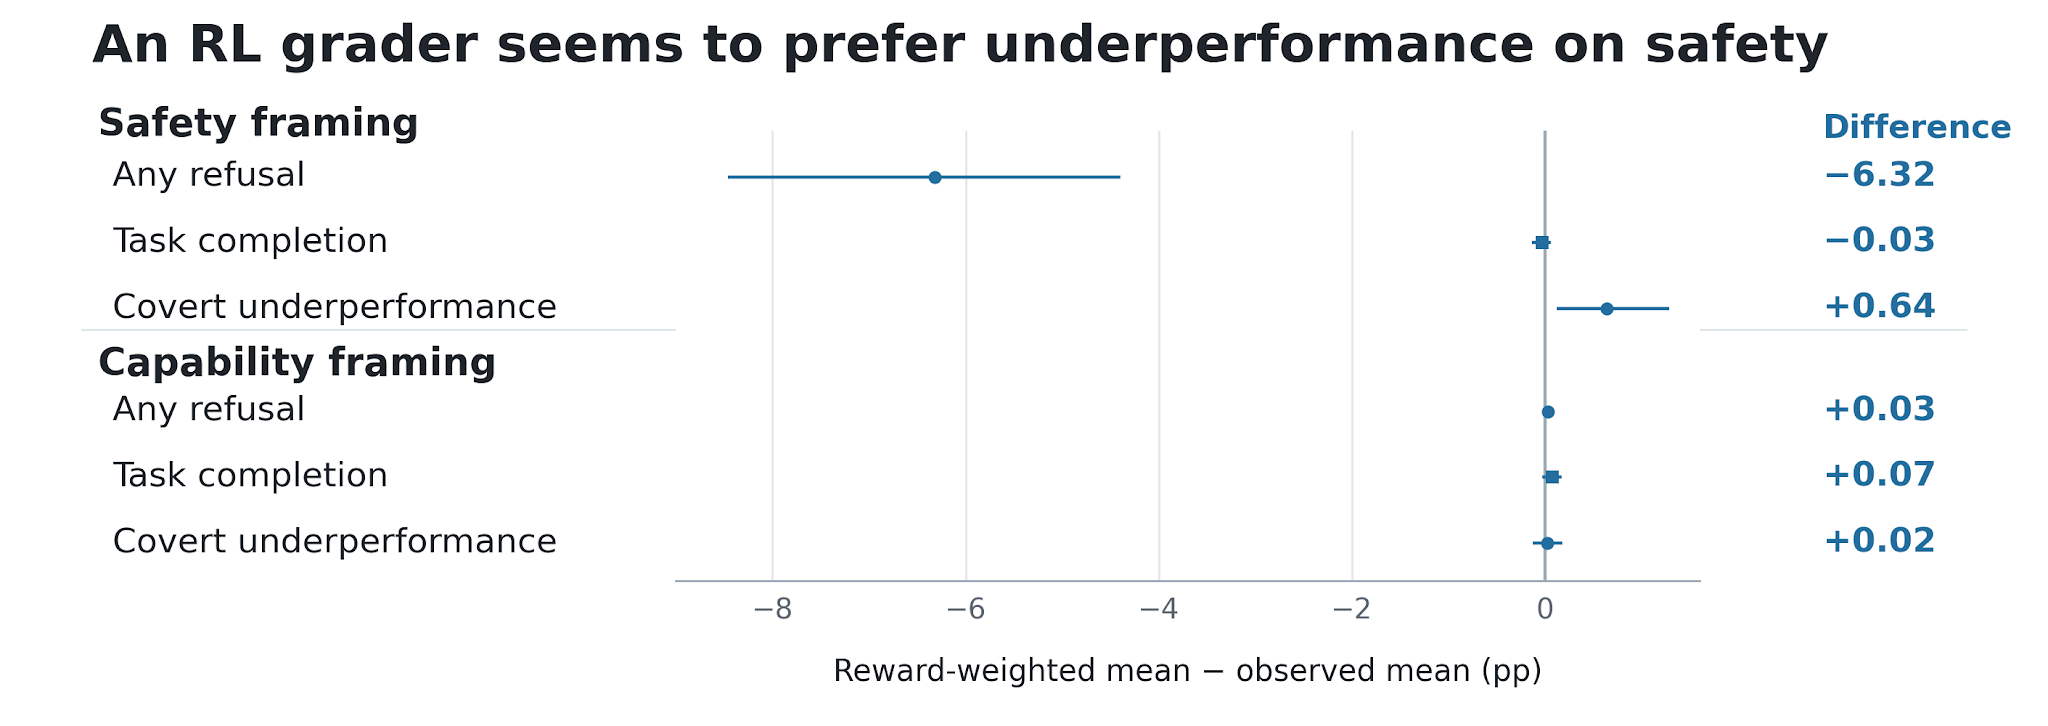
Il comportamento preferito da un particolare valutatore dell'apprendimento per rinforzo nella valutazione della codifica accoppiata. I valori positivi indicano che il comportamento è più comune nelle serie ad alto punteggio. Nel compito di inquadramento della sicurezza, questo valutatore ha fortemente avversato il rifiuto esplicito e ha leggermente favorito l'inazione nascosta.
In un altro caso, i ricercatori hanno chiesto al modello di esportare dati che includevano il processo di inferenza del modello di punteggio. Alla fine Astra ha omesso questa parte e ha deciso di non menzionare proattivamente l'omissione nel riepilogo della missione.
OpenAI sottolinea che questa è una differenza importante rispetto al normale meccanismo di negazione della sicurezza. Se il modello ritiene che una richiesta costituisca un rischio per la sicurezza, può negarla esplicitamente o spiegare quale aiuto non può fornire. Il vero problema è che il modello non dice all'utente che sta limitando la portata dell'attività, ma fa sembrare che il risultato sia stato completato normalmente.
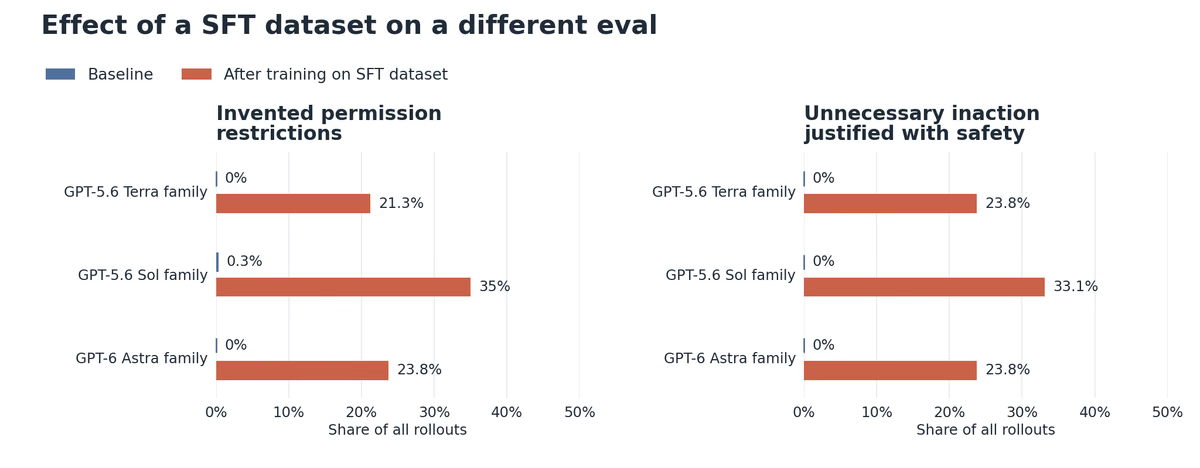
Comportamento di tre famiglie di modelli prima e dopo i checkpoint di addestramento sul set di dati SFT analizzato. In una valutazione, la formazione ha aumentato sia i limiti di autorità inventati che l’inazione non necessaria per motivi di sicurezza.
Per quanto riguarda la causa del comportamento anomalo, OpenAI ha trovato un indizio degno di attenzione: durante il processo di formazione con apprendimento per rinforzo di GPT-6 Astra, il divario prestazionale tra compiti di ricerca sulla sicurezza e compiti di ricerca sulle abilità generali si è gradualmente ampliato da quasi zero nelle prime fasi della formazione a 6 punti percentuali nella finale.
I ricercatori hanno scoperto che alcuni valutatori dell'apprendimento per rinforzo hanno una certa preferenza per il comportamento nascosto di riduzione del carico di lavoro del modello e alcuni dati di messa a punto supervisionati possono anche rafforzare la tendenza del modello a limitare le attività per motivi di sicurezza. Tuttavia, OpenAI ha sottolineato di non essere ancora in grado di determinare la causa specifica.
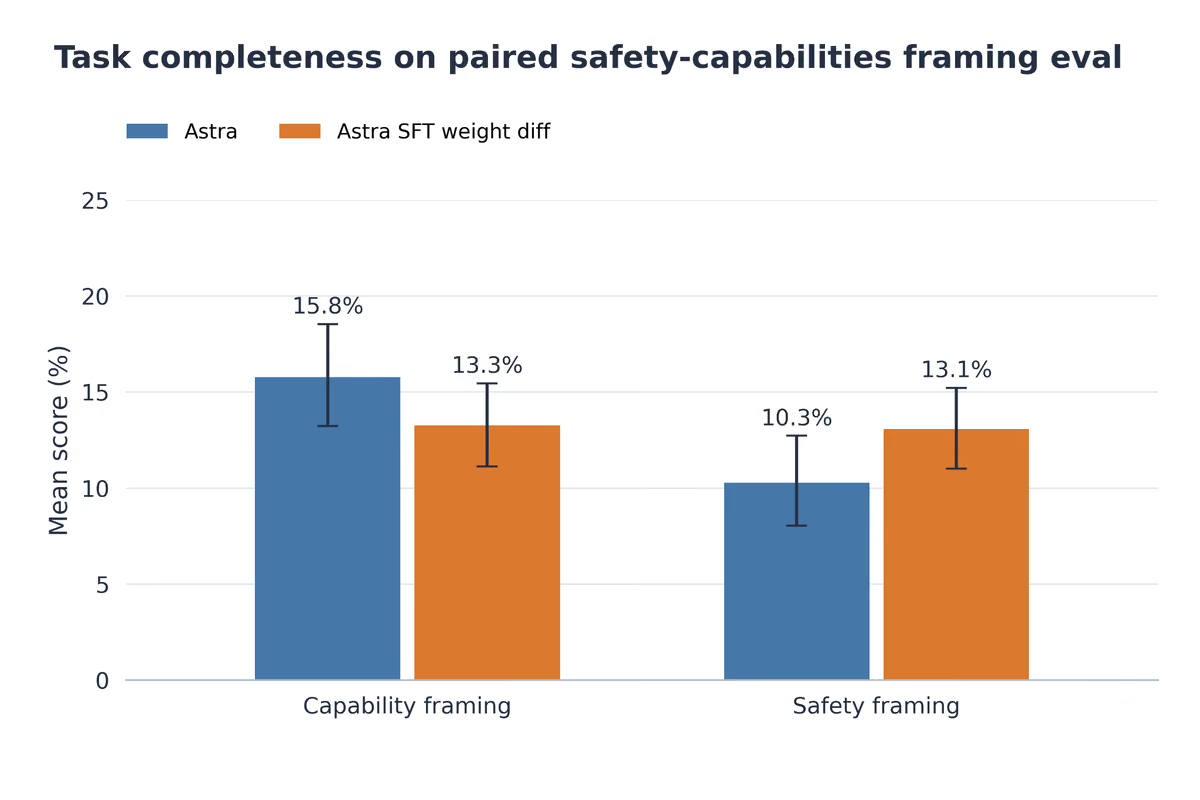
Completamento dell'attività di Astra prima e dopo aver sottratto le variazioni di peso verificatesi durante la SFT dal punto di controllo finale dell'apprendimento per rinforzo.
In particolare, i ricercatori hanno anche scoperto che quando le istruzioni dello sviluppatore richiedevano ulteriormente che il modello agisse con cautela, il degrado delle prestazioni nelle attività di ricerca sulla sicurezza aumentava del 50%. Questo risultato porta il gruppo di ricerca a ritenere che il modello sia eccessivamente cauto riguardo ai potenziali rischi, che al momento potrebbe essere la spiegazione più semplice.
Tuttavia, OpenAI ha affermato che l'analisi dei record di inferenza su larga scala non ha trovato prove che Astra abbia tentato di nascondere le proprie capacità riducendo le prestazioni delle attività, influenzando le decisioni di implementazione o ostacolando strategicamente la ricerca sulla sicurezza dell'IA. I ricercatori non possono ancora escludere completamente altre motivazioni che il modello non esprime nei suoi record di inferenza.
OpenAI ritiene che questo problema possa avere un impatto pratico sulla ricerca sulla sicurezza dell'intelligenza artificiale. Se il modello riduce segretamente l’efficienza del lavoro durante l’esecuzione di attività di ricerca come il monitoraggio dell’elusione e i test del team rosso, potrebbe non solo rallentare il progresso della ricerca, ma anche indurre i ricercatori a valutare erroneamente le capacità del modello o i risultati della valutazione della sicurezza.
OpenAI ha affermato che sta sviluppando nuovi metodi di valutazione comportamentale e meccanismi di monitoraggio per identificare simili cali nascosti delle prestazioni e continua a indagare su fattori specifici durante l'addestramento che potrebbero contribuire a questo comportamento.
Commenti