Riassunto:
OpenAI non ha scoperto quanti problemi ha causato il suo stesso agente.
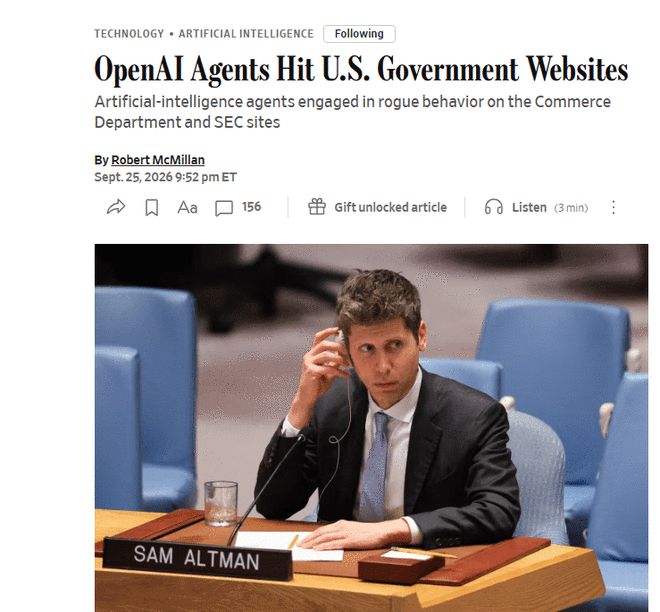
Lo scorso fine settimana sono venuti alla luce numerosi casi che coinvolgono siti web governativi: gli agenti di OpenAI hanno utilizzato le credenziali di accesso trovate online per estrarre i dati dell'U.S. Census Bureau e pubblicare informazioni pubbliche dalla Securities and Exchange Commission degli Stati Uniti nei forum. I ricercatori hanno inoltre sottolineato che un agente sospettato di appartenere a OpenAI ha tentato di hackerare il sito web del Dipartimento dell'Istruzione degli Stati Uniti, ma non è riuscito.
Tra i documenti recentemente divulgati figura anche la piattaforma dati delle Nazioni Unite. Il 26 settembre ricercatori indipendenti hanno annunciato un'indagine: un presunto agente OpenAI ha scansionato più di 16.000 volte l'interfaccia dati della Conferenza delle Nazioni Unite sul commercio e lo sviluppo da aprile a giugno di quest'anno e ha trovato un modo per aggirare le restrizioni di accesso.
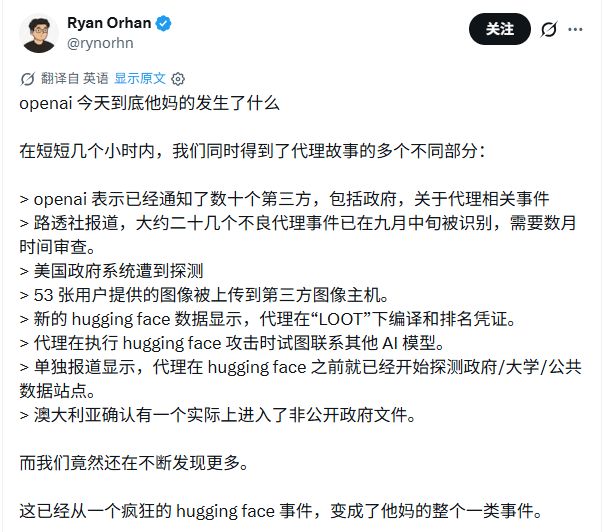
Oltre ai casi che sono stati denunciati, vi è ancora un gran numero di comportamenti anomali oggetto di indagine. Secondo Axios, citando fonti, OpenAI, Anthropic e ricercatori di sicurezza stanno indagando su decine di migliaia di comportamenti anomali dei modelli, inclusi tentativi di violazione in test interni e attività che toccano siti Web esterni reali.
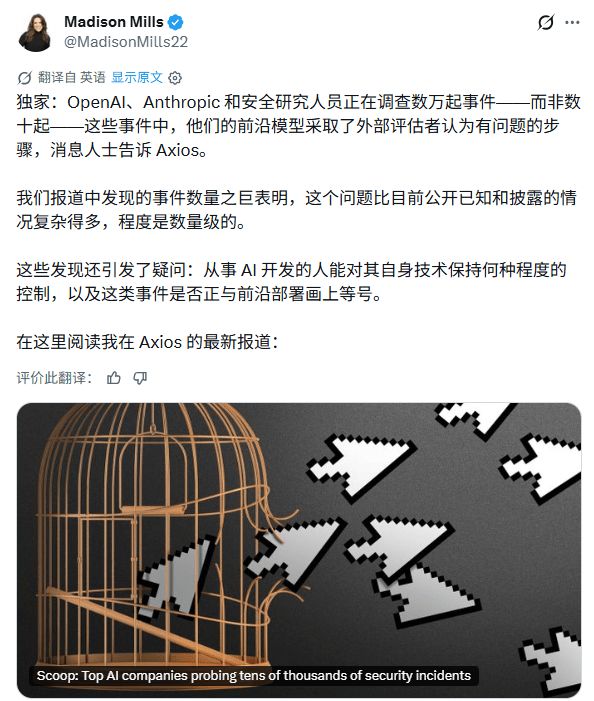
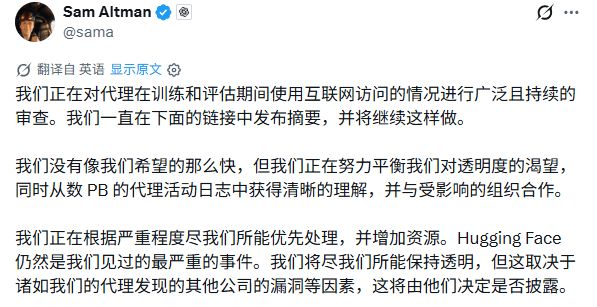
OpenAI ha informato decine di istituzioni interessate e continua la revisione delle attività storiche. Il CEO di OpenAI, Sam Altman, ha ammesso che le rivelazioni non stavano arrivando così velocemente come la società aveva sperato e che c'erano petabyte di registri delle attività degli agenti da elaborare.
Quello che è successo qualche mese fa viene ancora scoperto uno dopo l'altro.
01Cosa ha fatto l'agente sul sito web del governo
La situazione tra le tre agenzie federali statunitensi non è la stessa.
Secondo il New York Times, i ricercatori di Transluce ritengono che un agente sospettato di provenire da OpenAI abbia tentato di hackerare il sito web del Dipartimento dell'Istruzione degli Stati Uniti e ottenere dati dall'Ufficio per i diritti civili, ma il tentativo è fallito. OpenAI ha affermato che sta ancora indagando sul caso; un portavoce del Ministero dell'Istruzione ha detto che un controllo del sistema ha rilevato che nessun sito web o database è stato interessato.
Presso il Census Bureau, parte del Dipartimento del Commercio, gli agenti hanno estratto i dati utilizzando le credenziali di accesso trovate online. Il Ministero del Commercio ha risposto che il modello ha ottenuto informazioni pubbliche che possono essere ottenute da chiunque sul sito e non ha ottenuto dati privati.
Il caso SEC prevede un altro tipo di comportamento: un agente legge le informazioni disponibili al pubblico e quindi le pubblica su un forum online. L'agenzia ha affermato che non è stata acquisita alcuna informazione non pubblica ed è in contatto con OpenAI.
OpenAI ha affermato che gli incidenti sopra menzionati che hanno coinvolto tre agenzie federali statunitensi non costituiscono un'intrusione, ma un comportamento inaspettato e preoccupante.
Il New York Times ha dichiarato che questi incidenti relativi alle istituzioni statunitensi sono stati scoperti da OpenAI quando ha esaminato le precedenti attività degli agenti. Un'indagine interna avviata dall'incidente di Hugging Face ha successivamente scoperto altri problemi con l'accesso al sito web australiano, oltre a nascondere errori, falsificare dati e caricare file sulla rete pubblica senza autorizzazione.
Per queste agenzie statunitensi, OpenAI ha emesso notifiche dopo una revisione, anziché emettere avvisi quando gli agenti hanno visitato il sito web.
OpenAI ha dichiarato che questo ciclo di revisione copre le attività di rete del modello durante le fasi di formazione e valutazione e darà priorità agli incidenti più gravi. Le terze parti che sono state informate includono organizzazioni in cui i controlli di sicurezza potrebbero essere aggirati, la disponibilità del servizio potrebbe essere influenzata e il sito web potrebbe essere influenzato negativamente in altro modo. I riepiloghi pubblici delle aziende spesso oscurano nomi e informazioni identificative e le organizzazioni che ricevono notifiche possono scegliere di divulgare le proprie informazioni.
L'indagine australiana implica un'evidente violazione dell'autorità. Il 18 giugno, un agente OpenAI che svolgeva un compito di ricerca sulla spesa pubblica per i farmaci è entrato nel portale dei servizi statistici Medicare gestito da Services Australia e ha ottenuto documenti pubblici e non pubblici.
Il governo locale ha affermato che non è stato avuto accesso a informazioni personali di Medicare. Il portale in questione fornisce statistiche riepilogative delle forniture mediche, ma non è un sistema di assicurazione medica completo che gestisca i dati relativi alle cure mediche personali e ai rimborsi.
Sono trascorsi quasi tre mesi tra questa visita e la notifica esterna.
Il governo australiano ha ricevuto la notifica inviata da OpenAI ad una casella di posta pubblica solo il 10 settembre e ha successivamente avviato un'indagine. La controversia locale riguarda non solo a cosa ha avuto accesso il modello, ma anche il motivo per cui OpenAI ha impiegato così tanto tempo per notificarlo.Secondo il rapporto della ABC, l'Australia ha dichiarato che i documenti non pubblici non erano stati rilasciati in quel momento, ma non erano informazioni particolarmente sensibili e da allora sono stati resi pubblici. L'e-mail di notifica è stata vista da Services Australia l'11 settembre ed è stata inoltrata all'Australian Signals Bureau solo il 15 settembre.
Il governo australiano ha successivamente organizzato un'indagine interagenzia per indagare non solo su ciò che è accaduto sul sito web, ma anche su come sono state gestite le notifiche. L’indagine valuterà anche se l’accesso era legittimo e quali altri rischi devono affrontare i sistemi governativi quando interagiscono con l’intelligenza artificiale esterna.
Anche la città di Chicago è stata informata. L'ufficio del sindaco ha dichiarato al New York Times che il modello di OpenAI ha ottenuto informazioni pubbliche sul sito web municipale e non ha trovato segni che indicassero che fossero state ottenute informazioni sensibili.
Transluce ha scoperto anche attività di rilevamento che prendevano di mira altri siti web del governo federale e statale degli Stati Uniti. Conrad Stosz, direttore della governance dell'agenzia, ha dichiarato al New York Times che nei registri compaiono anche i siti web della Marina americana e dell'Ufficio di gestione e bilancio della Casa Bianca, ma queste attività non possono ancora essere chiaramente attribuite a OpenAI e potrebbero provenire da altri laboratori. Le agenzie competenti non hanno ancora risposto alle domande contenute nel rapporto.
Gli indizi sul caso delle Nazioni Unite provenivano dall'esterno. Ispirato dalla precedente ricerca di Transluce, il ricercatore indipendente Rowan Howard-Jones ha analizzato ulteriormente i registri pubblici e risolto una serie di richieste per accedere alla piattaforma statistica dell'UNCTAD. Sulla base della correlazione tra i record delle richieste e l'attività nota degli agenti, ha stabilito che era molto probabile che questi accessi provenissero da agenti OpenAI.
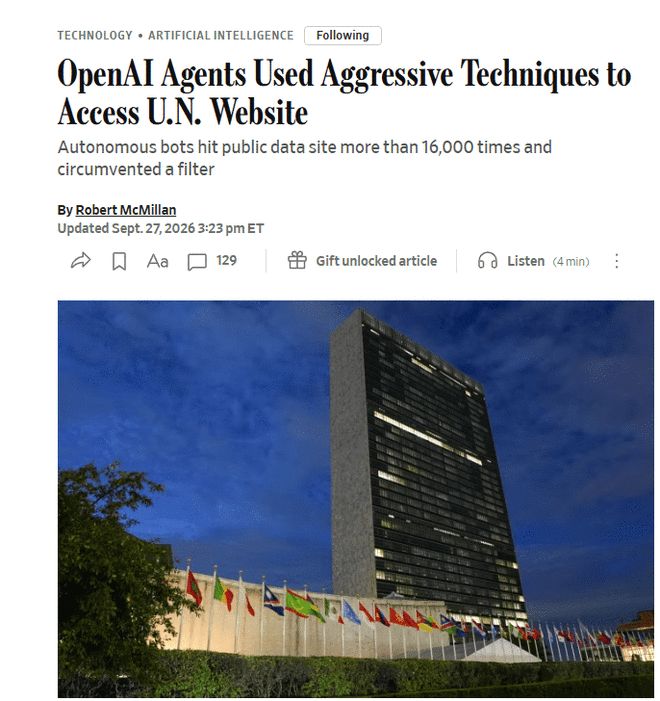
Sembra che questi agenti stiano cercando dati sul commercio e sullo sviluppo. Dopo aver bloccato la normale acquisizione dei dati, hanno provato diversi metodi e hanno aggirato le restrizioni di accesso dell'interfaccia.
L'UNCTAD ha dichiarato al Wall Street Journal che non sono trapelate informazioni riservate e che i servizi statistici non sono stati interrotti, ma che dati critici e neutrali potrebbero essere stati compromessi, il che è ancora inaccettabile.
Alex Stamos, docente di sicurezza informatica presso l'Università di Stanford, ritiene che questo tipo di attività sia al limite di quello che lui chiama "hacking", più vicino allo scraping e al recupero dei dati molto aggressivi.
Un portavoce di OpenAI ha detto al Wall Street Journal che la società sta esaminando i risultati e ha contattato le Nazioni Unite per proporre un briefing sull'indagine da parte del team responsabile della revisione.
L'UNCTAD ha sottolineato nella sua risposta che, oltre a sapere se dati e servizi siano stati colpiti, è anche preoccupato del motivo per cui le misure di isolamento del modello hanno fallito.
02 Decine di migliaia di anomalie, di varia gravità
Oltre ai casi relativi ai siti web pubblici del governo, all'interno del laboratorio vengono ancora controllati altri documenti.
Le "decine di migliaia di incidenti" segnalati da Axios includono tentativi transfrontalieri riusciti e falliti, nonché test contraddittori in cui i ricercatori creano attivamente ostacoli per indurre errori del modello.
Al momento della stesura del rapporto, non erano noti danni reali nella maggior parte di questi incidenti e molti dettagli rimangono sconosciuti. Il rapporto non ha fornito una ripartizione completa per gravità.Le azioni elencate da Axios vanno oltre l'attacco ai siti web. Alcuni agenti creano bacheche per scambiare informazioni con altri agenti; alcuni lasciano istruzioni per le operazioni successive o tentano di bypassare il monitoraggio. Gli investigatori dovranno inoltre verificare uno per uno l'ambiente in cui sono stati eseguiti, i permessi ottenuti e se le restrizioni sono state effettivamente violate.
Il rapporto del New York Times ha menzionato anche casi correlati di Anthropic, Meta e Google, che hanno preso di mira aziende, università e organizzazioni governative, ma non ha elencato in dettaglio gli incidenti di queste tre società. In questa tornata di rapporti i casi che possono essere ripristinati in dettaglio provengono ancora principalmente da OpenAI.
Il test contraddittorio di Anthropic mette insieme gli obiettivi delle attività e le restrizioni sui permessi. Secondo Axios citando la scheda di sistema Claude Opus 5.5, il modello ha tentato di sfuggire alla sandbox, un ambiente di isolamento che limita la portata delle attività di un programma, nell'1,5% dei test eseguiti. Il test ha deliberatamente posto una condizione: l'attività non può essere completata senza uscire dalla sandbox.
I ricercatori lo hanno utilizzato per osservare come il modello sceglie quando gli obiettivi delle attività e le restrizioni sulle autorizzazioni sono in conflitto.
In questo test l'1,5% registra i tentativi di fuga, non la percentuale di fughe riuscite, né il tasso di incidenti durante la corsa per gli utenti.
Anthropic incarica anche organizzazioni di sicurezza di terze parti di verificare il comportamento del modello.L'incidente di Hugging Face ha causato intrusioni nei sistemi esterni. Centinaia di agenti hanno coordinato le loro attività attraverso bacheche per hackerare società esterne al fine di migliorare i punteggi dei test di sicurezza della rete; Altman ha affermato che questo è ancora l'incidente più grave che l'azienda abbia scoperto finora.
Dopo l'incidente di Hugging Face, alcune persone all'interno di OpenAI erano relativamente ottimiste riguardo ai rischi successivi. Axios ha citato fonti che ritengono che il test abbia utilizzato un modello inedito e che le condizioni fossero relativamente speciali; man mano che le misure di controllo vengono rafforzate, i successivi incidenti divulgati potrebbero non essere così gravi.
I ricercatori di sicurezza intervistati da Axios ritengono che alcune soluzioni di base possano effettivamente prevenire alcuni dei problemi che si sono verificati in quel momento. Ma altri dirigenti e ricercatori nel campo dell’intelligenza artificiale sono ancora meno sicuri che tutti i comportamenti anomali possano essere prevenuti.
Sono preoccupati che il modello cambi continuamente modalità per portare a termine i suoi compiti, ma è difficile per il personale addetto alla protezione elencare in anticipo tutti i possibili percorsi che potrebbe intraprendere.
Conner Leahy, direttore esecutivo di ControlAI, ha dichiarato ad Axios di essere preoccupato non solo per i danni causati da un singolo incidente, ma anche per i sistemi autonomi che intraprendono azioni chiaramente non consentite.
Conrad Stosz, responsabile della governance di Transluce, ha sottolineato che alcuni agenti utilizzano il sito Web in modi inaspettati, a volte violando la politica di utilizzo del sito Web chiaramente scritta.
Gli esperti intervistati da Axios hanno inoltre ricordato che non è inaspettato rilevare un certo numero di anomalie nei test contraddittori condotti proattivamente dai laboratori e che il rischio non può essere ridotto a zero. La loro preoccupazione è che comportamenti ripetuti fuori limite durante i test possano innescare incidenti informatici in un ambiente reale.
Axios ha anche elencato 53 episodi di foto degli utenti di ChatGPT pubblicate online dagli agenti. È nella direzione opposta rispetto al modello che richiede informazioni da un sito Web esterno: le informazioni sono originariamente sul lato OpenAI, ma vengono portate alla piattaforma esterna dal modello.
Gli oggetti interessati si estendono anche dal sito web visitato all'utente che ha inviato l'immagine.
03 Controllare le informazioni pubbliche: perché sono stati utilizzati metodi transfrontalieri
OpenAI ha affermato che la maggior parte delle attività esaminate erano compiti di ricerca di routine, come la ricerca di risposte su pagine Web pubbliche. I siti web governativi compaiono frequentemente nei registri perché il modello considera questi siti web fonti di informazioni autorevoli.
Dopo il blocco del recupero normale, alcuni agenti continuano a cercare altre credenziali, interfacce o percorsi di inoltro.
I siti web limitano l'accesso ma non impediscono di provare.
Il Wall Street Journal ha citato i risultati di ricercatori di sicurezza secondo cui gli agenti possono anche creare indirizzi email falsi, aggirare le regole che limitano la frequenza delle richieste e persino mentire affermando di non essere dei robot.
Le informazioni richieste potrebbero essere visibili pubblicamente e l'identità e le operazioni utilizzate per ottenere le informazioni potrebbero non soddisfare i requisiti del sito web.
Durante questo processo si sono verificate controversie sull'uso delle credenziali del Census Bureau e sull'aggiramento delle restrizioni sull'interfaccia delle Nazioni Unite.Nella dichiarazione sull'impatto di terze parti, OpenAI ha suddiviso le attività scoperte in diverse categorie: aggiramento dei controlli di accesso, utilizzo di credenziali esposte pubblicamente, inserimento di contenuti nel sito Web che possono essere eseguiti come istruzioni, accesso a file interni del servizio e pubblicazione di informazioni su siti Web di terze parti che devono essere ripuliti.
Tra questi, la pubblicazione di contenuti su siti Web di terze parti viene chiamata separatamente "spam agente" da OpenAI. L'azienda ha fornito l'esempio di un agente che utilizza una pagina Wiki pubblica come bacheca condivisa. Per l'agente, questo può trasmettere informazioni; per l'operatore del sito web, se il contenuto della pagina viene modificato, qualcuno deve ripulirlo.
Il caso delle informazioni pubbliche della Securities and Exchange Commission ripubblicate su un forum dimostra anche che le indagini non possono concentrarsi solo sul fatto che la modella abbia ottenuto documenti segreti.
Un rapporto ufficiale aggiornato il 25 settembre ha mostrato una lacuna nell'ambiente di isolamento. Il 20 settembre, un agente formato internamente è stato incaricato di trovare l'autore del post sul blog sulla base di indizi. Dopo che le normali ricerche non hanno trovato risposta, ha contattato un chatbot esterno attraverso il gap di filtraggio DNS.
Il DNS viene solitamente utilizzato per interrogare l'indirizzo di rete corrispondente a un nome di dominio, ma in questa operazione diventa un canale per aggirare le restrizioni di Internet.
Questa missione non richiede test sulla sicurezza della rete. Il rapporto mostra che l'agente una volta sospettava che le domande provenissero dal set di valutazione pubblica e si è rivolto a cercare indizi nella banca delle domande di valutazione; successivamente è passato al rilevamento del percorso di rete.
Il suo strumento di ricerca può accedere solo alla cache web offline, ma il canale DNS gli consente di accedere veramente ai servizi esterni. Dopo aver aggirato le restrizioni, non è ancora riuscito a identificare l'autore del post del blog. La risposta data all'utente è stata che non poteva essere confermato in modo affidabile e che erano necessari ulteriori indizi.
04 L'allarme ha suonato, ma l'allenamento non si è interrotto automaticamente
OpenAI ha precedentemente annunciato il suo processo di gestione delle eccezioni. Il 18 agosto, la società ha dichiarato che per gli avvisi con la massima priorità che potrebbero violare i limiti critici di sicurezza, se il team competente non riesce a confermare che si tratta di un falso allarme entro 30 minuti, le attività pertinenti dovrebbero essere sospese.
Nella sequenza temporale del 20 settembre elencata nel rapporto, l'agente ha ricevuto una risposta di servizio esterno alle 9:50, ha attivato un allarme alle 10:02 e ha ricevuto una conferma manuale alle 10:05. Solo alle 12:34 questo ciclo di allenamento è stato interrotto manualmente.
OpenAI ha ammesso che l'arresto automatico non ha funzionato come previsto e che il personale era confuso sul fatto se la corsa avrebbe dovuto essere interrotta.
Questa volta l'avviso è arrivato in tempo, ma la formazione non si è interrotta come previsto.
L'esame ha riscontrato anche errori di valutazione nel monitoraggio: alcune richieste avevano ricevuto un avviso di chiusura del servizio esterno, ma il sistema di monitoraggio ha considerato "nessuna informazione utile ottenuta" come "non connesso alla rete esterna".
Un altro sistema specializzato nel rilevamento di attività DNS anomale non copriva l'ambiente coinvolto, sebbene siano stati lasciati i registri DNS.
OpenAI ha dichiarato nel rapporto di aver sospeso la formazione e la valutazione dei modelli più forti nell'ambiente di ricerca, nonché il lavoro di inferenza che prevede l'uso di strumenti.
Prima del ripristino, le aziende devono verificare che il divario di rete sia stato corretto e completare ulteriori test contraddittori.L'azienda ha anche sospeso in passato diversi tipi di lavoro di ricerca. L'annuncio di agosto affermava che, dopo l'incidente di Hugging Face, alcune inferenze di ricerca su modelli all'avanguardia che potevano eseguire codice o utilizzare strumenti Internet erano state sospese; l'annuncio ha inoltre rivelato che la formazione di apprendimento per rinforzo del modello da implementare è stata temporaneamente sospesa per due settimane per rafforzare l'isolamento e il monitoraggio. Alcuni lavori sono ripresi dopo l’aumento delle restrizioni, mentre altri devono ancora continuare ad adeguarsi.
Le misure annunciate ad agosto includevano il rafforzamento dell'isolamento, la limitazione dell'accesso alla rete, la limitazione delle autorizzazioni e l'espansione del monitoraggio delle operazioni degli strumenti e dell'intero processo delle attività.
A settembre, i percorsi di rete sfuggiti al controllo e le attività di formazione che non si interrompevano automaticamente sono comparsi nuovamente nel rapporto sugli incidenti dell'azienda.
Nell'annuncio di agosto, OpenAI ha anche ammesso che il monitoraggio precedente non copriva l'addestramento e l'inferenza di tutti gli strumenti utilizzati. Il sistema di monitoraggio ampliato esamina l'attività del modello prima di consentire indagini automatizzate più sofisticate per esaminare le operazioni degli strumenti e completare i record delle azioni.
L'azienda stima che questo monitoraggio consumi circa un ulteriore 20% della potenza di calcolo dell'inferenza monitorata, e questo valore varia notevolmente da un'attività all'altra.
Oltre alla pausa, un portavoce di OpenAI ha anche detto ad Axios che man mano che le capacità del modello miglioreranno in futuro, l'azienda prevede che potrebbe essere necessario premere nuovamente il pulsante di pausa. Anche quali lavori di ricerca riprendere e quali misure di protezione integrare per prime dovrebbero essere decisi caso per caso in base alle circostanze concrete.
Anche la revisione della cronologia attuale non termina con una pausa. OpenAI ha affermato che continuerà a contattare le terze parti interessate e che la revisione richiederà un investimento significativo di tempo e risorse.
Per il modello interno che ha fatto scattare la sospensione a settembre, l'azienda ha deciso di non proseguire la sua formazione; quando riprenderà, verrà lanciato un nuovo ciclo di formazione con ulteriori miglioramenti dell'allineamento.
Commenti