
Riassunto:
Il team di ricerca di Apple rivela i progressi nella ricerca sul "cervello" dei robot. Il 4 novembre, ora locale, il gruppo di ricerca Apple ha presentato il documento "Perceptive Humanoid Motion from Simulation" sulla piattaforma di prestampa arXiv, rivelando il sistema di controllo autonomo del robot umanoide HALO. Il team di ricerca ha implementato il sistema sul robot umanoide G1 di Yushu Technology per la verifica, consentendo al robot di eseguire le azioni apprese nell'ambiente di simulazione e di eseguirle in una stanza della vita reale sconosciuta.
Il team di ricerca ha inoltre rivelato la generazione dei dati, l'addestramento del modello e il codice di distribuzione, che copre la generazione di azioni, il monitoraggio delle azioni, l'orchestrazione delle attività, la simulazione e il funzionamento reale dei robot.
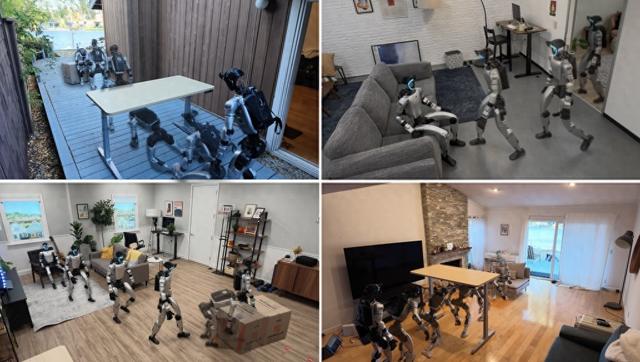
Il robot Yushu G1 dotato Il sistema HALO dimostra attività come strisciare sotto il tavolo, sedersi sul divano e spingere scatole in diversi ambienti reali. Fonte immagine: team di ricerca HALO
La pagina del progetto mostra il robot che segue le istruzioni per spingere scatole, seguire persone, sedersi su sedie, attraversare lateralmente una porta semiaperta, piegarsi o strisciare sotto un tavolo, ecc. Questi compiti richiedono che il robot comprenda l'ambiente circostante e adatti la postura del corpo in base alle condizioni spaziali.
Durante l'esecuzione delle attività, HALO è controllato in modo collaborativo da tre livelli. Il livello superiore è il modulo di orchestrazione delle attività basato sul modello del linguaggio visivo (VLM). Per impostazione predefinita utilizza Qianwen Qwen3.6-35B-A3B. Funziona localmente sul Mac mini equipaggiato sul robot. Condivide il motore del servizio modello con il generatore di azioni e può funzionare senza la necessità di una connessione Internet. Il sistema può anche scegliere di richiamare il modello cloud tramite API per ottenere capacità di ragionamento e pianificazione più forti.
Questo livello deve elaborare le informazioni fuzzy nelle istruzioni e organizzare le azioni in base all'ambiente. Ad esempio, "sedersi" non ha un obiettivo chiaramente specificato e richiede che il robot determini dove sedersi dalla scena di fronte a lui; "sedersi su una sedia" può essere eseguito direttamente quando il percorso è libero, ma se c'è un tavolo che blocca la strada, è necessario suddividerlo in sottoattività continue come sporgersi, avvicinarsi alla sedia e sedersi. Il modulo di orchestrazione delle attività osserva continuamente l'ambiente attraverso il video dalla prospettiva del robot, determina se l'azione corrente ha avuto successo e porta avanti il piano o riprova di conseguenza, inviando ogni volta una sottoattività chiara al generatore di azioni.
Il livello di generazione dell'azione al centro utilizza un altro modello Qianwen Qwen3.5-2B. Il gruppo di ricerca lo utilizza come codificatore per il congelamento dei parametri e collabora con il decoder DiT responsabile della generazione di azioni per pianificare i movimenti dell'intero corpo per circa 5 secondi in futuro sulla base delle immagini viste dal robot e dell'attuale sottoattività. Questo livello viene ripianificato circa tre volte al secondo, consentendo il continuo aggiornamento del piano d'azione man mano che l'ambiente cambia.
Il livello inferiore è un tracker di azioni addestrato attraverso l'apprendimento per rinforzo, la distillazione delle politiche e altri passaggi. Funziona a una frequenza di 50 volte al secondo, combina immagini di profondità e stato del robot e converte i piani d'azione in istruzioni di controllo congiunto.
I tre livelli sono rispettivamente responsabili della disposizione dei compiti, della pianificazione delle azioni e del controllo del corpo e completano in modo collaborativo il processo dalla comprensione delle istruzioni all'esecuzione delle azioni.
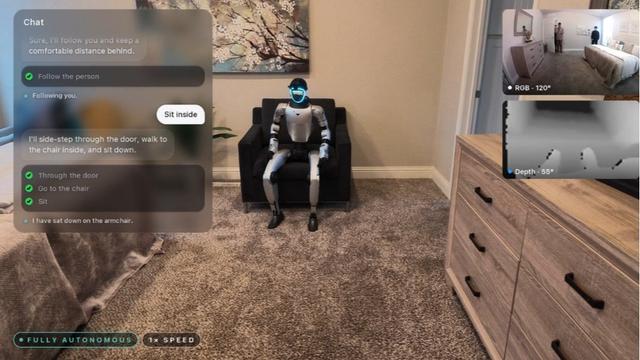
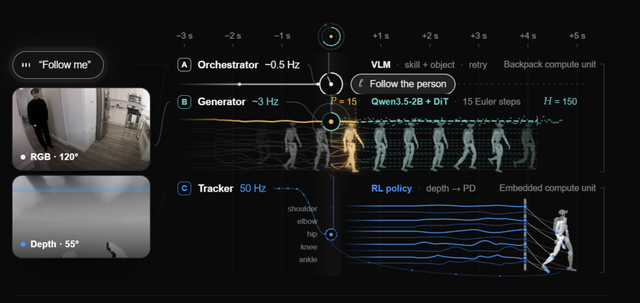
L'architettura di controllo a tre livelli di HALO: il modello del linguaggio visivo è responsabile dell'orchestrazione delle attività, il modulo di generazione pianifica i movimenti dell'intero corpo e il tracker delle azioni addestrato mediante l'apprendimento per rinforzo esegue il controllo congiunto. Fonte immagine: mosaico di screenshot dalla pagina del progetto HALO
Secondo lo studio, il team di ricerca ha condotto 360 test con attività singole in 6 ambienti reali senza pre-scansione o mappatura, con un tasso di successo medio del 91%. In un altro ambiente reale, sono stati condotti 10 test su tre attività combinate e il tasso medio di successo è stato del 70%. Tra questi, il tasso di successo della combinazione "sporgersi oltre l'ostacolo - camminare verso il bersaglio - spingere la scatola" è del 50%.
Il modo in cui i robot ottengono i dati necessari per completare queste attività è al centro di questa ricerca. Il gruppo di ricerca ha sintetizzato circa 300 ore di dati di addestramento primari in 1.000 ambienti domestici simulati generati dal programma per abbinare "ciò che ha visto il robot", "quali istruzioni ha ricevuto" e "come muoversi".
Nello specifico, il sistema prima genera azioni, poi le inserisce nella stanza virtuale e infine genera immagini dal punto di vista del robot. La pagina del progetto prende come esempio "Siediti su una poltrona", dividendolo in segmenti come camminare in avanti, girarsi e sedersi. Il modello di generazione delle azioni genera sequenze di azioni basate su istruzioni di testo, punti di passaggio e posture chiave. Le azioni vengono poi vagliate attraverso controlli geometrici per ridurre problematiche quali lo scivolamento del piede e la penetrazione del corpo nel terreno.
Quindi, il sistema organizza le azioni nella stanza generata dal programma, controlla la relazione di posizione tra il robot e i mobili, cerca un piano di posizionamento privo di collisioni e quindi utilizza strumenti di simulazione per riprodurre ciò che vede il robot quando esegue l'azione. Durante l'allenamento, verranno modificate anche condizioni quali illuminazione, tonalità di colore e sfocatura dell'immagine per rendere l'input visivo più diversificato. In questo modo, lo stesso processo può generare dati di supporto tra cui istruzioni, immagini visive e movimenti di tutto il corpo.
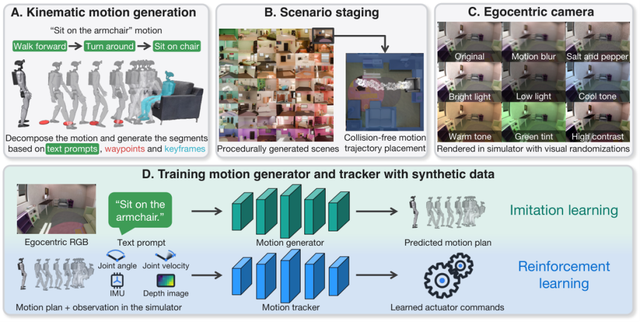
Generazione di dati sintetici e processo di addestramento di HALO: prima genera una traiettoria di azione, inseriscila nella scena virtuale, quindi esegue il rendering dell'immagine dalla prospettiva del robot per formare dati di addestramento di supporto per addestrare il generatore di azioni e il tracker di azioni. Fonte immagine: carta HALO
Secondo i rapporti, il team di ricerca ha utilizzato 250 GPU NVIDIA H100 e ha impiegato circa 48 ore per sintetizzare i principali dati di allenamento. Il generatore di azioni viene addestrato tramite l'apprendimento per imitazione, utilizzando 64 B200; l'action tracker viene addestrato attraverso l'apprendimento per rinforzo, la distillazione delle politiche e altri passaggi, utilizzando 4 H100.
Va sottolineato che i dati generati dalla simulazione non eliminano completamente la partecipazione umana. Il team ha affermato che le nuove attività fisiche richiedono ancora la scrittura manuale di parole immediate e la progettazione di fotogrammi chiave dell'azione, e alcune azioni utilizzano anche video umani o materiali di motion capture.
Il gruppo di ricerca ha inoltre sottolineato che attualmente i robot si affidano principalmente alla percezione visiva ed è difficile percepire direttamente le situazioni di contatto; quando gli oggetti escono dal campo visivo della telecamera o vengono occlusi, l'esecuzione delle attività che coinvolgono più contatti diminuirà. L'aggiunta della percezione tattile è una delle direzioni per i successivi miglioramenti.
Commenti